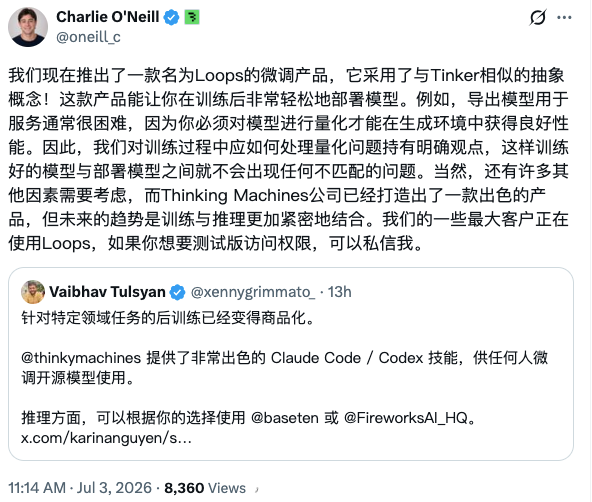
7月3日消息,前Google DeepMind 后训练团队成员 Vaibhav Tulsyan 公开表示"面向垂直任务的后训练已经商品化",随手推荐 Tinker 和 Baseten 作为训练与推理工具。
AI 推理平台 Baseten 于 5 月 8 日发布训练 SDK Loops(早期访问),直接兼容 Thinking Machines Lab 的 Tinker API。开发者改动一行 import 语句即可将 Tinker 训练脚本迁移至 Baseten 运行,训练完成后可一键将模型部署到 Baseten 推理基础设施。Baseten 6 月 22 日刚完成 15 亿美元 Series F 融资,估值 130 亿美元,日均处理超过 10 亿次推理调用。
一家以推理起家的公司反向切入训练,发出的信号是后训练基础设施的竞争正在从"怎么训"延伸到"训完怎么直接上线"。Loops 仍处于早期访问阶段,目前仅支持 Qwen3.5/3.6 和 Kimi K2.6,模型覆盖范围有限。 Loops 兼容 Tinker API,核心差异在训练到推理的闭环
Loops 使用与 Tinker 相同的低级原语:forward_backward、optim_step 和 sample。Baseten 官方文档提供了 Tinker 兼容指南,安装时加上 [tinker] 扩展并 import tinker,即可运行现有 Tinker 脚本。已在 Tinker 上积累的训练代码和 RL 工作流可以低成本迁移。
与 Tinker 的核心差异在推理侧。Tinker 的设计边界止于训练:开发者下载权重后自行部署。Loops 将推理视为训练的一等公民,最后一步梯度更新结束后,模型即可通过一条命令部署为 Baseten Dedicated Inference 的生产端点。Baseten 在训练阶段即执行量化处理,官方强调训练模型与部署模型之间"零偏差"(zero mismatch)。这个设计针对的是后训练最常见的工程痛点:团队手动合并 LoRA、跨格式量化、反复调试后才能上线。
在训练能力上,Loops 支持 131K 以上序列长度的 SFT 和 RL,提供异步 RL 原语,训练器与采样器独立扩缩容,权重同步在后台完成。早期合作伙伴包括法律 AI 公司 Harvey 和医疗 AI 公司 OpenEvidence。
Tinker 先发定义了 API 标准,Baseten 选择兼容而非另起炉灶
Tinker 由前 OpenAI CTO Mira Murati 创办的 Thinking Machines Lab 于 2025 年 10 月发布,目前已全面开放(2025 年底取消候补名单)。Thinking Machines Lab 在 2025 年 7 月完成 20 亿美元种子轮融资,估值 120 亿美元,由 Andreessen Horowitz 领投,Nvidia、AMD、Cisco 等参投。据 Bloomberg 报道,该公司随后寻求以 500 亿美元估值进行新一轮融资,但谈判在 2026 年 1 月破裂,当前估值仍为 120 亿美元。
Tinker 的定位是后训练 API:研究者在本地 CPU 机器上用 Python 编写训练逻辑,Tinker 负责分布式 GPU 集群的调度、资源分配和故障恢复。Tinker 使用 LoRA 微调,支持从 1B 到 1T 以上参数的模型。Andrej Karpathy 曾在 X 上评价 Tinker 的设计取舍"更聪明地切分了后训练的复杂性"。据 VentureBeat 报道,Tinker 目前已扩展到支持更大的推理模型和视觉语言系统,并兼容 OpenAI API 格式的推理。
Baseten 选择兼容 Tinker API 的策略清晰:Tinker 已成为后训练领域事实上的 API 标准之一,拥有已有用户群和代码资产。兼容意味着 Baseten 不需要说服开发者学习新框架,只需展示从训练到部署的闭环优势。
后训练商品化对推理平台和训练平台意味着不同的事
DeepMind 后训练团队成员在公开帖子中随手推荐第三方后训练工具,本身就是后训练商品化的直接证据。当 SFT 和 RL 的工程复杂性被 Tinker 和 Loops 封装之后,竞争焦点从"能不能训"转向"训完怎么最快上线、上线后推理成本是否可控"。
这个转移对 Baseten 有利。其 15 亿美元 Series F 由 Altimeter Capital、Conviction 和 Spark Capital 领投,18 个月内完成四轮融资,累计超过 20 亿美元。官方披露收入同比增长 20 倍,推理量增长 40 倍,87 个集群覆盖 18 个云环境,客户包括 Cursor、Lovable 和 Mercor。对于一家已拥有大规模推理基础设施的公司,向上游延伸到训练的边际成本远低于从零搭建,客户一旦在同一平台完成训练和部署,切换成本也随之上升。 对 Thinking Machines Lab 而言,Baseten 的兼容策略既确认了 Tinker 的市场地位,也挑战了它的商业模式。Tinker 目前的模式是管理训练侧基础设施,用户训练完后自行下载权重部署。如果越来越多用户选择在兼容 Tinker API 的 Baseten 上训练并直接部署,Tinker 的角色可能被压缩为"API 标准的定义者"而非"平台的拥有者"。Thinking Machines 的 500 亿美元估值融资未能完成,意味着它在商业化压力下需要找到比单纯训练更有防御性的价值环节。
接下来要看 Loops 的模型覆盖和 Tinker 是否向推理侧延伸
Loops 当前仅支持 Qwen3.5/3.6 和 Kimi K2.6 两个模型系列,DeepSeek、Nemotron、GLM 和 MiniMax 系列标注为"即将支持"。对于需要微调 DeepSeek V4 或 Llama 系列的开发者,Loops 目前不可用,Tinker 仍是选择。模型覆盖速度将直接影响 Loops 的早期采用率。 Thinking Machines 是否会向推理侧延伸是另一个关键变量。如果 Tinker 用户只能训练后自行部署,而 Loops 用户可以一键部署到 Baseten 推理栈,那么在后训练确实商品化的前提下,控制推理入口的一方将获得更强的客户粘性。Baseten 在推理侧已积累 87 个集群和日均 10 亿次推理调用的规模,这是 Thinking Machines 短期内难以复制的。后训练基础设施的竞争正从"谁的训练 API 更好用"转向"谁能把训练和推理做成闭环",而这个转向的速度取决于开发者是否真的把从训练到上线的衔接效率作为选型的首要标准。
 AI 速览