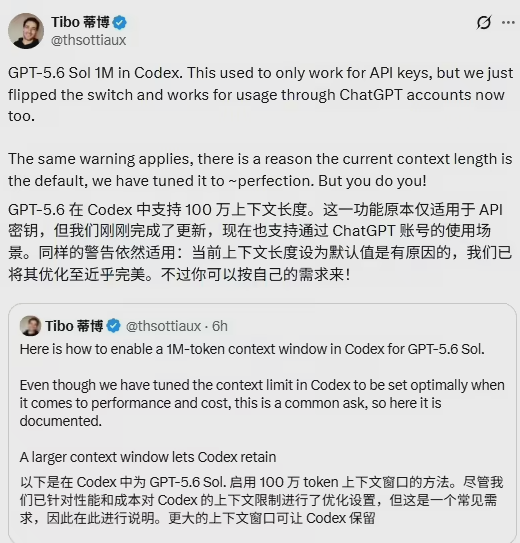
2026 年 8 月,OpenAI 官方团队确认,Codex 编程 Agent 已支持手动开启 GPT-5.6 Sol 的 100 万 Token 长上下文能力。该规格此前仅 API 端开放,客户端始终默认维持更低窗口,多数用户并未察觉这一隐藏能力。开启后可一次性加载完整代码仓库、全量项目文档与运行日志,大幅降低分段上传、手动拼接上下文的繁琐流程。本文从配置方案、成本性能、参数推荐三个维度,梳理可直接落地的实操指南。
一、两种开启方式,适配不同使用场景
1. 全局永久配置:适合长期重型开发
需要频繁处理大型项目的开发者,可通过修改配置文件永久生效。 操作步骤:找到 Codex 安装目录下的config.toml文件,在所有[section]分区标题之前,写入三行配置参数:
三行参数各司其职:指定默认调用模型为 GPT-5.6 Sol,设置理论上下文上限为 100 万 Token,同时设定 90 万 Token 为自动压缩阈值,达到阈值后自动精简旧会话内容,预留空间避免溢出。保存文件后重启 Codex 客户端,新建会话即可生效。
2. 单会话临时配置:兼顾成本与灵活性
仅偶尔处理超大型项目的用户,无需修改全局设置,可通过 CLI 命令为单次会话临时开启长窗口,退出后自动恢复默认配置。 执行命令如下:
该方案适合碎片化处理不同规模项目的场景,普通任务维持默认窗口控制成本,全量分析时临时解锁长上下文,按需分配算力开销。
二、长上下文的隐性代价:成本翻倍与性能衰减
长上下文并非越大越好,两项核心限制需要提前了解:
- 额度消耗大幅上升:窗口扩大后,每轮交互都会携带更多历史对话、工具调用与文件上下文,Token 消耗速度较默认设置翻倍不止,额度耗尽速度会明显加快。
- 长上下文性能衰减:评测数据显示,GPT-5.6 Sol 在 25.6 万 - 51.2 万 Token 区间的任务准确率可达 91.5%;当窗口拉升至 51.2 万 - 100 万区间后,准确率回落至 73.8%。也就是说,“装得下” 和 “用得好” 是两个概念,超长窗口下信息召回的精准度会有所下降。
三、日常最优解:512K 窗口兼顾效率与成本
综合性能、成本与覆盖场景,51.2 万(512K)Token 是更普适的日常配置,绝大多数大型代码项目都可完整覆盖,同时模型准确率处于高位,额度消耗也相对克制。 推荐配置参数如下:
百万级上下文更适合极端场景临时启用:比如几十万行代码的全仓库重构、跨数百文件的依赖关系审计、海量运行日志的全量溯源等。这类任务完成后,建议切回常规窗口,避免持续的额度浪费。
四、实操注意事项
- 配置修改后必须重启 Codex 客户端,且仅对新建会话生效,历史会话无法继承新的窗口设置;
- 自动压缩阈值建议预留 10% 左右的缓冲空间,避免上下文溢出导致会话中断;
- 单文件修改、简单功能开发等轻量任务,无需开启超长上下文,默认窗口即可满足需求,可显著降低调用成本。
整体而言,百万上下文为重型开发场景提供了更强的能力支撑,但并不适合全场景默认开启。根据项目规模匹配对应窗口大小,在开发效率与调用成本之间找到平衡,才能最大化发挥长上下文的价值。
 AI 速览