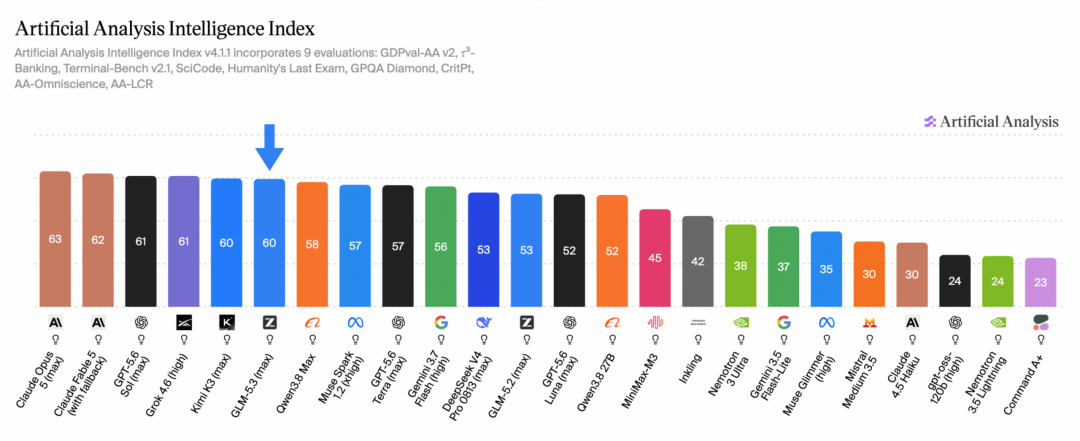
2026 年智谱 GLM-5.3 正式上线 API,凭借与 GLM-5.2 完全相同的 750B 总参数基座,仅通过后训练优化便在 AA 评测榜拿到 60 分,跻身全球前六梯队,成为同分数段参数规模最小的模型。
本次升级重点强化复杂编码、长程 Agent 任务与网络安全防御能力,且定价与上代保持一致,后续还将开源,被开发者称为高性价比的 “额度救星”。本文从性能定位、编码表现、安全能力与行业价值四个维度,拆解这款模型的真实实力。
一、性能定位:同基座后训练跃升 最小参数跻身头部阵营
在最新的 AA 智能指数榜单中,60 分以上的第一梯队共有 6 款模型,GLM-5.3 总参数约 750B,远低于同梯队的 Kimi K3(约 2.8T)、Grok 4.6(约 1.5T)、GPT-5.6 Sol(预估 1.99T)等产品,是头部阵营中参数体量最小的一款。 本次性能跃升并未更换基础基座,全部提升来自后训练优化,相当于一次控制变量的缩放实验,验证了 Scaling Law 并非只有堆参数一条路径。在 MoE 混合专家架构下,算力可以投向数据质量打磨、后训练对齐、专项能力强化等方向,同样能实现显著的性能提升。
对于用户而言,更小的参数规模意味着更低的推理成本,叠加维持不变的定价,综合性价比优势十分突出。
二、编码能力实测:长项目多轮稳定 细节完成度突出
本次测试摒弃了 “首屏可用即合格” 的浅度标准,重点验证多轮迭代中的上下文记忆与功能修复能力,覆盖从简单工具到复杂项目的全维度场景。
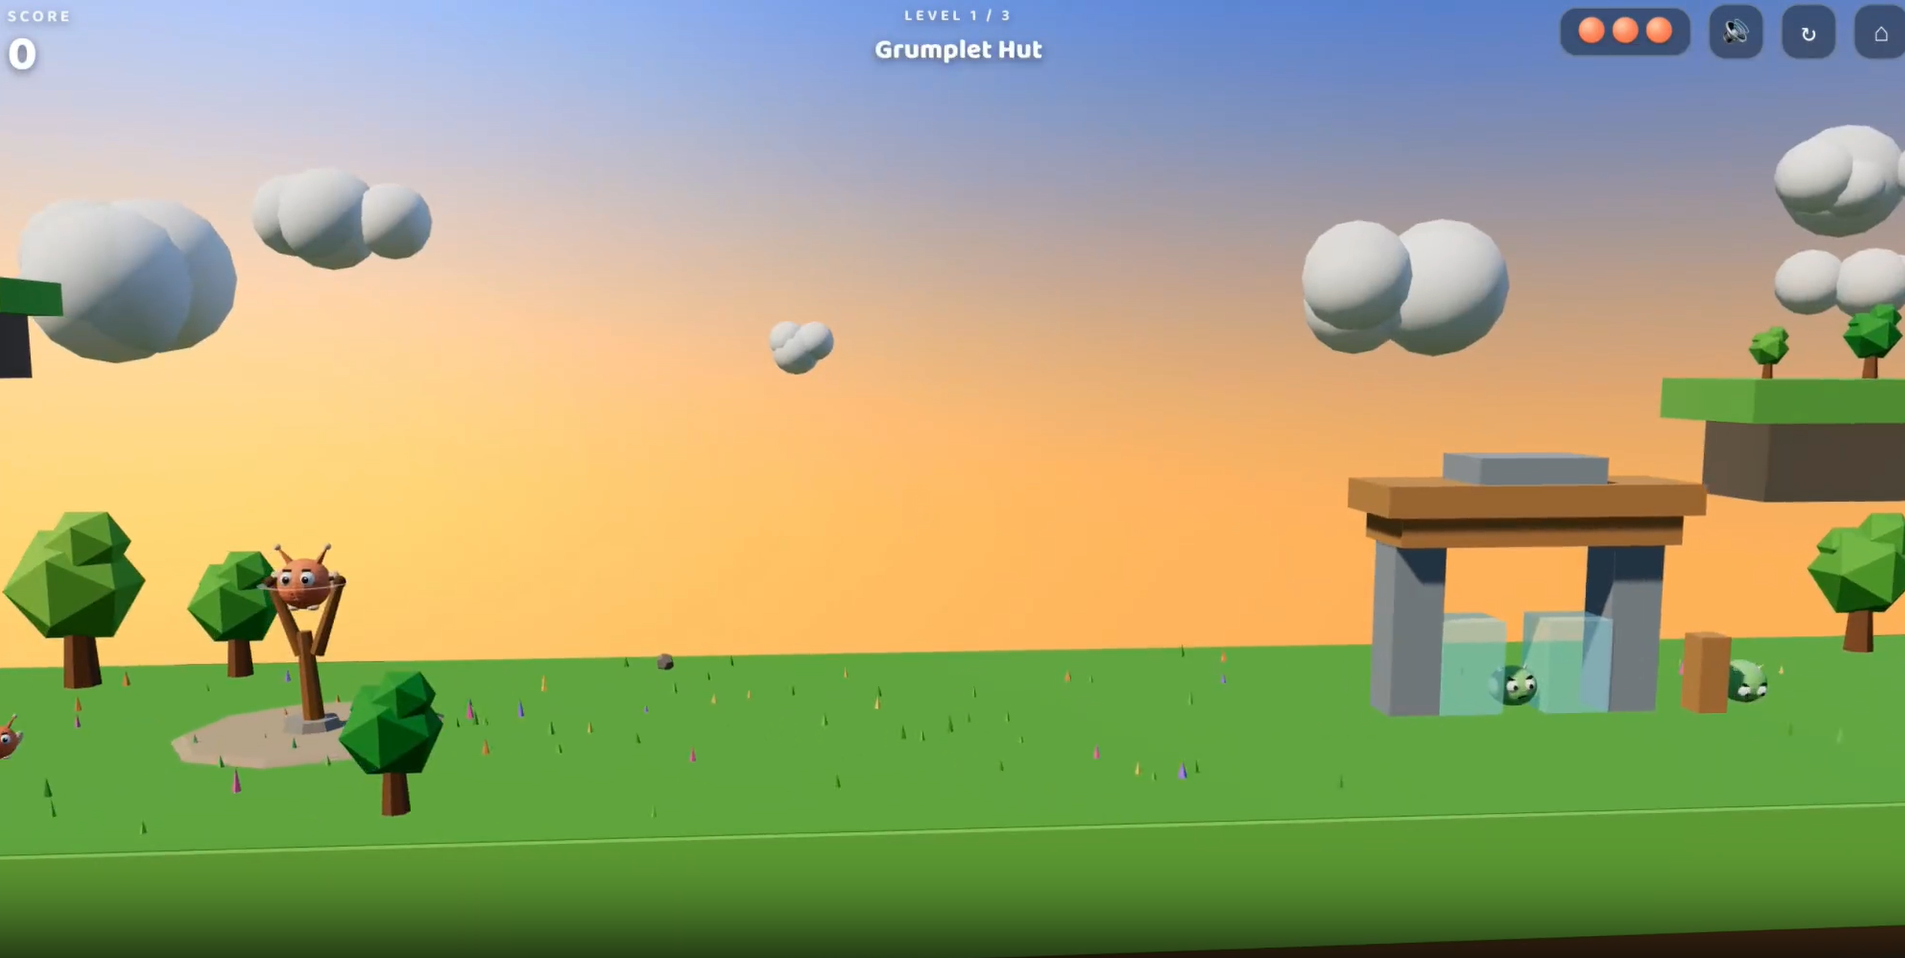
基础开发场景中,单句指令生成单向街交通模拟代码,生成速度比 DeepSeek V4 Pro 快约 2 倍,车辆启停、随机驶入逻辑稳定无崩坏;第二轮仅补充 UI 优化需求,核心逻辑未被破坏,还自动补充了夜间场景车灯、刹车尾灯等细节,质感从 Demo 级提升至成品级。 复杂项目场景中,2D 节奏跑酷、3D 版愤怒的小鸟这类带物理引擎的游戏项目,模型可一次性完成多关卡设计、碰撞反馈、音效匹配与镜头跟随,角色弹跳、物体爆破的手感还原度超出预期,且多轮修改不会偏离初始设计意图。
真实业务优化场景中,针对站点图片展示模式的重构,精准把握细节需求,完成资产切换、放大查看等功能升级,没有冗余的大刀阔斧式改动。
三、安全专项升级:源码级漏洞溯源 修复方案可落地
网络安全是 GLM-5.3 的核心升级方向之一。发布前团队联合安全团队累计排查出 2404 个漏洞,其中 1088 个为中高危,覆盖 Android、Windows、macOS 等多系统生态,最早可追溯至 40 年前的遗留问题。
实测以 Mac 端 Ice 菜单栏工具的源码排查为例,模型可直接追溯图标隐藏、状态恢复的底层逻辑,定位对私有 API 与模拟拖拽事件的依赖,同步匹配社区已知问题,输出包含现象、成因、代码位置、触发条件、临时恢复方案、代码修复方案的完整问题链,还能明确区分真实安全风险与兼容性设计缺陷。对比同类模型偏向 “推荐替代工具、修改系统配置” 的解决思路,GLM-5.3 更倾向从代码根源给出可落地的修复方案,更适配开发审计与安全排查场景。
四、行业价值:验证高效缩放路线 重构大模型成本模型
GLM-5.3 的最大行业意义,是打破了 “性能提升必须堆大基座” 的固有认知。在大模型普遍追求万亿参数的当下,它证明了 750B 规模的基座,通过高质量后训练也能逼近 2T 级模型的综合表现。
更小的激活参数意味着更低的推理成本,配合不变的定价,能显著降低开发者的日常使用成本。 这也为行业提供了新的缩放思路:Scaling 不应只盯着总参数量,全生命周期的算力分配优化同样重要。当基座达到一定规模后,将算力投入后训练、专项能力打磨、真实场景对齐,可能比盲目扩张参数有更高的投入产出比。
整体而言,GLM-5.3 凭借同基座的跨越式提升,坐稳了国产编码模型第一梯队的位置,也为大模型的高效进化提供了可参考的样本。对于日常重度依赖编码、Agent 开发、安全审计的开发者来说,它是兼顾能力与成本的优质选择。
 AI 速览