deepseek v4 pro和deepseek flash区别核心就在参数规模和使用定位上——V4-Pro是1.6万亿总参数、激活49B的旗舰款,主打复杂推理和高质量输出;V4-Flash是2840亿总参数、激活13B的轻量款,主打高并发和低成本。两者共用1M上下文和384K最大输出这套规格,但价格差了3倍,并发能力差了5倍,跑分表现也各有侧重,这篇文章把这几块拆开给你讲清楚。
一、参数规模:Pro比Flash大快6倍
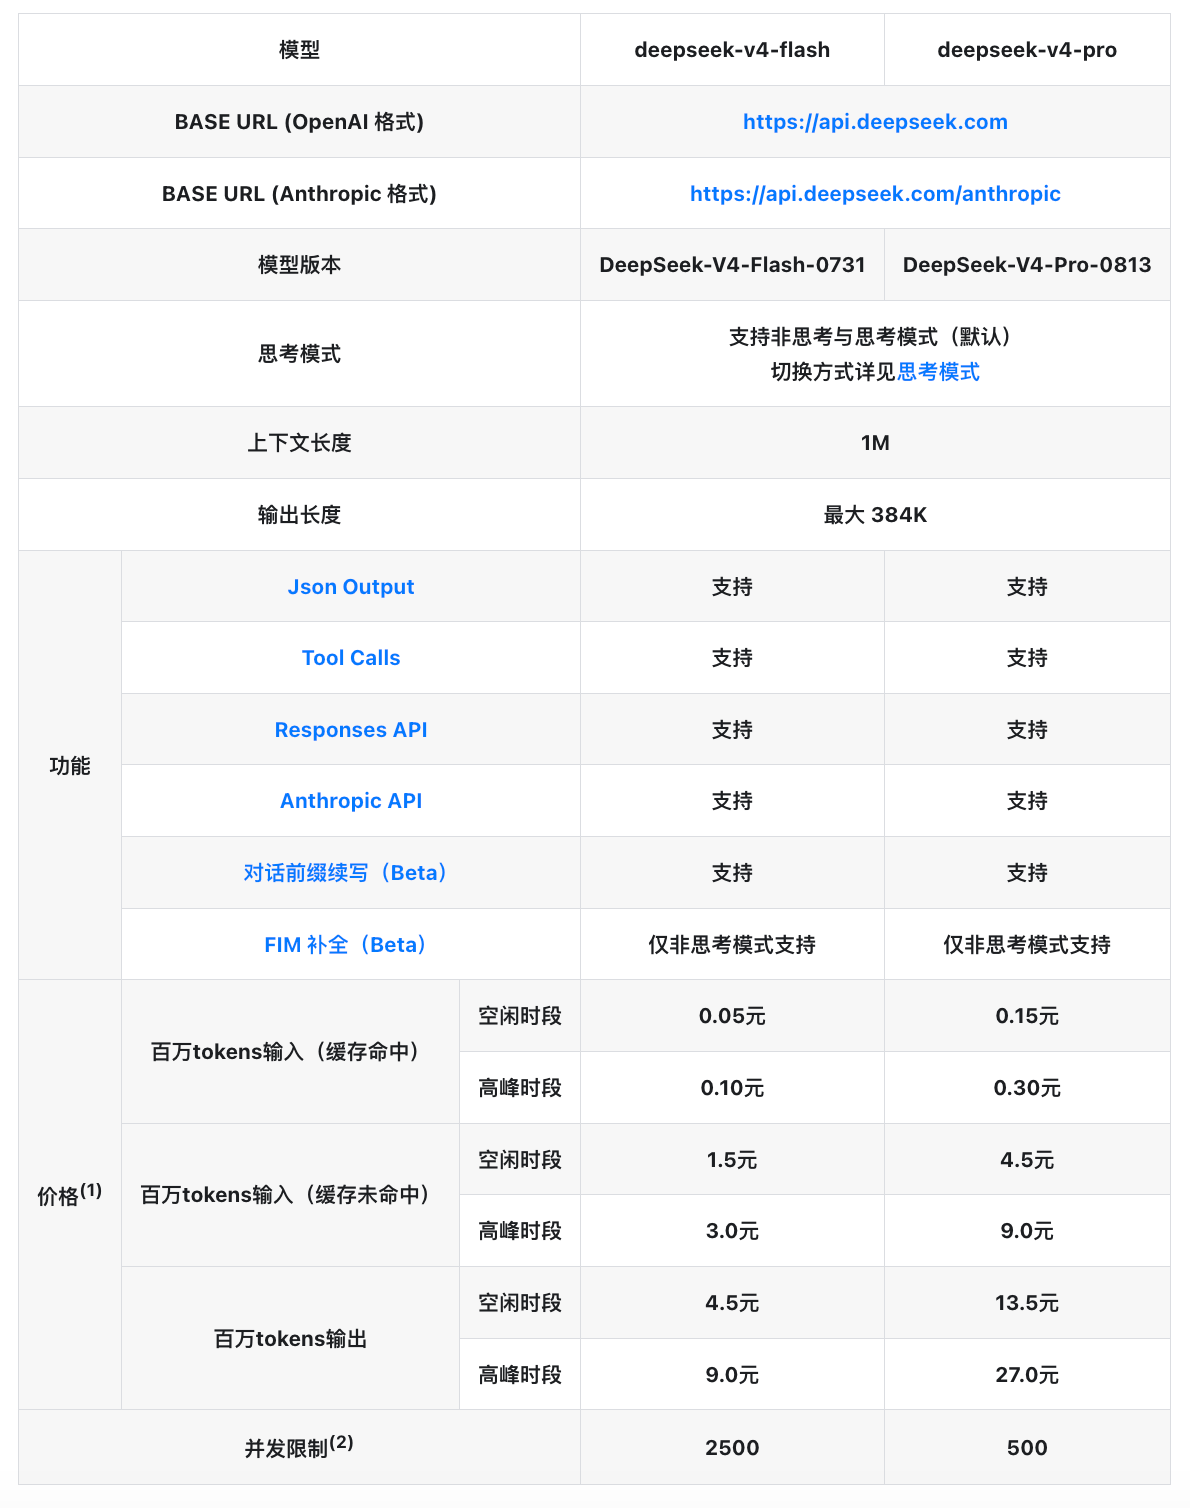
V4-Pro是1.6万亿总参数的MoE架构,单次推理激活49B参数;V4-Flash是2840亿总参数,激活13B参数。总参数量差了将近6倍,这直接决定了两个版本的推理成本和响应速度不在一个量级。要说明一点,两个版本共用同一套注意力机制架构(CSA压缩稀疏注意力加HCA重压缩注意力的混合方案),长上下文处理能力本质上是一样的,都能吃满1M token窗口,384K最大输出这两项规格也完全一致,差别更多体现在参数规模带来的推理深度和质量上,不是上下文能力的差距。
二、价格:Pro是Flash的3倍
2026年8月17日起,DeepSeek API执行峰谷定价机制,两个版本的最新价格是这样的(单位元/百万tokens): V4-Pro:
高峰时段(工作日9-12点、14-18点):缓存命中0.3元、缓存未命中9元、输出27元
闲时:缓存命中0.15元、缓存未命中4.5元、输出13.5元
V4-Flash:
高峰时段:缓存命中0.1元、缓存未命中3元、输出9元
闲时:缓存命中0.05元、缓存未命中1.5元、输出4.5元
不管高峰还是闲时,V4-Pro的输出价格都稳定是V4-Flash的3倍,缓存未命中输入价格也是同样的3倍比例关系。这个价差挺固定的,选哪个版本对预算的影响直接又好算。
三、并发限制:Flash比Pro高5倍
API并发能力上,V4-Pro上限是500路,V4-Flash是2500路,Flash的并发承载能力是Pro的5倍。这个差距对高吞吐场景(比如客服机器人、批量数据处理这类需要同时处理大量请求的应用)影响特别大,Flash在这类场景下明显更合适,不容易被并发天花板卡住导致请求排队或者报错。
四、跑分:不是Pro全面碾压Flash
这块值得展开说说。V4-Pro在竞技编程类测试上确实强,LiveCodeBench深度思考模式拿到93.5分排名第一,Codeforces评分3206,接近人类顶级程序员水平。但换到SWE-bench Pro这类更贴近真实工程场景的测试上,V4-Pro只拿到55.4分,这个分数反而低于同期一些竞品模型,说明它在"独立解题"类任务上很强,复杂工程修复类任务上的优势没那么突出。
V4-Flash这边2026年7月31日发布的正式版有个挺明显的转折,架构和参数跟预览版完全没变,纯靠后训练优化,Terminal-Bench 2.1从预览版一路涨到82.7分,DeepSWE更是从7.3分直接跳到54.4分,涨幅相当夸张,部分Agent编码基准上甚至反超了V4-Pro早期版本。这说明便宜的轻量版经过针对性调优,在特定任务上也能有超出预期的表现,不是价格贵就一定全面占优。
五、到底该选哪个
任务复杂度高、需要深度推理和高质量输出的场景(比如架构设计、复杂调试、竞技编程类任务),选V4-Pro更合适,贵但能力上限更高。日常批量处理、高并发场景、对成本敏感的应用(比如内容生成、客服问答、数据清洗),V4-Flash性价比更突出,价格只要Pro的三分之一,并发还高出5倍,跑起来更顺畅。
不管选哪个版本,把非实时任务(批量处理、离线分析)挪到晚上18点到次日9点这个闲时段跑,成本都能直接砍半,这个错峰思路对两个版本都适用,值得纳入你的调用规划。
deepseek v4 pro和deepseek flash区别说到底是参数规模、价格、并发这三块的权衡——Pro贵但推理深度和竞技编程能力更强,Flash便宜且并发吞吐量大,跑分上也不是简单的谁全面碾压谁。具体选哪个还是得看你的任务类型和预算,拿自己的真实场景测一测,比只看参数表数字更靠谱。
 AI 速览