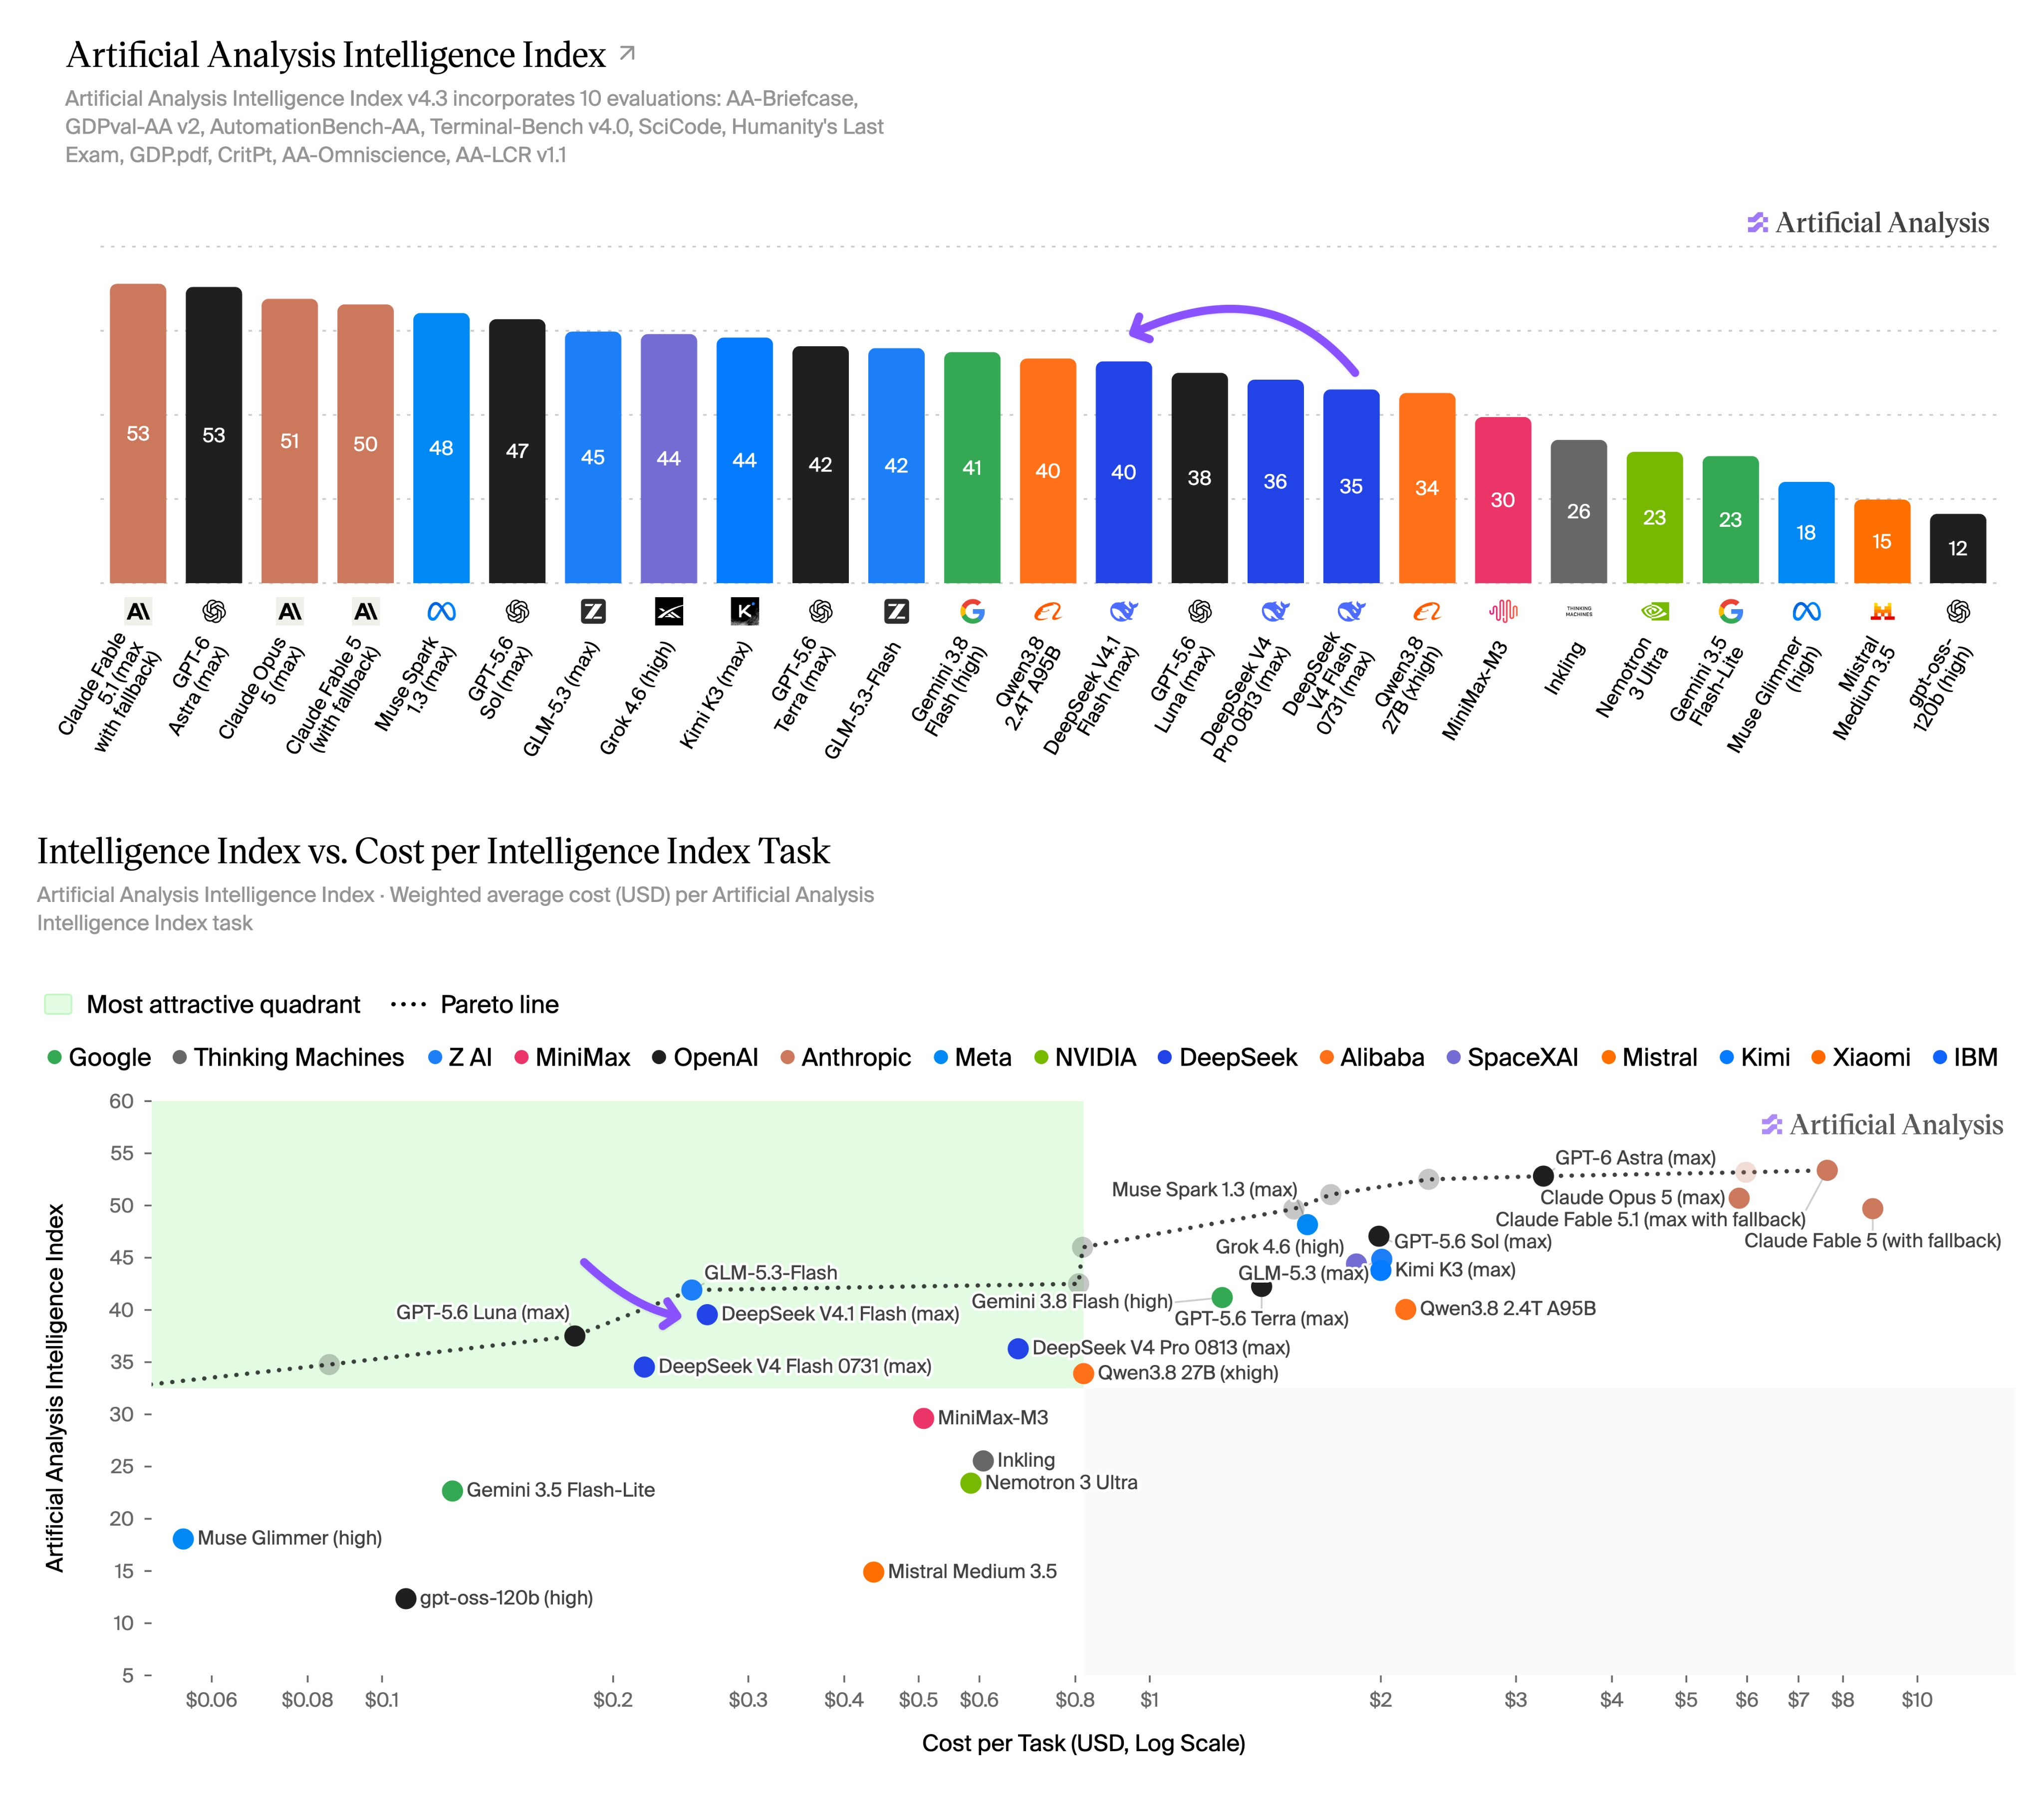
9月11日消息,据 Artificial Analysis 的评测数据,DeepSeek V4.1 Flash新模型智能指数(Intelligence Index)达到 40 分,超过 V4 Pro 0813 的 36 分,成为 DeepSeek 当前得分最高的模型。官方 API 定价为每百万输入 token 0.30 美元、输出 1.20 美元,评测口径下单任务成本 0.27 美元,约为 Pro 的 40%。 旗舰换位靠什么:智能体与长上下文
V4.1 Flash 的得分跃升来自智能体能力和长上下文推理。Terminal-Bench v4.0 得分 27%,是 V4.0 Flash(13%)的两倍多。GDPval-AA v2 评分 1632 Elo,较上代提升 164 点,超过 Kimi K3 的 1584。在覆盖 39 款 SaaS 应用、657 项任务的 AutomationBench-AA 中,V4.1 Flash 以 69% 居首,与 GPT-6 Astra 持平,高于 Grok 4.6(67%)、GLM-5.3(62%)和 V4 Pro 0813(57%)。长上下文方面,AA-LCR v1.1 得分 84%,与 GPT-5.6 Sol、Gemini 3.8 Flash 持平,上下文窗口为 100 万 token。 模型总参数量 7630 亿,骨干为 5520 亿参数的 MoE,采用新的因果编码器-解码器架构,输入时激活 80 亿参数,输出时激活 160 亿参数。输入模态为文本和图像,许可证为 MIT。这些官方口径的规格意味着:它的旗舰能力不是靠堆参数换来的。
单任务 0.27 美元,比 GLM-5.3 和 Kimi K3 便宜约 7 倍
按 Artificial Analysis 的测算,V4.1 Flash 完成一项智能指数任务的平均成本为 0.27 美元,GLM-5.3 为 2.01 美元,Kimi K3 为 2.00 美元,V4 Pro 0813 为 0.67 美元。DeepSeek 公布的官方 API 价格比 0731 低 20%,比 Pro 0813 低约 4 倍;缓存输入每百万 token 仅 0.006 美元,相当于 98% 的折扣,非高峰时段输入、缓存和输出还可再降 50%。
这些数字指向一个变化:DeepSeek 产品线里,旗舰能力第一次不由最大的模型承担。对 API 用户来说,这是好消息——旗舰档的智能体能力按 Flash 档价格开放;对 GLM、Kimi 所在的同档开源模型来说,7 倍左右的成本差会传导到选型决策。
代价写在输出长度里
V4.1 Flash 是 Artificial Analysis 评测过的模型中输出最冗长的之一,平均每项智能指数任务生成 89k token,比 V4 Pro 0813(55k)多 62%,也高于 GLM-5.3(71k)、Fable 5.1(78k)和 Claude Opus 5(73k)。冗长没有抵消价格优势——输出 token 多 62% 的同时单价低约 4 倍,净成本远低于 Pro——但它会影响响应时延和可读性,长文档和代码库场景需要把这一点计入。性能与成本的组合因此略低于帕累托最优前沿,这是评测方留下的明确限定。 到这里,DeepSeek 的价格策略又多了一层可观察的含义:用架构效率换价格空间,用输出长度换分数上限。这个交换是否划算,取决于使用者的任务对冗长的容忍度,账单会给出答案。
 AI 速览