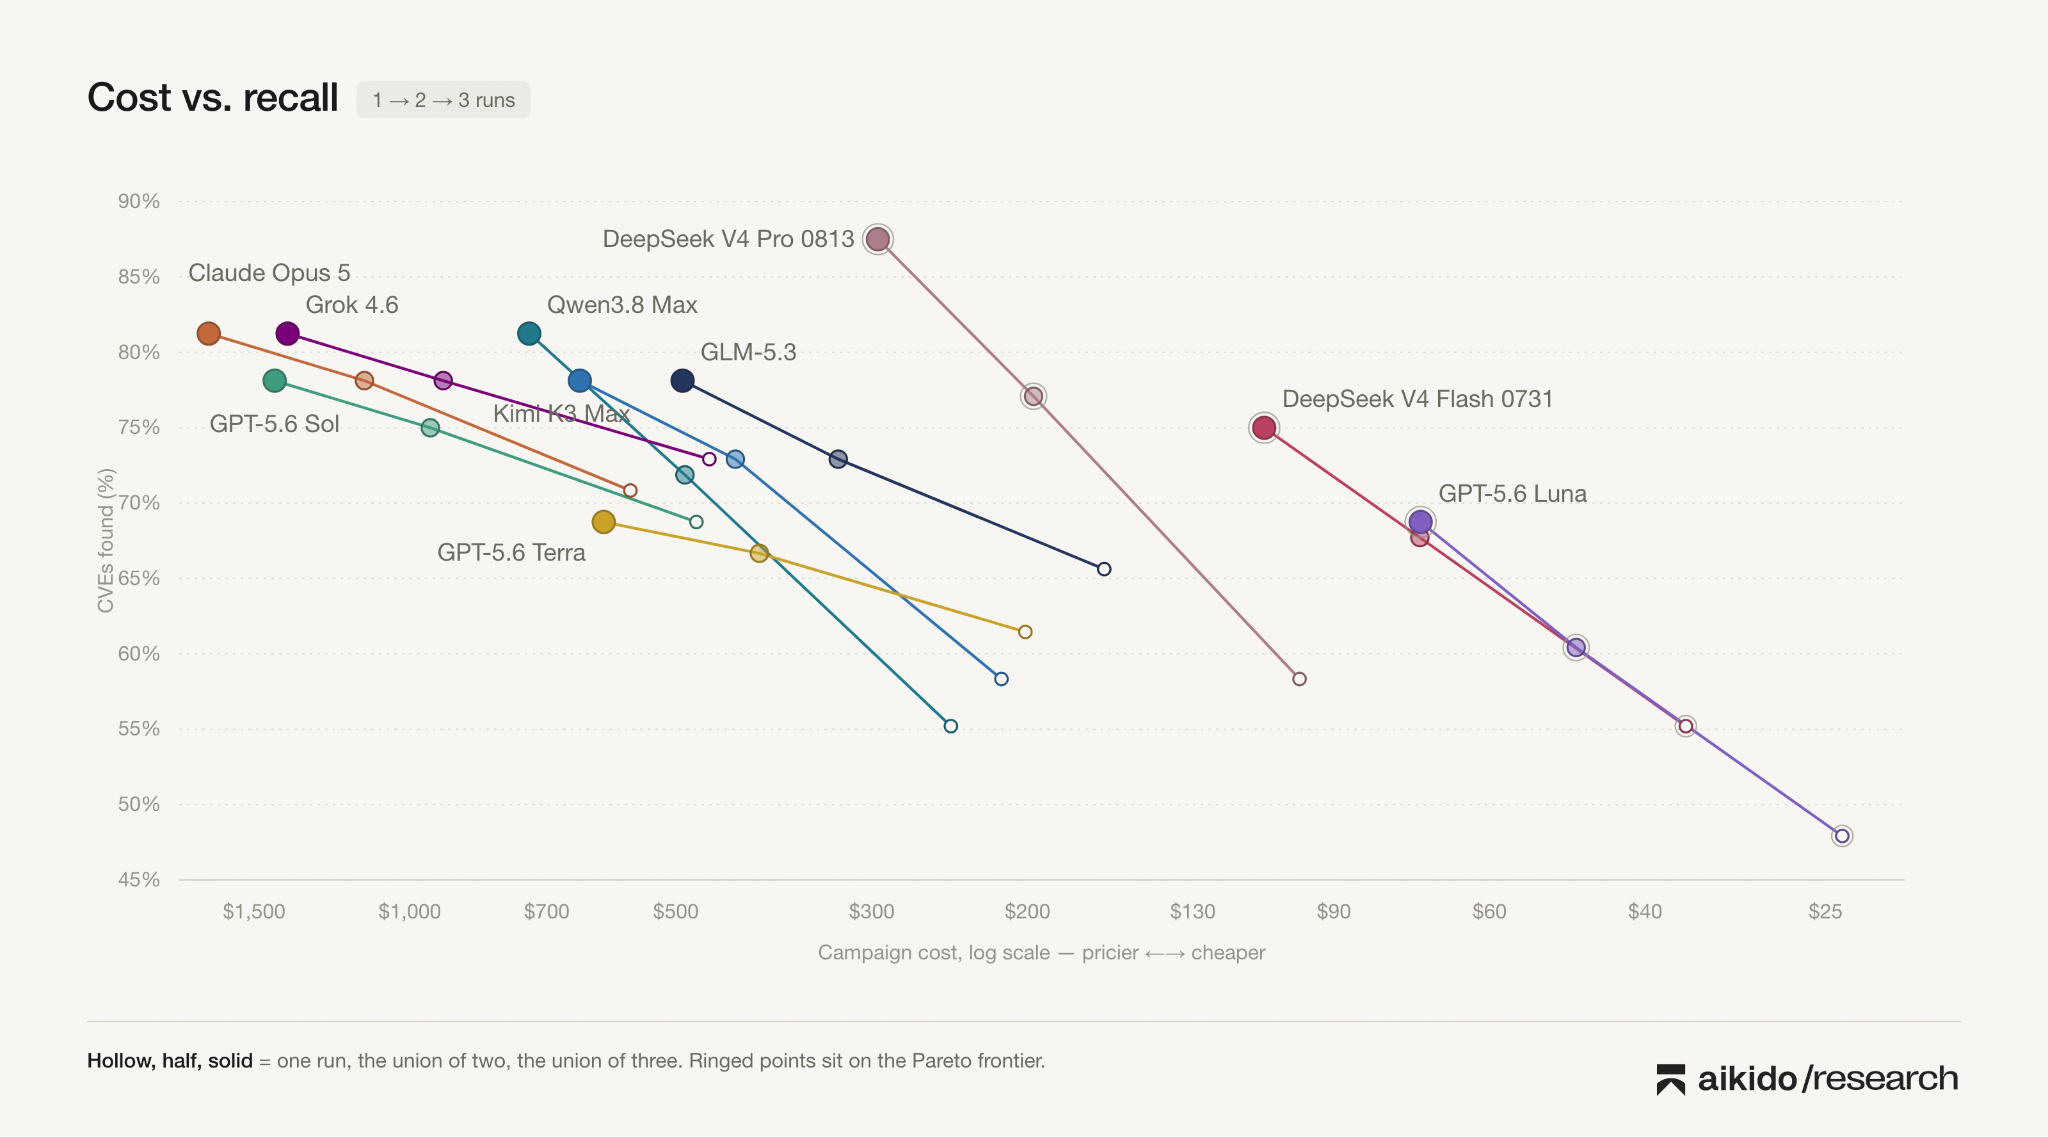
哪个 AI 模型最擅长发现代码漏洞?2026 年 8 月,安全公司 Aikido 用 32 个全新 CVE 对 10 个主流大模型做了一次大规模实测:消耗 117 亿 token,结论是 DeepSeek V4 Pro 召回率最高,开源模型在漏洞发现上首次整体压过了公开前沿闭源模型,而最贵的模型未必是最好的选择。 测试怎么做:32 个新 CVE、96 次运行、断网环境
这次基准不是跑代码生成或数学题,而是让模型像安全工程师一样做事:从真实仓库源码中"重新发现"漏洞。Aikido 从近期披露的 CVE 中挑选了 32 个,刻意选训练数据中大概率没见过的样本,测试的是漏洞推理能力而非记忆能力。
每个模型跑完全部 32 个案例 3 次,共 96 次运行,智能体最多执行 30 步,全程断网。用例、提示词、工具和评估标准全部冻结,保证不同模型之间的可比性。衡量指标有两个:召回率(找到多少漏洞)和精确率(找到的结果里有多少被确认有效)。
核心结论:开源模型首次压过公开前沿模型
最大的变化来自梯队格局。上一轮基准中开源模型还在追赶,这一次 DeepSeek、GLM、Qwen 和 Kimi 在漏洞召回上全面进入前沿水平: - DeepSeek V4 Pro 0813:3 次运行合并召回 28/32,全场最高
- GLM-5.3:25/32,仅落后 Opus 5 一个 CVE,成本便宜 69.8%
- Qwen3.8-Max:26/32,追平 Opus 5 与 Grok 4.6
- Kimi K3:25/32,开源模型中精确率最高(92.3%)
- Opus 5:26/32,单次最佳成绩 25/32
- Grok 4.6:26/32,三次运行全部命中的漏洞最多(21 个),最稳定
Aikido 强调,这些开源模型必须在正确的系统框架(harness)下运行才能达到这个水平,直接替换闭源模型并不现实。测试也没有覆盖 Mythos、GPT-5.6 Daybreak 这一级别的未公开模型。
成本对比:三次便宜运行打败一次最贵运行
价格是这次测试最反直觉的部分。DeepSeek V4 Pro 跑 3 次花费约 295 美元,找回 28 个漏洞;而 Opus 5、Grok 4.6、Sol 的单次运行就要 450 至 590 美元,最多只找回 26 个。DeepSeek V4 Flash 跑 3 次只要 108 美元,找回 24 个漏洞,追平 Grok 4.6 的最佳单次成绩,价格不到四分之一。
GLM-5.3 的成本表现同样突出:每发现一个漏洞约 19.65 美元,明显低于 Sol、Opus 和 Grok。它的预发布版本在性价比上甚至压过了 GPT-5.6 Terra。
为什么多跑几次比用最贵模型更有效
大模型的输出有随机性:同一个任务开三个新会话,可能得到三种不同的解决路径。对追求稳定输出的场景这是缺点,但漏洞挖掘本质是搜索问题,搜索恰恰能从这种方差中受益。
数据印证了这一点。DeepSeek V4 Pro 第一轮只找到 17 个漏洞,但第二轮和第三轮补齐了遗漏,合并后达到 28 个。Qwen 从第一轮的 19 个涨到合并后 26 个,Kimi 从 17 涨到 25。相反,Grok 每次找到的漏洞高度重合,重复运行带来的提升最小。
另一个容易被忽视的代价:便宜模型探索更激进,产出更多候选结果,也意味着更多假阳性需要后续流程过滤。测试中 32 个漏洞有 17 个所有模型都能找到,1 个所有模型都失败,其余 14 个才是真正拉开差距的地方。
选型建议:别问哪个模型最强,问它该放在哪一环
Aikido 的最终建议是放弃"哪个模型最好"的问题。更实际的思路是:让便宜的模型先广撒网,让贵的模型复核关键结论,用多次运行合并召回,再靠管道过滤假阳性。开源模型追赶的速度正在压缩前沿闭源模型的价格溢价,但 harness 工程依然是决定实际效果的关键变量。
 AI 速览