2026 年 8 月 21 日,DeepSeek 正式上线旗下首款多模态 API 模型deepseek-v4-flash-vision-exp,结束了此前纯文本模型的 “无视觉” 状态。该模型为实验版本,仅支持图像理解能力,不具备图片生成功能,纯文本表现与 V4-Flash 正式版持平,多模态 Agent 性能实现大幅跃升。搭配同步更新的 DeepSeek Harness 开发框架,开发者可快速搭建带视觉感知的 Agent 应用,极致的定价策略更是直接将多模态调用成本打到了行业新低。 一、能力定位:文本能力无衰减 多模态 Agent 性能逼近第一梯队
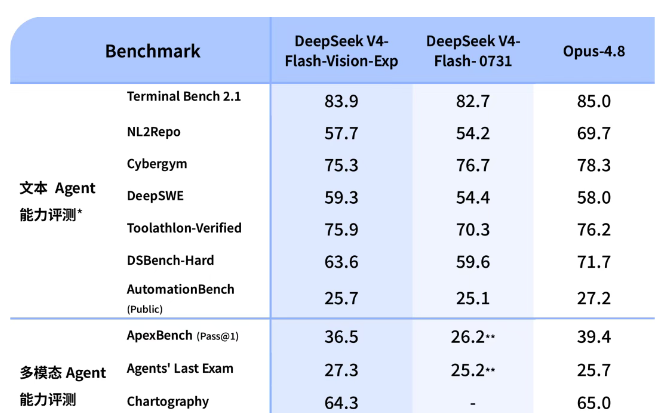
不同于部分模型 “加视觉就稀释文本能力” 的表现,V4-Flash-Vision-Exp 完整保留了原版本的 Agent 推理、世界知识等全部文本能力,基础识图表现与此前内测的网页版基本一致。
核心提升集中在多模态 Agent 场景:在主流多模态 Agent 基准测试中,该模型相较纯文本 V4-Flash 实现了性能跃升,综合表现已接近 Opus-4.8 水平。
官方展示的落地 Demo 覆盖多元办公与开发场景:可基于需求生成符合视觉调性的商务 PPT,对官网界面完成玻璃拟态风格的 UI 二次创作,还能生成黏土风格的前端交互页面,兼顾专业输出与审美表现,验证了视觉理解落地真实场景的可行性。
二、定价优势:单图封顶 384Token 成本仅为竞品 1/20
定价是本次更新最具冲击力的亮点,DeepSeek 沿用纯文本模型的计费标准,未对多模态能力单独加价。图片会转换为 Token 计入输入量,单张图片最高消耗 384Token,设置了明确的封顶值。
按高峰时段、缓存未命中的最高成本计算,单张图片调用成本约 0.12 分钱,换算下来 1 分钱可查看约 9 张图片,千张图输入成本仅 1 元出头。对比同类型头部模型,单图成本差距最高接近 20 倍。量级差直接改变了使用逻辑:高价模式下开发者需要权衡 “是否有必要调用视觉”,而低成本下 Agent 可每执行一步就截屏校验,通过持续的视觉反馈提升任务完成率,真正让视觉能力成为 Agent 的常规配置而非奢侈功能。
三、工具链同步打通:Harness 原生适配 开箱即用无额外开发
模型与开发工具同步上线是 DeepSeek 的一贯节奏,本次多模态模型发布当天,DeepSeek Harness 同步推送 0.1.1 版本,原生支持首款第一方多模态模型,开发者无需额外修改适配代码,切换模型名称即可启用视觉能力。
图片输入提供了 base64 内联、外部 URL、Files API 三种接入方式,其中 Files API 同步免费开放,图片单次上传后可通过 ID 重复引用,无需重复计费,进一步降低了设计稿、报表截图等高频复用场景的调用成本。从运行框架到模型能力的全链路打通,让开发者可以快速搭建具备视觉感知的完整 Agent 工作流。
四、实测验证:覆盖开发与基础识图 尚存通用通病
实测验证了模型的落地表现:Agent 场景下,可自主下载 Blender 软件,对照参考图完成 3D 建模,过程中多轮截图自主返工,最终成品的光影质感达到可用标准;也能基于需求生成 Canvas 宇宙风格交互 Demo,实现点击生成 UFO 的动态效果。
基础识图方面,人物识别、场景理解响应迅速,支持联网检索图片对应信息,但也存在当前多模态模型的通病,比如数手指类精细计数任务准确率不足。
整体而言,这款从 4 月启动灰测、历时四个月走到 API 开放的多模态模型,补上了 DeepSeek 生态的关键视觉短板。对于前端开发、UI 还原、3D 建模等依赖视觉反馈的 Agent 任务,视觉能力的加入大幅提升了迭代效率,配合极致的定价与成熟的工具链,成为当前高性价比的多模态开发选择。
 AI 速览