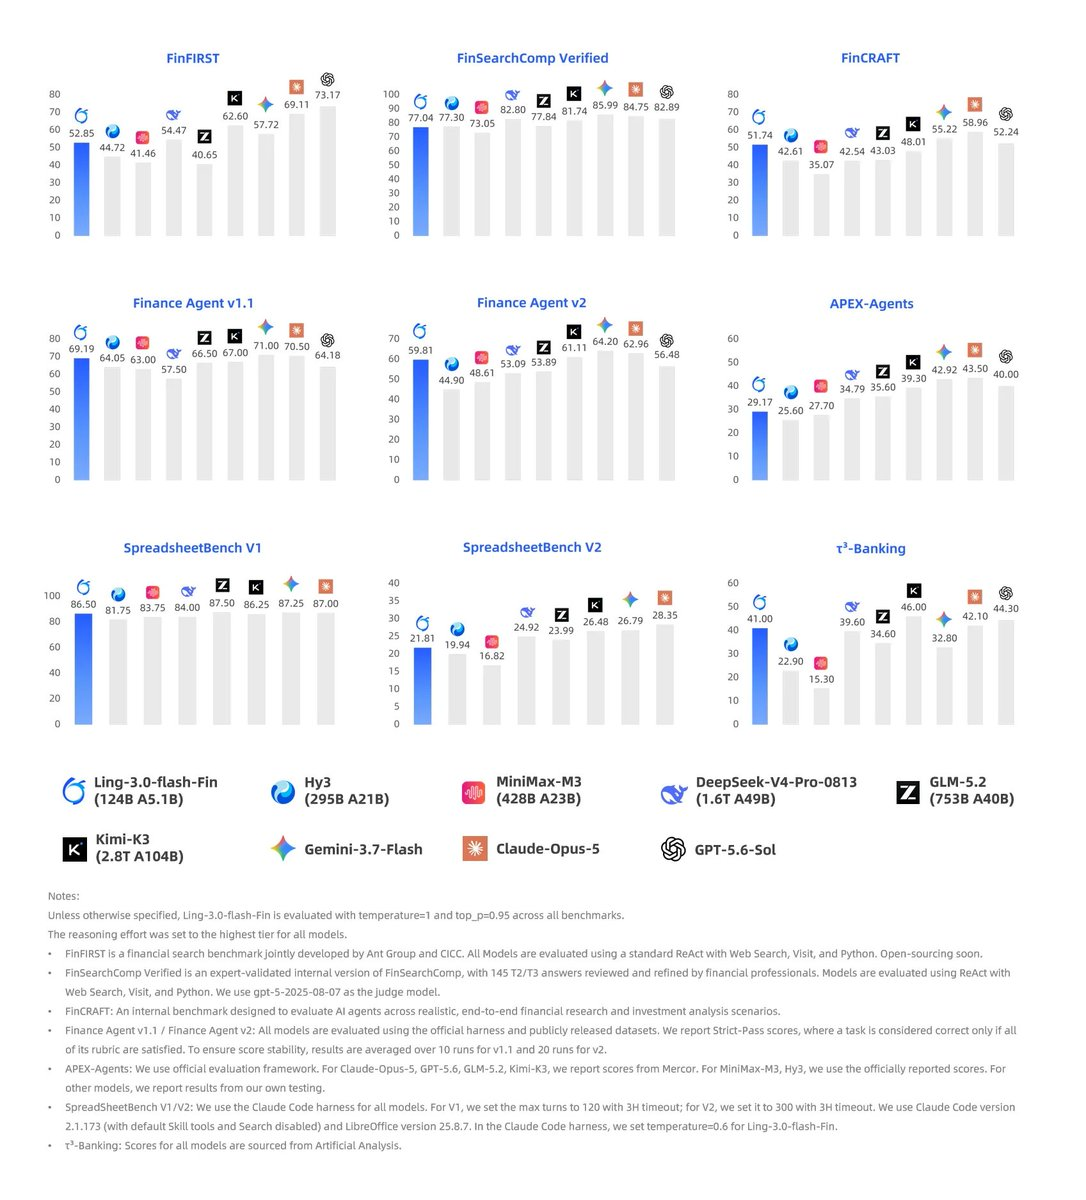
8月28日消息,蚂蚁集团 inclusionAI 的金融特化模型 Ling-3.0-flash-Fin 已于8月27日出现在 OpenRouter 和 Vercel AI Gateway 的模型目录中,以免费端点开放试用。模型基于上个月开源的 Ling-3.0-flash,总参数 1240 亿、每 token 激活约 51 亿,与基座完全相同。官方同期放出九项金融基准的评测图,把它与九个参数规模大得多的模型并列对比,并承诺将于下周开源模型权重。 与基座相同的骨架,金融方向的调优
Ling-3.0-flash 是蚂蚁 7月23日 发布的 MoE 模型,8月初在 Hugging Face 开源权重,以约八分之一的总参数对标自家万亿级旗舰 Ring-2.6-1T。Fin 版没有动这副骨架:OpenRouter 与 Vercel 两个渠道的页面给出完全一致的规格——1240 亿总参、51 亿激活、262K 上下文、32K 最大输出,支持工具调用和推理开关。多出来的是面向投研工作流的金融后训练,具体用了什么数据和方法,官方没有说明。
这种"先上 API 目录、再补官宣"的做法是这个家族的惯例。基座权重和更早的 Ling-3.0-flash-dspark 都是这样发布的:模型先出现在目录里,说明随后才补。Novita 是目前唯一的托管方,OpenRouter 页面显示其延迟约 1.1 秒、在线率 99.99%,免费端点限流使用。三个渠道的页面上,目前都找不到免费期的截止日期。
官方放榜:Agent 场景领先,检索和工作流落后
评测图的对照阵容是 DeepSeek-V4-Pro-0813(1.6T 总参)、Kimi-K3(2.8T)、GLM-5.2(753B)、Hy3(295B)、MiniMax-M3(428B),加上 Gemini-3.7-Flash、Claude-Opus-5、GPT-5.6-Sol 三家旗舰,激活参数从 210 亿到 1040 亿不等。Fin 版的 51 亿激活是全场最小的一个。 分数格局与它的定位互洽。最强的两项正是官方主投的 Agent 场景:Finance Agent v1.1 得 69.19,九个模型中仅次于 Gemini-3.7-Flash 的 71.00;v2 得 59.81 排第四,高于 GPT-5.6-Sol 的 56.48。落后的是检索和通用工作流:FinSearchComp Verified 得 77.04 排第八,仅高于 MiniMax-M3;FinFIRST 得 52.85 排第六;APEX-Agents 得 29.17 排第七。电子表格两项一近一远,SpreadsheetBench V1 的 86.50 距最高分不到 1 分,V2 的 21.81 中游偏下。 按官方附注的评测方法,Finance Agent 两项用官方 harness 重跑、按 Strict-Pass 计分,v1.1 每题平均跑 10 次、v2 跑 20 次取均值,推理档位统一设在最高。九项中唯一的第三方测定是 τ³-Banking:分数来自 Artificial Analysis,Fin 版拿 41.00 排第四,高于 DeepSeek-V4-Pro-0813 的 39.60。另一处值得留意的是 FinFIRST——这个金融检索基准由蚂蚁集团与中金公司共建,官方注明即将开源,而自家模型在自家参与共建的基准上只排第六,不利的名次也一并放了出来。
官方图之外,第三方对这套底座的印象要保守一些:Vals AI 自测的 FinanceAgent v2 榜单上,基座 Ling-3.0-flash 在 51 个模型中排在靠后位置。除 τ³-Banking 那一个分数外,Fin 版没有其他第三方测试成绩。
权重与开源:惯例在,时间表没有
家族此前的模型都以 MIT 一类宽松协议开源,照此惯例,Fin 版开放权重本该是顺理成章的事。但截至8月28日,Hugging Face 的 inclusionAI 组织下没有这个仓库,官网也没有 Fin 版的任何公告,开源时间表无从谈起。
蚂蚁做金融模型不是第一次:去年7月蚂蚁数科发布过基于 Qwen3 的 Agentar-Fin-R1。这次的不同在于底座换成了自家最新的 flash 档通用模型,并且从第一天起就把免费 API 和评测放榜一起摆在开发者面前。对金融 AI 团队来说,这是个零成本的试用机会,官方放榜也给出了自报口径下的强弱地图;模型卡里"关键结论仍需专家复核"的声明,目前没有证据可以推翻。权重一旦上架,外界才第一次有机会独立复现这九项分数。
 AI 速览