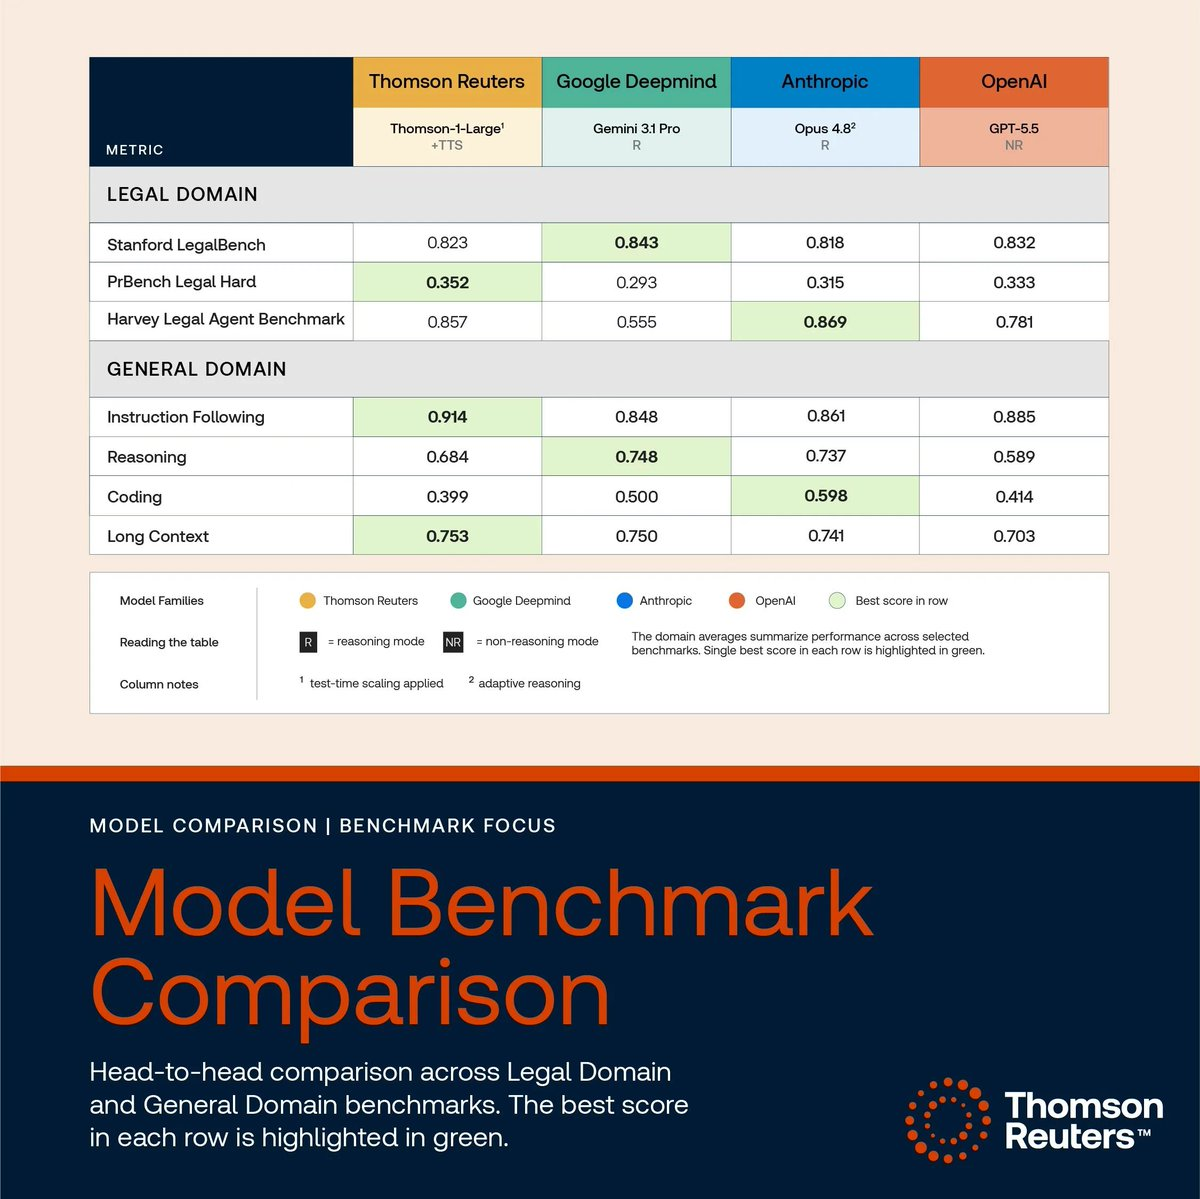
8月25日消息,汤森路透推出首个自研大语言模型 Thomson,据《Business Insider》报道,公司 CTO Joel Hron 确认其底座是阿里开源的 Qwen 模型。汤森路透为这一项目投入约 4000 万美元,主要用于人才和算力,计划让 Thomson 逐步接手目前由 Claude 承担的部分工作,先从法律 AI 助手 CoCounsel 的高频文档审查任务开始。Claude 目前仍驱动着 CoCounsel 的大部分功能。 4000 万美元造了一个什么样的模型
这笔投入跨度超过两年,主要花在人才和算力上。作为对照,The Decoder 指出,此前被外界引用的 45 万美元只相当于当前版本最后一次训练运行的成本,离全部投入差着两个数量级。
Thomson 的技术路径分三层。最底层是阿里开源的 Qwen3.5;中间层是汤森路透与英国帝国理工学院的联合团队对 Qwen 做安全、伦理和政治中立性对齐后的版本,内部命名为 Snowdon(得名于威尔士的雪山);最上层才是用自有数据继续训练出的 Thomson,数据来源包括 Westlaw、Practical Law、Checkpoint 和路透社的内容库。据《Business Insider》报道,目前训练用到的内容还不到公司全部数据的 10%。
汤森路透称,其内部评估显示 Thomson 的表现可与前沿模型相当。这一说法目前只有公司自己的口径。
从 CoCounsel 的高频任务开始「收租」
Thomson 的第一个生产部署是 CoCounsel Legal 的 Tabular Analysis 功能,一个需要处理大量结构化文档审查的高频场景——这类任务调用量大、模式相对固定,正是自研模型替代 API 调用最划算的位置。汤森路透表示,后续会把 Thomson 扩展到更多法律和税务场景。
Hron 把调用外部模型比作「租房」:钱要一直付给别人,模型的价格和演进路线也不由自己控制。汤森路透与 Anthropic 的合作关系并未中断:今年5月双方还宣布扩大合作,把 Claude 接入 CoCounsel Legal。Thomson 接手的是一部分工作,不是全部。
同一周,两家法律 AI 公司做出同一个选择
汤森路透不是孤例。8月21日前后,法律 AI 公司 Harvey 发布了首个自研模型 Tenet,底座是月之暗面的开源模型 Kimi K3,同样是为了摆脱对 OpenAI 和 Anthropic 的租用。OpenAI 本身是 Harvey 的投资方,这让后者自建模型的动作多了一层意味。David Sacks 还在 X 上把 Tenet 当作「美国公司在开放系统上做出世界级专用模型」的证据。 两家头部法律 AI 公司在同一周做出同一个选择,指向同一本账:当开源底座的质量足够好,把「按 API 调用付费的可变成本」变成「一次性投入加自有部署的固定成本」开始划算。对 Anthropic 和 OpenAI 来说,这是企业级 API 收入的结构性威胁——丢的不是聊天用户,而是 CoCounsel 这种每天跑大量任务的生产系统。对中国开源实验室来说,Qwen 和 Kimi 进入的是欧美企业的核心业务链路,这比下载量数字更有分量。
Thomson 目前只接手高频、模式固定的任务,复杂工作仍交给前沿模型;Harvey 和汤森路透都有海量的专有行业数据,这条路不是每家企业都抄得了。真正的门槛从来不在底座:Qwen 和 Kimi 谁都能下载,门槛在汤森路透几十年积累、目前只用到了不到 10% 的那部分数据。
 AI 速览