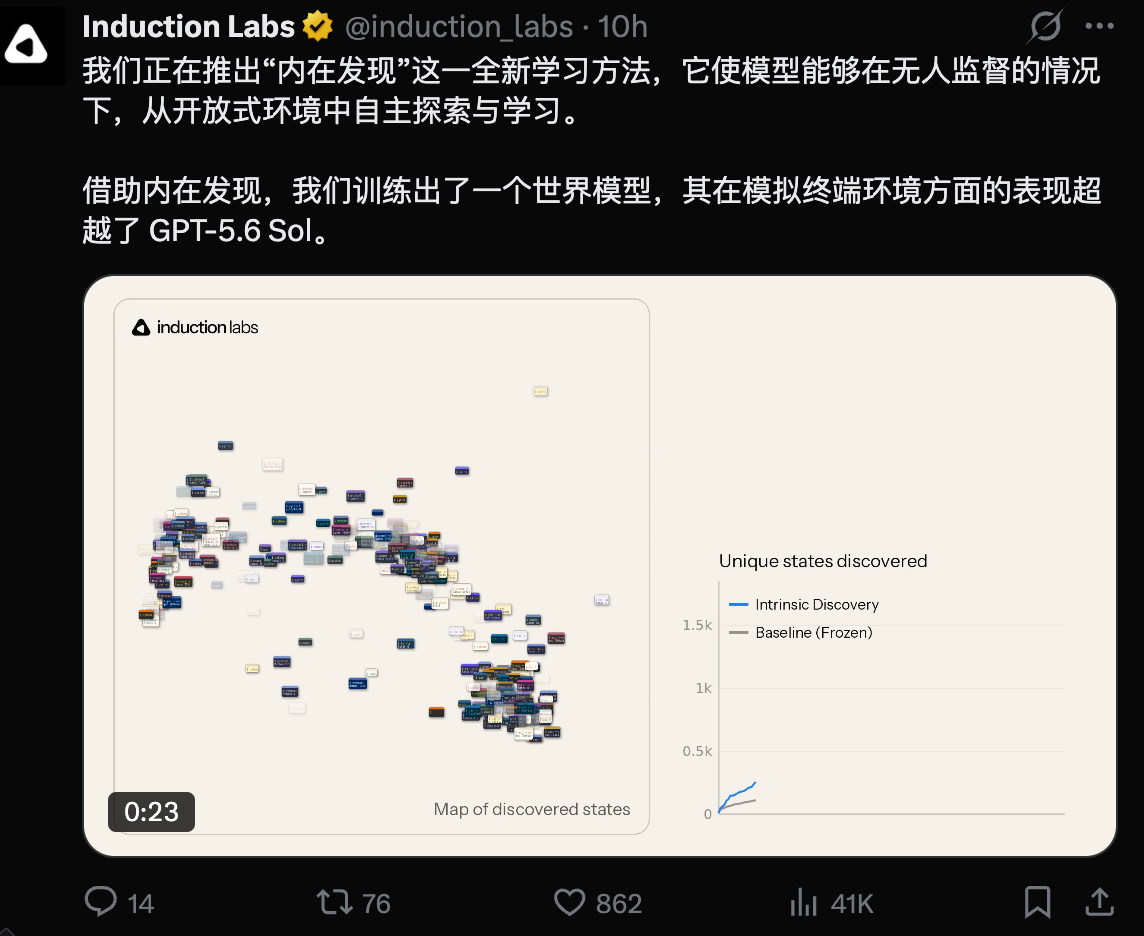
8月28日消息,旧金山两人团队 Induction Labs 发布无监督学习方法 intrinsic discovery(内在发现):用强化学习持续把模型推向没见过的新颖状态,再用这些自生成的经验训练世界模型。团队宣称,训练后的世界模型在其终端模拟基准上超过 GPT-5.6 Sol,发现的状态多样性约为固定策略基线的 5 倍。
奖励"不一样",目标是探索过程而不是策略
内在发现和常见强化学习训练的区别在目标。RLHF、RLVR 训练要的是一个更好的策略,内在发现要的是训练过程中产生的轨迹:每一步从当前策略采样动作、在终端环境里执行,得到的新观察与已发现观察集越不相似,奖励越高。策略用 GRPO 更新,新观察加入已发现集合后不再产生奖励,策略于是被持续推向环境的新区域。
团队强调,策略本身在训练的任何时点都不需要多样;多样性是在不断累积的发现集合里随时间涌现的。探索产生的"命令—观察"数据对,随后被用来训练一个从同一基座初始化的世界模型。
宣称超过 GPT-5.6 Sol,但基准和评委都是自己定的
团队报告了三项结果。在 gpt-oss-20b、Qwen3.6-35B-A3B、gpt-oss-120b 三个开源模型上,内在发现都稳定提升了世界模型表现;相对同一基座、同等数据预算的固定策略基线,下游世界模型成绩明显更好;训练后的世界模型在 AgentWorldBench-Terminal-V2 上超过 GPT-5.6 Sol。
这些数字的边界同样写在原文里。AgentWorldBench-Terminal-V2 是团队重建的版本,重新生成了环境输出并过滤无效样本,评委模型也从 GPT-5.2 换成 GPT-5.6 Luna;gpt-oss-20b 的消融实验用的是另一套内部评测 TerminalWorldBench。衡量多样性的指标是唯一 shell 命令数和 Python 库数量,团队自己承认这是可以被刷分的代理指标,并把下游成绩提升列为佐证。这条宣称的确切含义是:在自家改造的基准、自家选定的评委下超过 GPT-5.6 Sol。
两人团队,和同一条去人工数据的路线
Induction Labs 此前的工作是 imagination models 与 Photon-1。公开资料显示,Photon-1 是一个 106B 总参、激活约 5B 的稀疏 MoE 模型,用无动作标注的互联网视频做预训练,目标是让模型从屏幕录像学会操作电脑。内在发现延续了同一个方向:尽量少用人工标注数据。团队把动机写得很直接——今天的模型高度依赖人工数据,而人工数据昂贵且难以规模化,他们希望基座模型能完全无监督地学会环境的动态。
这条路线的效果强弱,现在下结论太早。方法完整公开、在三个开源模型上都做了实验,这是它比一句话宣称更扎实的部分;但基准自建、评委自选、无第三方复现,成绩只能等待独立验证。能确定的是另一件事:一个两人团队完成并公开了"探索数据自产自销"的完整闭环,这套方法的参与门槛已经降到两人团队够得着的位置。
 AI 速览