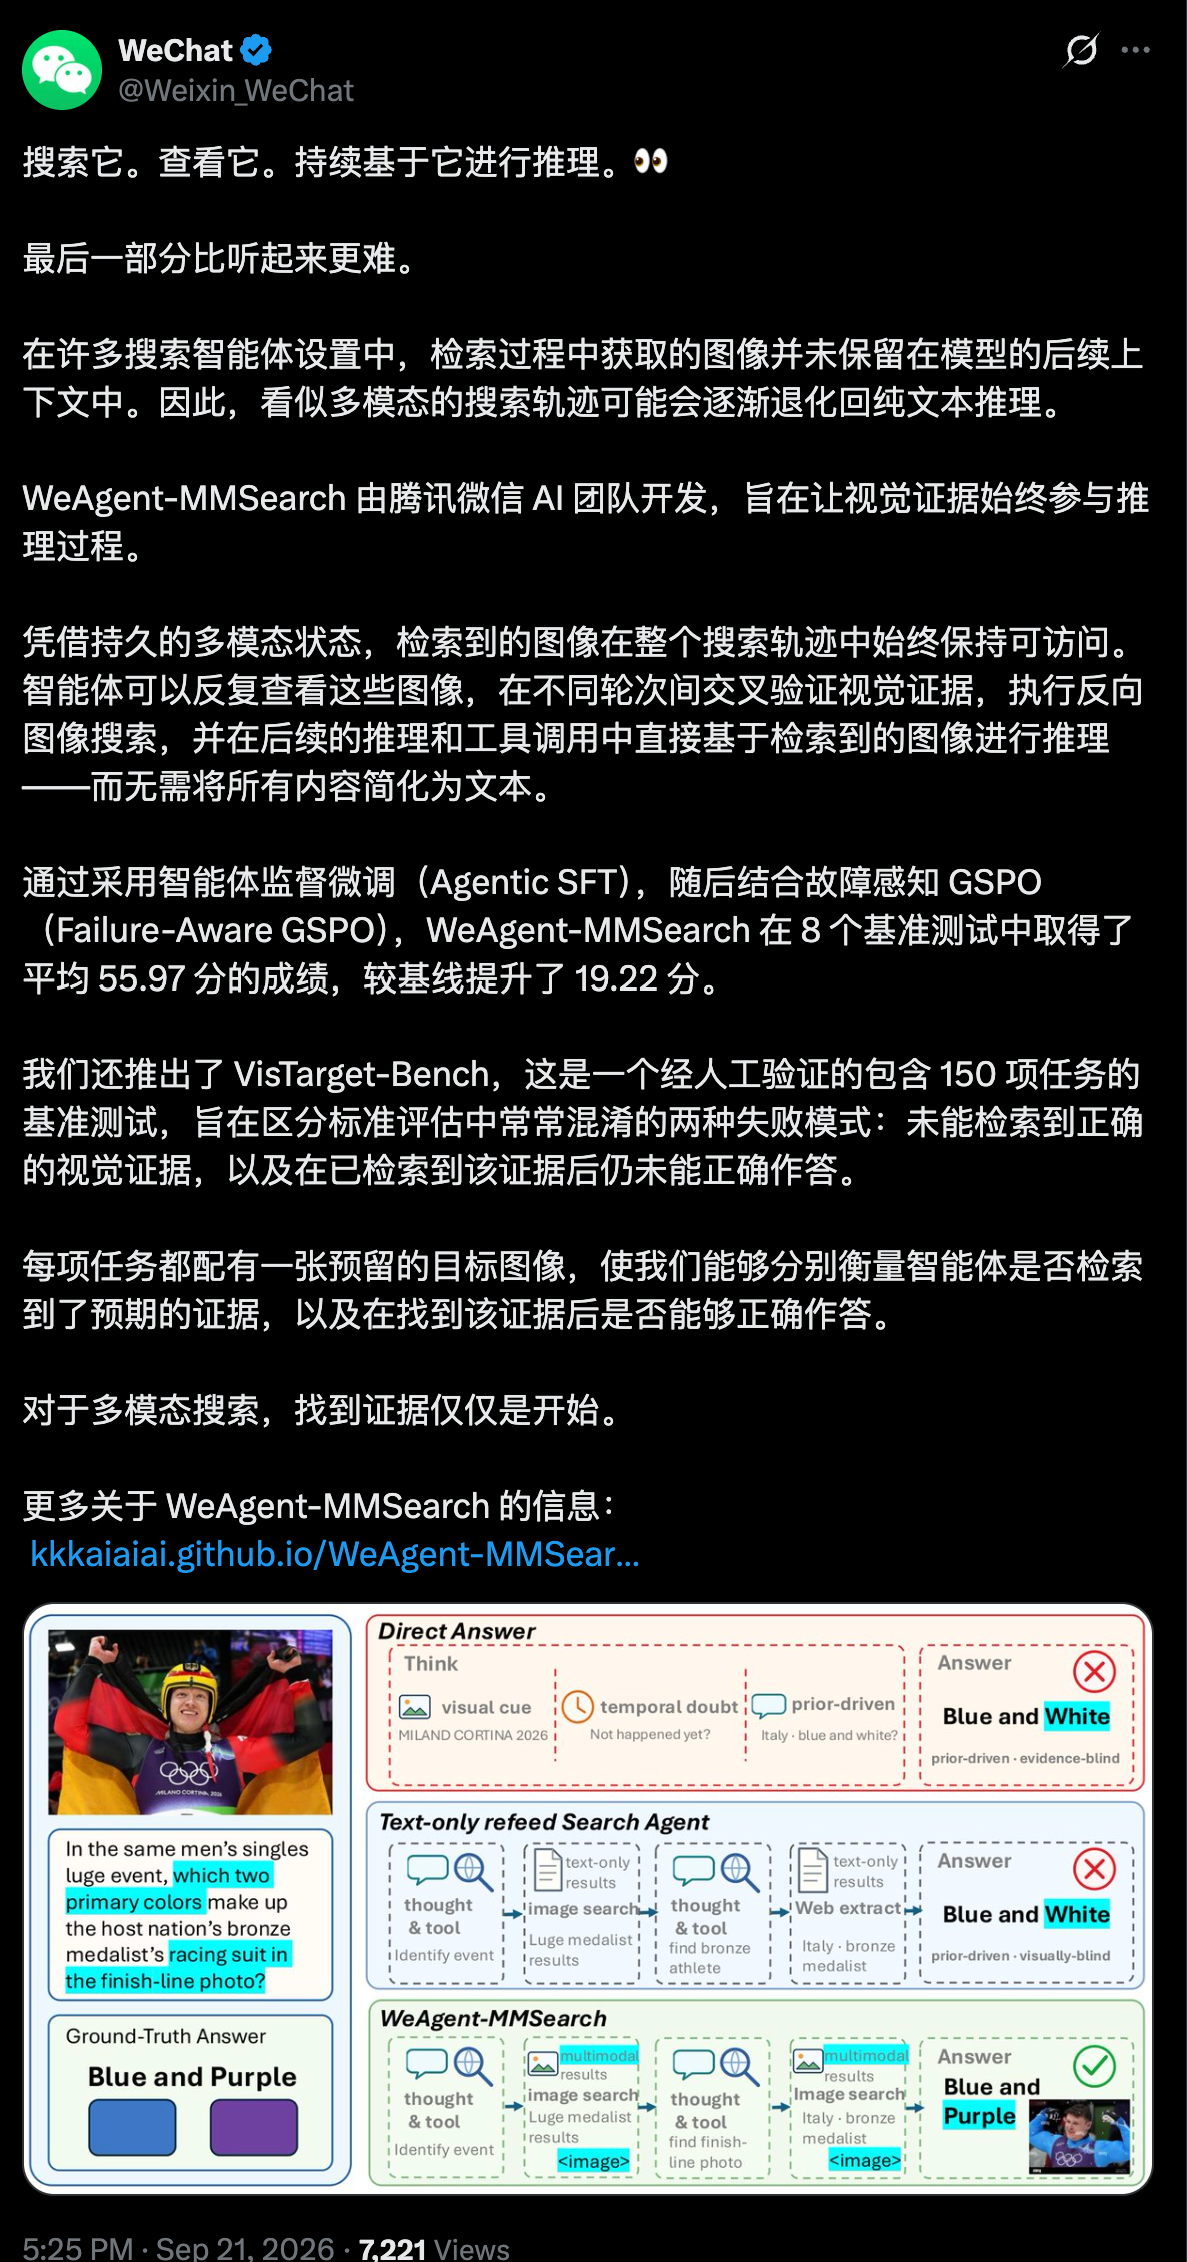
9月22日消息,腾讯微信 AI 团队与中山大学联合发表了多模态搜索智能体系统 WeAgent-MMSearch,论文已上架 arXiv(编号 2608.28062,8月28日提交,8月31日更新第二版),项目页同步上线。这项工作的核心不是让模型学会调用图像搜索,而是解决一个更靠后的问题:检索到的图像在大多数现有搜索环境里只出现一次就被丢弃,后续推理只剩文字。WeAgent-MMSearch 让这些图像在整条搜索轨迹中保持可访问,模型可以查看、处理并引用它们,直至给出答案。
把图留在轨迹里,而不是压成文本
论文对现状的判断是:许多 agentic 搜索环境只把检索证据以文本形式暴露给模型,工具返回的图像不会进入后续上下文。长轨迹中频繁出现的工具调用失败、响应超长、超时和预算耗尽,还会把本可挽救的轨迹整条丢弃。
WeAgent-MMSearch 的解法分两层。底层是名为 WeAgent-Harness 的运行框架,把网页搜索、页面抽取、图像搜索、反向搜图和代码执行统一在一个「文本—图像」状态协议下;检索到的每张图像获得一个持久磁盘引用,在之后的任意一轮都可以被重新查看、加工和引用。上层是围绕这套框架搭建的完整训练流程:先由强多模态模型在同一框架内构造并验证任务、采集专家轨迹,得到 59.5K 条 SFT 轨迹和 13.3K 条强化学习 prompt;后训练阶段采用 Agentic SFT 加 Failure-Aware GSPO,后者用于回收那些中途出错但仍有价值的 rollout,同时过滤无效样本。
把这条路线放到同期工作中看,切口比较清晰。MMSearch-R1、WebWatcher、DeepEyesV2、MM-DeepResearch 等近一年多模态搜索 agent 的主线是「让模型按需触发图像和文本搜索」,WeAgent-MMSearch 处理的是下一步:搜到之后,图不能丢。两者不是替代关系,但对做 agentic 搜索的团队来说,后者是前一类系统在长任务里最容易出问题的环节。
自报成绩,以及一个把失败拆开的基准
按论文自述,WeAgent-MMSearch 的强化学习版本在 7 个公开基准和 VisTarget-Bench 上的平均成绩为 55.97%,agentic 后训练带来的提升为 19.22 分,超过同规模开源模型,并与参数量约为其十倍的模型接近。以上均为论文自报数据,尚无第三方复测,只能按厂商口径对待。
与成绩一起发布的还有 VisTarget-Bench,一个包含 150 道任务的人工验证基准。每道题配有一张留出的目标图像,评分时分别检查两件事:agent 有没有把目标图检索出来,以及检索到之后有没有读对图中的像素信息。这相当于把过去笼统的「答错了」拆成「没找到图」和「找到了仍答错」两类失败,对诊断搜索 agent 的瓶颈比单一总分更有用。
还没开源,能带走的是方法
目前这项工作仍停留在论文阶段。项目的 GitHub 仓库已经建立,但只有一个占位文件,代码和模型权重都没有放出;论文的更新停留在8月31日。微信 AI 方面也没有表明该系统与微信搜索或腾讯其他产品功能存在关联。
能确认的是团队在这条线上的持续投入。公开主页显示,通讯作者孟凡东是微信 AI 的首席研究员和团队负责人,其团队今年有九篇论文被 ACL 2026 接收,近期还与北京交通大学合作发布了多语言长程 agent 基准 PolyWorkBench,与北京大学合作的视觉证据视频推理框架 Conan 则被 CVPR 2026 接收。WeAgent-MMSearch 是这条 agent 研究线上最新的一环。
对做搜索 agent 和 DeepResearch 类产品的团队来说,这篇预印本里有两个可以独立借用的设计:一是把工具返回的视觉证据当作一等公民持久保存的 harness 结构,二是把检索失败和感知失败分开统计的评测口径。至于 55.97% 的平均分代表什么水平,在代码和权重公开、第三方复测出现之前,这个问题没有答案。
 AI 速览