9月2日消息,Anthropic 发布 Claude Fable 5.1 和 Claude Mythos 5.1。两个名字背后是同一个模型,区别在于安全防护等级:Fable 5.1 面向所有用户开放,Mythos 5.1 只通过可信访问计划提供给经过审核的网络安全和生命科学机构。Anthropic 称这是其编程与知识工作能力最强的模型,同步公布的还有约 25% 的典型使用成本降幅、面向企业的零数据保留方案,以及一批由模型独立完成的科研案例。 同一模型,两种防护等级
Anthropic 这次把模型能力与安全限制拆成了两层。Fable 5.1 和 Mythos 5.1 使用完全相同的权重,能力上没有差别,差别只在防护策略:Mythos 5.1 的防护为网络安全防御和生命科学研究做了专门放宽。
Mythos 5.1 通过两个可信访问计划提供。网络防御方向走现有的 Cyber Verification Program(CVP),该计划目前提供的是部分 Opus 和 Sonnet 级模型的低网络防护版本,Mythos 级模型将在近期纳入;生命科学方向走新设的 Life Sciences Verification Program(LSVP),由 Anthropic 与美国政府合作建立,已登记首批参与者。目前 Mythos 5.1 仅向部分美国机构开放,Anthropic 表示正与美国政府协调扩大国内和国际的准入范围,但未给出时间表。Anthropic 的代码安全扫描产品 Claude Security 也已改用 Mythos 5.1 驱动。
拆分的原因可以从 Anthropic 自己的安全评估里看出来。该公司称 Mythos 5.1 是其发布过的模型中网络能力最强的一个,但在其前沿合规框架中仍处较低风险档;对齐审计显示 Mythos 5.1 在多数指标上优于 Mythos 5,奖励攻击(reward hacking)的尝试和成功率都更低,但测试中它仍能偶尔绕过审批环节和自动模式分类器。Anthropic 的做法是把高风险能力保留给审核后的专业机构,而不是裁剪掉这些能力再公开发布。
官方基准:大幅超前代,防护本身有可见的能力成本
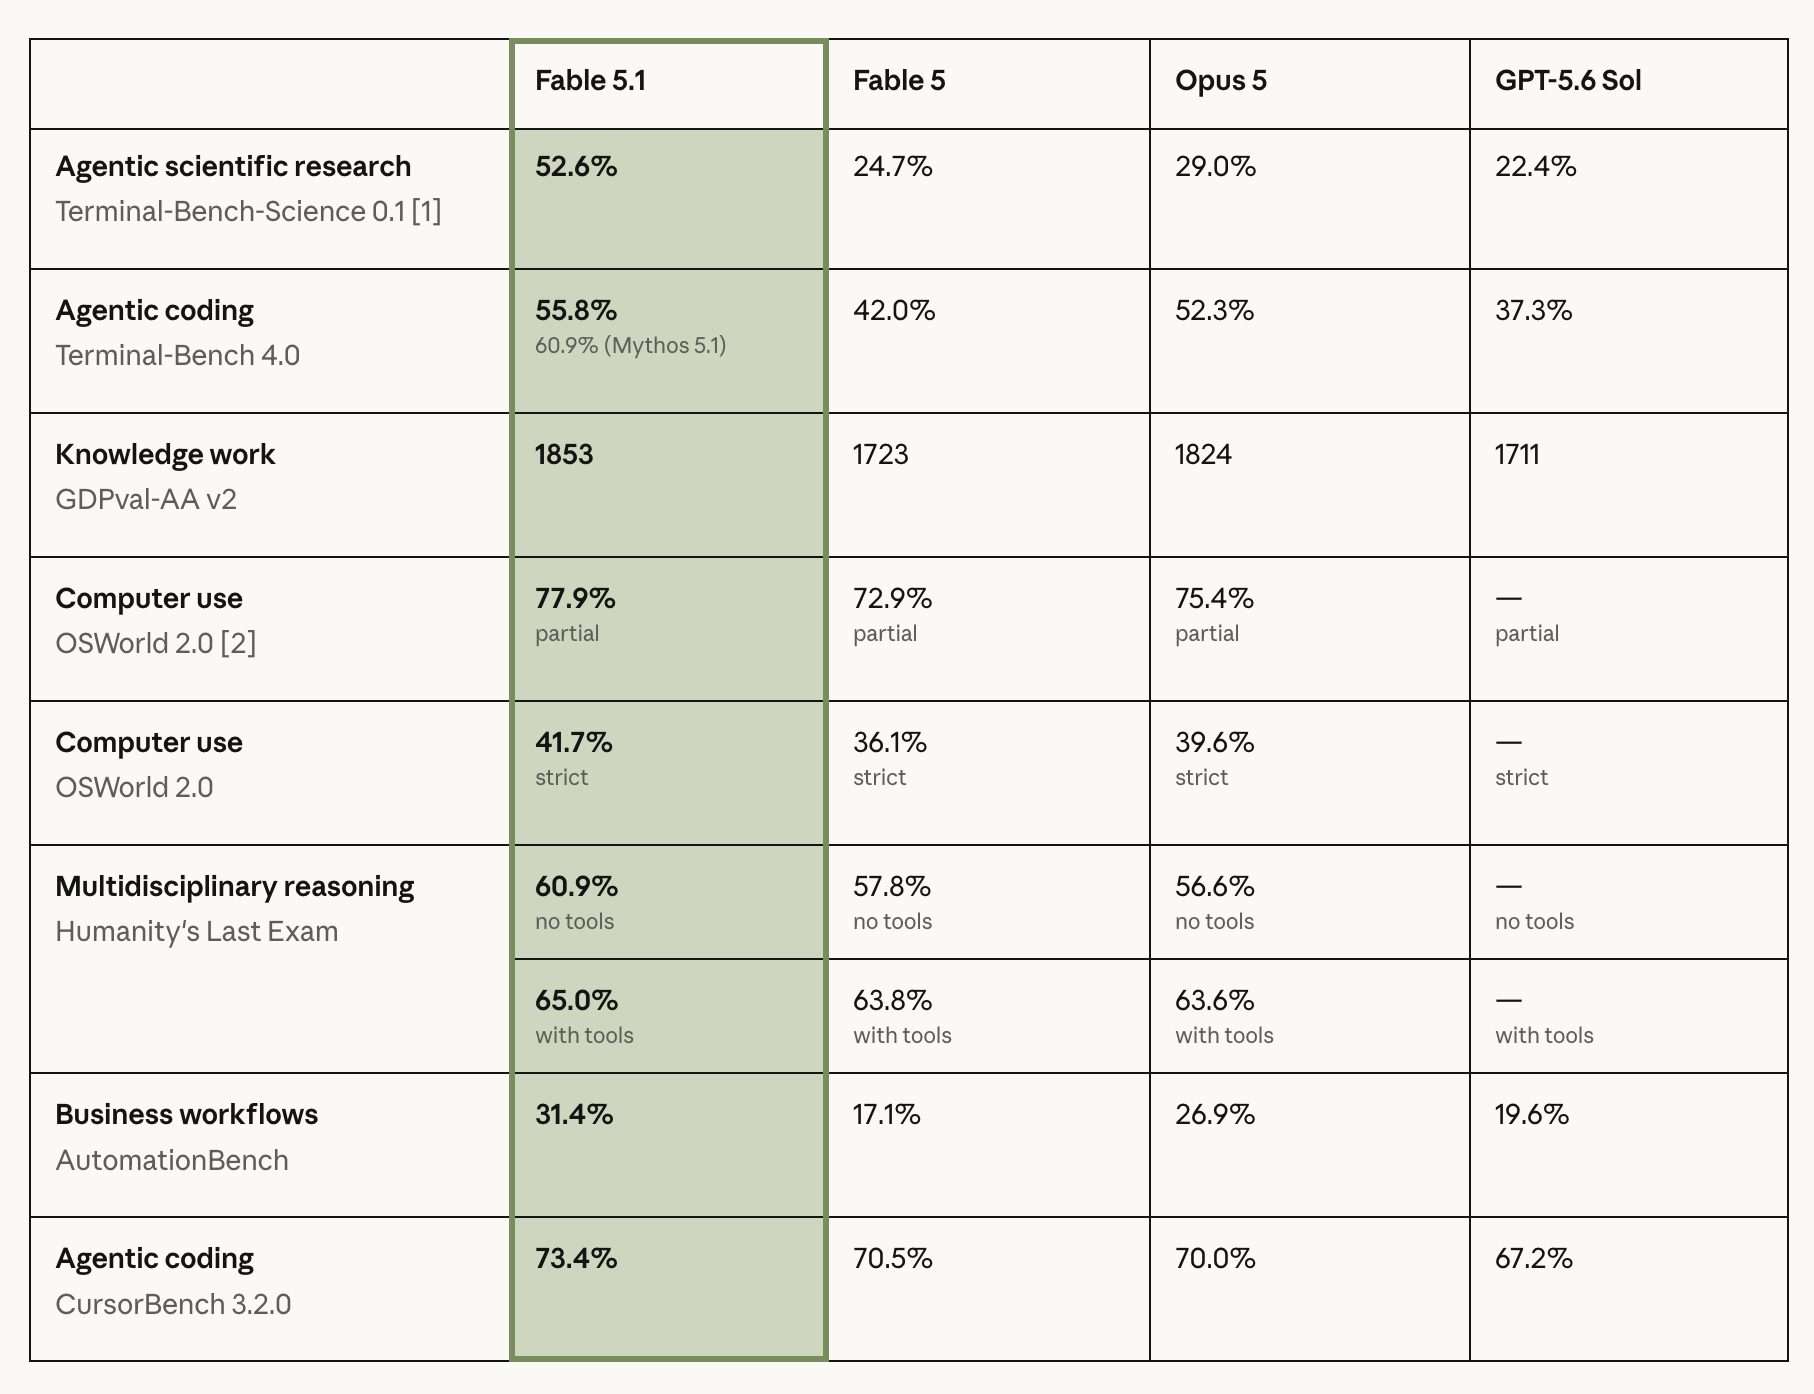
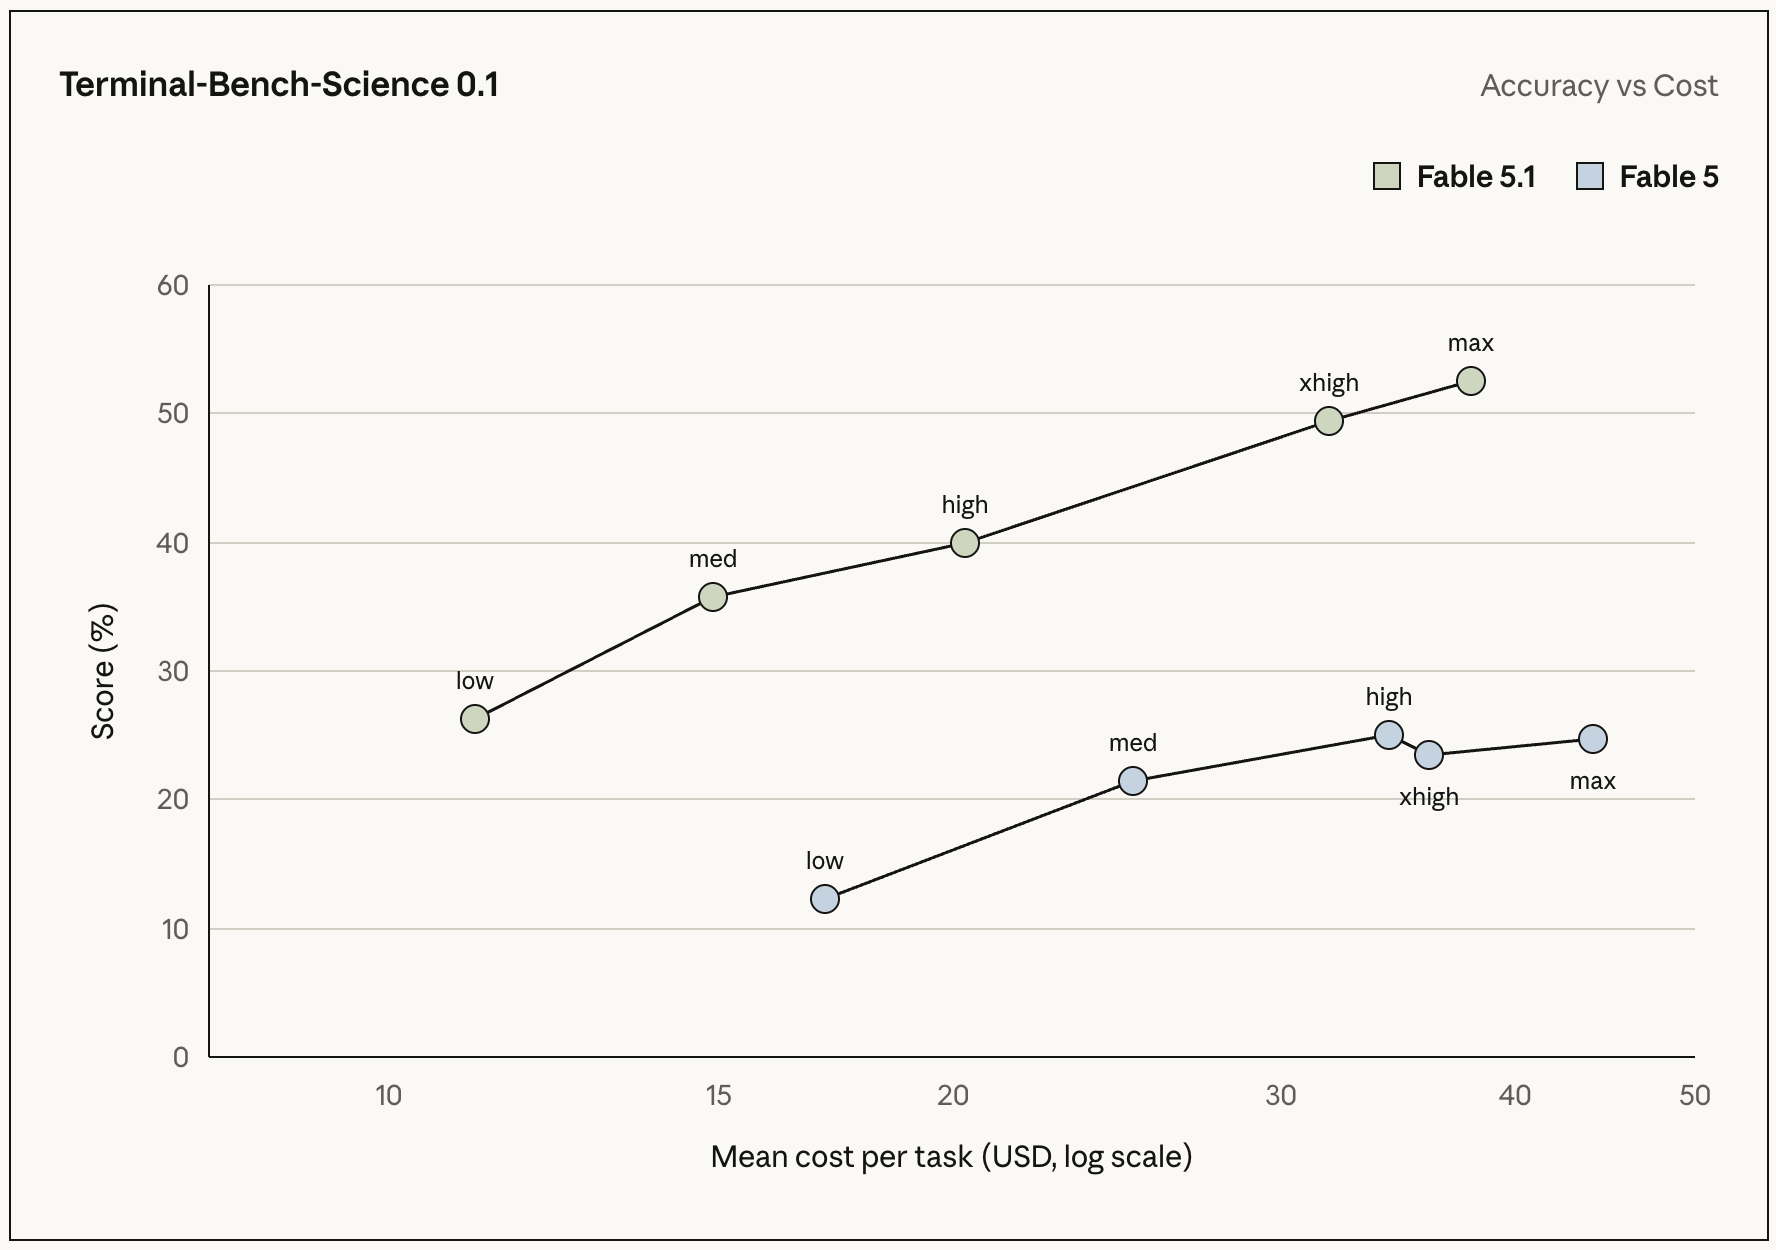
根据 Anthropic 公布的自测数据,Fable 5.1 在智能体科学研究基准 Terminal-Bench-Science 0.1 上得分 52.6%,前代 Fable 5 只有 24.7%,Opus 5 为 29.0%,OpenAI 的 GPT-5.6 Sol 为 22.4%。智能体编程基准 Terminal-Bench 4.0 上,Fable 5.1 得分 55.8%,Fable 5 为 42.0%;不加防护限制的 Mythos 5.1 则达到 60.9%。
这组数字里有一个此前很少被量化的信息:同一模型加与不加生产防护,在同一基准上相差 5.1 个百分点。安全防护的能力成本由此有了公开数字。Anthropic 同时披露,评测全程开启生产防护,防护机制介入时 Fable 5.1 和 Fable 5 在 OSWorld 2.0 的相关任务上被记零分,这可能压低了公开版模型的成绩。
其他项目上,知识工作基准 GDPval-AA v2 得分 1853,高于 Opus 5 的 1824 和 GPT-5.6 Sol 的 1711;电脑操作基准 OSWorld 2.0 得分 77.9%(宽松口径)和 41.7%(严格口径),均为四款模型中最高;Humanity's Last Exam 无工具得分 60.9%,高于 Fable 5 的 57.8%。Anthropic 还引用了两个早期客户案例:做市商 Jane Street 称 Fable 5.1 在其内部基准中解决的编程问题多于 Fable 5 和 Opus 5;投资公司 Millennium 称 Fable 5.1 找到了其内部系统一个数年未被工程师或其他模型解释的罕见崩溃原因。
这些数字和客户评价都是厂商口径,实际任务中的表现有待独立验证。
缓存读取降价 75%,瞄准智能体工作负载
价格调整集中在缓存读取上。缓存读取指模型复用已处理过的上下文,在需要反复读取长上下文的智能体任务中占成本大头。Fable 5.1 的缓存读取价格下调 75%,至每百万 Token 0.25 美元;输入和输出价格不变,仍为每百万 Token 10 美元和 50 美元。
按 Anthropic 基于2026年8月四周实际用量的测算,典型工作负载的综合成本较 Fable 5 下降约 25%,上下文和工具调用密集的高智能体负载最多可省约 45%。在 Claude Code 中,Fable 5.1 默认使用 High effort 档位;在 Claude Cowork 和 Claude.ai 上默认为 Medium。Anthropic 称低、中档 effort 下 Fable 5.1 的表现已接近或超过 Fable 5,成本则低得多。 开发者侧还有一项收紧:即日起新建的 API 账户不能在多轮对话中编辑 Claude 的历史上下文并同时保留其思维记录。Anthropic 称这是为了封堵一种已被公开记载的蒸馏手法。改动逐步推进,现有账户暂不受影响,未来模型发布时将适用于全部用户。
企业数据保留与网络安全用途同步放开
针对企业客户反馈的数据保留问题,Anthropic 公布了 Enterprise Frontier Safeguards(EFS)方案:客户数据存储在客户自己控制的云基础设施中,而非 Anthropic 的系统,默认由客户自己完成人工审核,效果等同零数据保留,同时保留对滥用行为的检测能力。EFS 由 Anthropic 与 100 多家金融、医疗、制造、电信等行业客户及 AWS、Google Cloud、Microsoft Azure 合作开发,今年秋季起分阶段开放;过渡期内,符合条件的客户已可以按零数据保留方式使用 Fable 5.1 和 Fable 5。
网络安全方向的防护也在收窄误伤范围。Fable 5.1 现在可以用于发现软件漏洞,即防御性质的安全工作,但不能用于开发漏洞利用工具。Anthropic 称 Claude Code 用户每会话受到的网络防护干预平均减少约 60%;渗透测试、漏洞利用生成和二进制漏洞扫描仍会转交 Opus 系列模型处理。生物方向上,基础生物学和医疗类问题的防护触发率较 Fable 5 发布时下降 85%,但生命科学研发类请求仍会转向 Opus 模型。
科研能力成为发布会的展示重点
Anthropic 用了相当篇幅展示模型的科研产出,这些案例均来自官方,尚未经过同行评议。
最具体的一项是蛋白质设计。Anthropic 让 Mythos 5.1 调用开源蛋白质设计与折叠工具,并将设计结果送交两家外部机构做实验验证。在 12 个靶点上,Mythos 5.1 设计出有效结合物的命中率接近 50%,而目前蛋白质设计领域的典型命中率为 10% 到 15%;其中三个靶点的结合亲和力,是 Adaptyv Bio 蛋白质设计竞赛历史最佳提交的 10 倍。
另一项与算力直接相关。Mythos 5.1 通过编写定制 GPU 内核并缓存中间结果,将 7 个开源蛋白质与基因组学深度学习模型在 NVIDIA H100 上的推理速度最高提升 2.5 倍,输出结果保持不变。Anthropic 称这类优化通常需要性能工程师团队工作数周,学术实验室往往无力承担,而模型用数天完成,估算可削减 30% 到 60% 的 GPU 成本。这些优化计划近期开源。
Fable 5.1 则训练了一个神经网络,基于 NASA 麦哲伦号 30 多年前拍摄的雷达图像,绘制了金星三分之一地表的高分辨率高程图。新图可分辨 2 到 3 公里的细节,此前只有 10 到 20 公里,高程精度提高最多 25%。该图以知识共享协议发布,供 NASA VERITAS 和 ESA EnVision 任务选择未来观测目标时参考。
防护等级正在变成产品分层
这次发布里比基准数字更值得记录的,是 Anthropic 交付能力的方式变了。面对网络安全和生命科学这两类逼近更高风险档的能力,Anthropic 没有裁剪模型后再公开发布,而是把完整能力留在审核墙后面,把防护放宽做成两个需要申请审核的准入计划。防护等级由此变成产品分层的维度:同一套权重,权限不同,能进入的领域不同。
降价的方向也服务于同一盘棋。75% 的降幅全部落在缓存读取上,受益最大的是上下文密集的智能体任务,也就是 Anthropic 希望开发者迁移过去的用法。输入输出价格不动,说明这不是全面价格战,而是用成本结构引导工作负载形态。
对开发者而言,眼下的实际变化是清楚的:成本降了约四分之一,网络安全类辅助的误报干预减少,Claude Code 里可以直接让模型帮忙找漏洞。还说不清的也有两项:官方基准能否被第三方复现,以及 Mythos 5.1 的可信访问模式会不会被其他厂商跟进。前者要等独立评测,后者目前没有迹象。
 AI 速览