Anthropic 最新推出 Claude Fable 5.1 与 Mythos 5.1,其中 Fable 5.1 面向全量用户开放,在 Agent 科研、浏览器自动化、长周期任务等维度实现大幅跃升。多场景实测验证,这款模型在执行类、工具类工作场景的表现已经稳压 GPT-5.6 Sol,叠加缓存成本大幅下降,成为重度 Agent 用户的高性价比选择。 一、纸面性能与定价:Agent 能力跃升 缓存成本大降
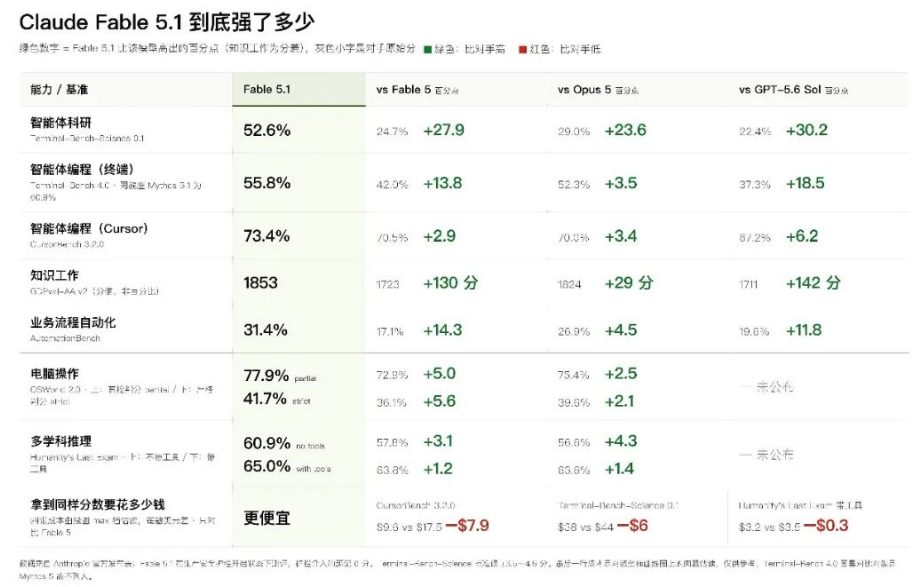
基准测试数据显示,Fable 5.1 的核心提升集中在 Agent 相关维度。
智能体科研能力相比 Fable 5 提升 27.9 个百分点,较 GPT-5.6 Sol 高出 30.2 个百分点;终端智能体编程提升 13.8 个百分点,知识工作总分提升 130 分,业务流程自动化能力提升 14.3 个百分点,多学科推理等基础能力也有稳步上涨。 定价层面,输入输出单价仍维持每百万 Token 10 美元 / 50 美元,但缓存读取成本相比 Fable 5 降低 75%,降至每百万 Token 0.25 美元。
官方测算普通任务整体成本下降 25%,高度 Agent 化任务成本下降 45%。不过订阅额度仍存在文字游戏:宣传的 20 倍额度仅在 5 小时限制窗口内生效,实际日常使用约为 Pro 版的 6 到 8 倍。
二、核心升级:浏览器自动化与 UI 处理能力对标头部
浏览器自动化是本次升级最具实用价值的亮点,彻底解决了前代模型网页操作反复失败、需手动终端介入的痛点。
实测中仅用一句指令,模型即可完整扫描网站全页面,输出每页详细参数与差异说明,同步生成 PC 端与移动端的适配对比,且全程保留截图验证。
在 goodcase 网站 UI 优化任务中,模型自动形成适配策略:根据素材与展示框的偏移度判断裁剪或留白,多图素材自动拼成九宫格布局,优化后首帧不再出现主体截断、素材错位等问题,前端视觉呈现与多尺寸适配能力明显提升。 此外模型的上下文主动性增强,会主动搜索历史对话中的文件与方案进行复用,无需用户手动指定路径,长周期项目的衔接效率大幅提升。
三、Agent 工具落地:文件管理与工作流提效
针对真实工作痛点,Fable 5.1 可落地的 Agent 工具能力进一步完善。
针对本地文件杂乱、Mac 内存占用过高的问题,基于杜威十进分类法、阮冈纳赞分面分类、卢曼卡片盒笔记法等五种经典知识管理理论,推出专属文件整理 Skill:自动识别删除重复文件,评估目录混乱度并输出优化结构,最终以知识图谱形式呈现整理结果,且跨 Windows、Mac、Linux 多系统可用,有效缓解了本地 Agent 运行的内存压力。
在内容管理场景,模型还可自动对案例库进行多维度分类,支持按类目随机抽取案例测试新模型,完善了模型评测的工作流体系。
四、创意编程实测:3D 游戏完成度超越竞品
3D 游戏开发测试进一步验证了复杂任务的完成能力。
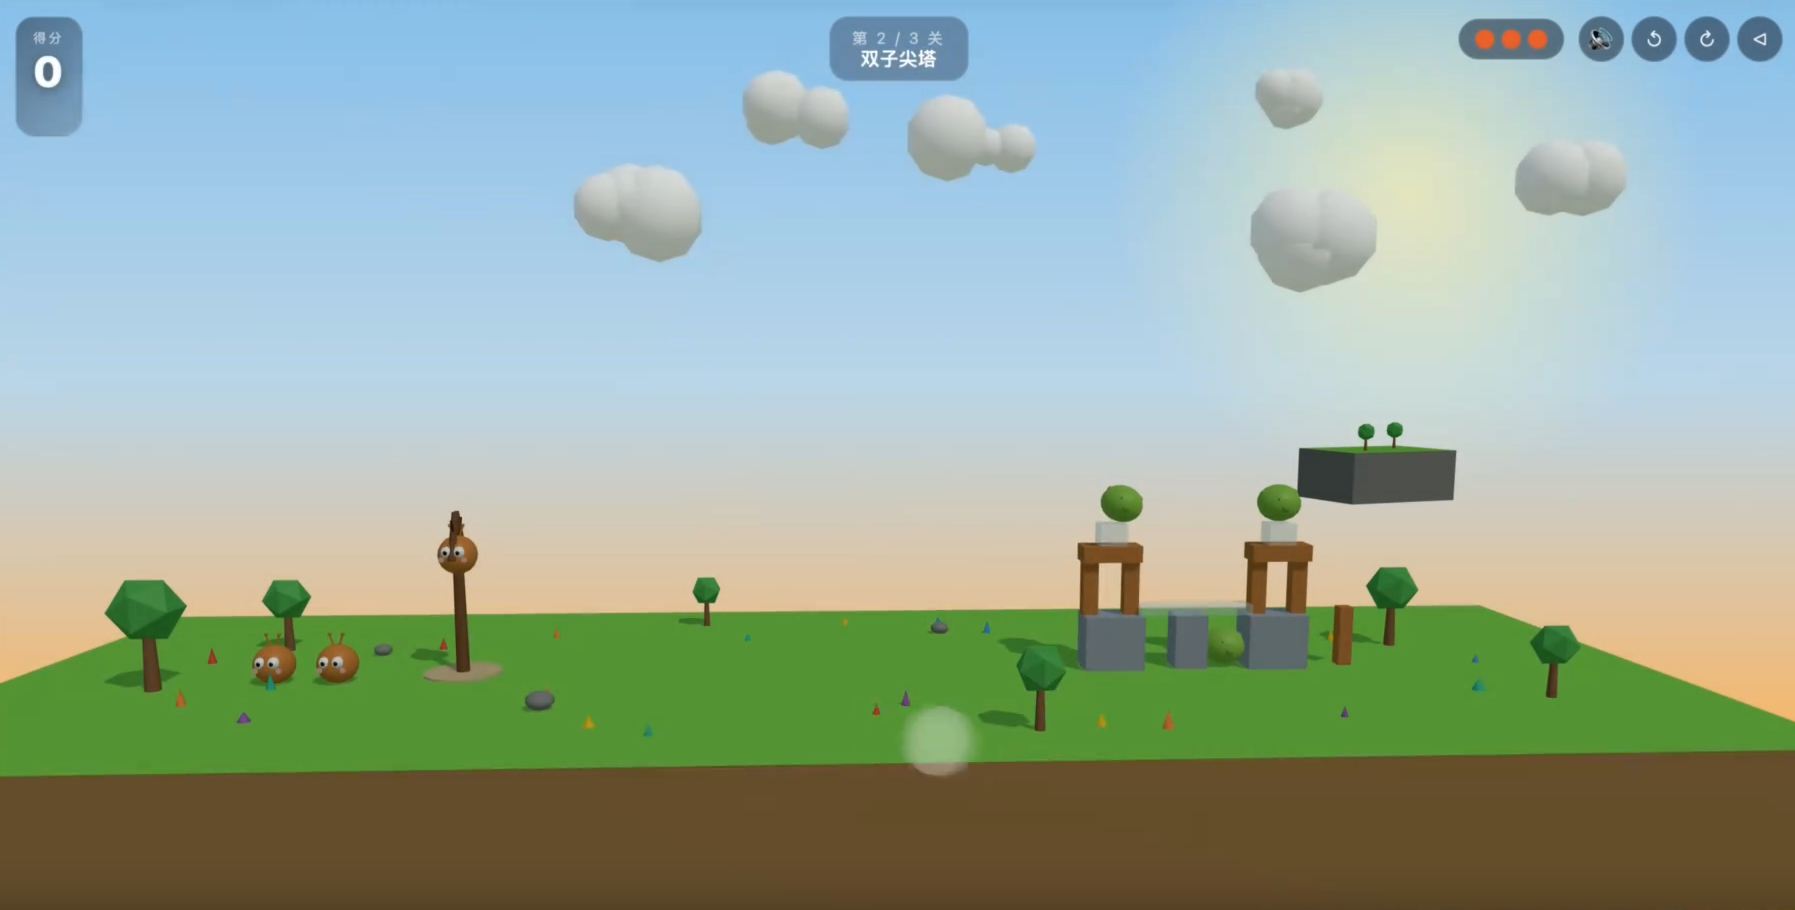
以 “3D 版愤怒的小鸟” 为测试目标,对比 GPT-5.6 Sol,Fable 5.1 的完成度更突出:不仅复刻核心玩法,还实现了 4 种鸟类、8 个关卡的完整内容,为物体加入独立密度与耐久度属性,游戏难度与物理真实度更高。 细节层面,实现了跟随镜头、无边界地图、击中特写等效果,鸟落地有滚动惯性,建筑坍塌有连锁物理反应,还原了游戏本身的紧张感。生成过程中还主动询问是否拓展移动端适配,工程化思维更完整。最终产出的可运行 HTML 文件,完成度与可玩性均优于竞品版本。
整体来看,Fable 5.1 的优势集中在长周期 Agent 任务、浏览器自动化与复杂工作流处理,在这些场景已经稳压 GPT-5.6 Sol,叠加缓存成本下降,重度 Agent 用户的性价比提升显著。不过模型在纯写作表现上并无优势,更适合面向执行类、工具类工作场景。
 AI 速览