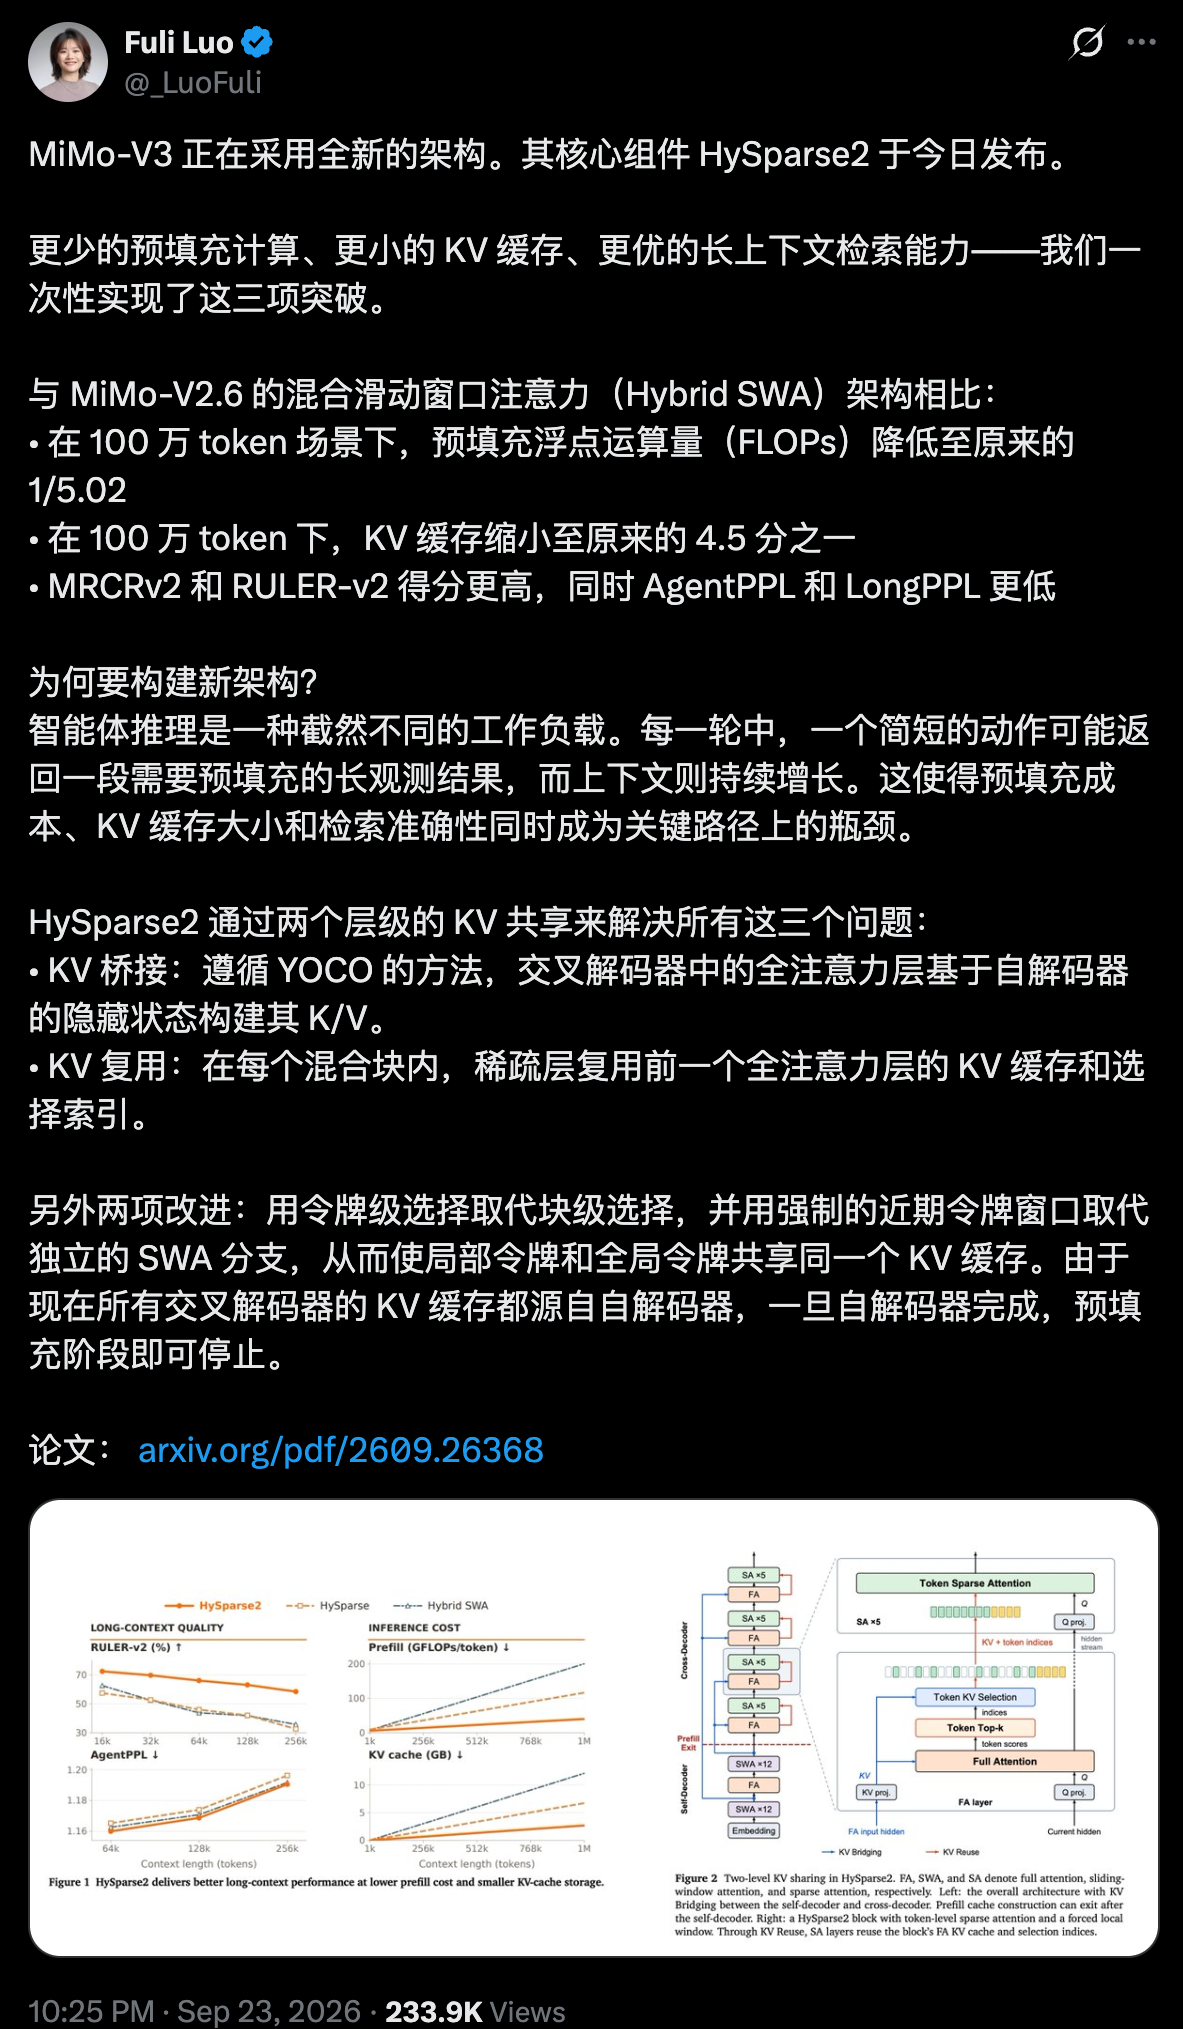
9月24日消息,小米 MiMo 团队公开混合稀疏注意力架构 HySparse2,论文已于 9 月 22 日挂上 arXiv。据 IT 之家报道,团队负责人罗福莉确认它将作为下一代模型 MiMo-V3 的核心架构。论文的效率数字全部来自 80B-A3B 规模的实验模型,MiMo-V3 的发布时间和规格尚未公布。
预填充计算降至约五分之一
论文在 80B-A3B MoE 实验模型上对比了 HySparse2、HySparse 和 MiMo-V2 系列使用的 Hybrid SWA,三者的训练数据和训练计划相同。100 万 token 输入下,HySparse2 的预填充计算量比 Hybrid SWA 少 5.02 倍,比 HySparse 少 2.92 倍。KV 缓存占用 2.69 GB,Hybrid SWA 为 12.09 GB。KV 缓存是模型推理时保存上下文信息的显存数据。
预填充-解码分离部署时,预填充节点只需承载 49 层中的前 25 层,显存需求降近一半;预填充阶段只有 1 层全注意力参与计算。
长上下文检索超过前代
轻度后训练后,HySparse2 的平均 MRCR-v2 比 HySparse 高 11.30 分,平均 RULER-v2 高 19.81 分。在 256k 长度上,RULER-v2 为 58.45,HySparse 为 32.61,Hybrid SWA 为 35.74。在所有受测长度上,agent 轨迹困惑度 AgentPPL 和长依赖困惑度 LongPPL 都低于两个基线。
预训练阶段,三者的通用能力基本持平,HySparse 在 DROP 等单项仍占优。HySparse2 的优势集中在长上下文:RULER 得 90.77,为三者最高;NoLiMa 得 49.76,比 HySparse 高 9.49 分。
两层 KV 共享
机制上,HySparse2 在今年 2 月公开的 HySparse 之上做了两层 KV 共享。外层叫 KV Bridging,借用 YOCO 的自解码器加交叉解码器结构,但只桥接其中的全注意力层。交叉解码器全注意力层的 KV 缓存,由对应自解码器层的隐藏状态直接生成。内层沿用 HySparse 的 KV Reuse:稀疏层复用同一块内全注意力层的 KV 缓存和选择结果。这一层有两处改动:块级选择换成 token 级选择;稀疏层独立的滑窗注意力分支被移除,改为把最近 128 个 token 强制选入选择集。
因为所有 KV 缓存都能从自解码器构造,预填充在自解码器跑完后即可退出,不再执行交叉解码器。论文的表述是:「预填充因此可以在自解码器之后退出。」消融实验显示,token 级选择在相同注意力预算下把 RULER-v2 提高 6.57 分。KV Bridging 在 290B-A8B、约 1.8 万亿 token 的规模上验证过,质量与不用桥接的模型基本持平。
为「短动作、长观察」的 agent 负载设计
论文对准的是一类具体负载:多轮 agent 每轮只生成很短的动作,却要处理工具和环境返回的长观察,推理负载越来越以输入为主。小米为此自建了 AgentPPL 评测,用 1000 条多轮 agent 轨迹衡量模型在长上下文里的表现。
从 2 月的 HySparse 到 HySparse2,这条架构线的设计重心在变:上一代解决的是注意力怎么稀疏,这一代同时压缩预填充路径和 KV 存储,评测指标也直接换成了 agent 轨迹。做 agent 长会话部署的人,主要开销正是预填充计算和 KV 显存;论文口径下两者同时下降,检索准确率还更高。这些数字全部来自实验模型;论文本身没有给出 MiMo-V3 的参数和训练规模。
 AI 速览