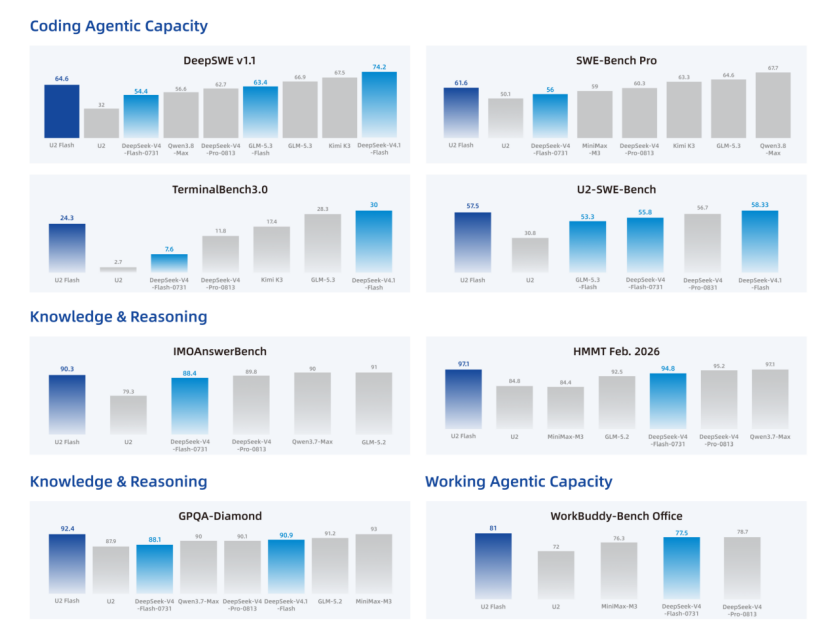
9月16日消息,港股上市公司云知声(09678.HK)发布自愿性公告,推出基于 U2 通用基座强化后训练的新一代主力模型 U2-Flash。公告给出的规格是:稀疏混合专家(MoE)架构,总参数约 266B,单次推理仅激活约 10B,首字响应平均控制在 3 秒以内,峰值输出吞吐最高 300 tokens/s。公告称模型在 DeepSWE、SWE-Bench Pro、TerminalBench 三份编程与智能体评测上超过 GLM-5.3-Flash、DeepSeek-V4-Pro-0813 等型号,并把递归自我改进(RSI)引入了后训练闭环。 266B 只激活 10B,推理强度分四档
U2 的上一代定位偏效率,这一版按公告说法转向承担复杂生产任务的主力模型,编程、智能体、数学推理与指令遵循统一在同一套权重里。激活比例不到 4%,加上首字 3 秒以内和 300 tokens/s 的峰值吞吐,规格整体压着成本设计。
推理机制上,公告称模型具备隐式思考与连续状态推理能力,推理强度封装为四档可控接口,最高档位可输出完整、可核查的推理链条。部署侧,模型已完成对主流国产算力平台的系统性适配,具体平台名单公告未列。
三份 benchmark 的分数与口径
公告给出的分数:DeepSWE v1.1 拿到 64.6 分,较前代翻倍,公告称超过 GLM-5.3-Flash 和 DeepSeek-V4-Pro-0813;SWE-Bench Pro 拿到 61.6 分,较前代提升 10.5 分;TerminalBench 3.0 拿到 24.3 分,公告称超过 K3 等万亿参数级模型。效率侧,Agent 任务的迭代步数减少 20%–30%,执行周期缩短约 35%,Token 消耗降低 20%–30%。
这些数字的口径需要说清:全部成绩为云知声自行评测,对比的竞品型号与榜单由厂商选定,目前没有第三方实测可对照。选型团队引用时,"公告口径"是必要前缀。
RSI 进了后训练闭环
这轮发布里概念最重的是训练方法。公告称 U2-Flash 把递归自我改进引入后训练,是公司在这个方向的第一步实践:模型参与任务生成、轨迹分析与纠错重采样,自主构建了规模近 10 万的高质量 SWE 任务集;训练管线采用异步 Agent RL、多自训练教师模型的在线策略蒸馏和自适应动态任务生成,有效训练轨迹数提升约 60%,训练步数减少约 55%,模型还能自主巡检与修复训练系统。公告同时给出边界:全部调整在人工设定的沙盒与验证标准内进行,保留完整可回滚记录。
RSI 这个词同一周里出现了两层。前一天(9月14日),Google 团队提交 Dream-RSI 论文,把 agent 的探索历史变成回放模拟器来改进搜索策略,作用在推理时的探索层;云知声的 RSI 则落在训练数据闭环,让模型参与造训练任务。两件事同名不同层,却说明同一个趋势:RSI 正从论文概念进入厂商的训练管线叙事。
对国产算力上的 Agent 采购方,市场上多了一个自述高分的选项;榜单和对比型号由厂商选定,实际成色仍需自建评测。公告把它定性为"从人工主导训练迈向模型参与自身演进",这句话是公司对自家路线的表述,不是行业已达成的状态。
据香港经济日报报道,公告发布后云知声股价 9月15日一度升逾 9%。
 AI 速览