9月22日消息,阿里巴巴在2026云栖大会主论坛发布世界模型 HappyOyster 2.0 Preview,给出物理规律、时空记忆与交互延迟三处改动,并宣布联合北大、南大等高校与合作伙伴共建世界模型的评测基准。同场更新的还有图像模型 Qwen-Image-3.1 与音乐模型 Happy Shrimp 1.1,下一代视频生成模型计划在 11 月发布。
HappyOyster 2.0 Preview 改了三处
改动集中在物理规律、时空记忆与交互延迟。物理规律上,演示视频里雪球飞出的轨迹、碰撞与飞溅符合真实世界的规律。郑波称,这不只是画面上像。
时空记忆方面,这一版把场景对象与运动历史映射到统一的三维空间,镜头与赛车视角变化后,周围场景保持原来的位置和形态。
交互延迟方面,这一版采用 AR diffusion 与 on-policy 训练方案,用户操作之后,环境反馈更快。
这版模型之外,阿里联合北大、南大等高校与合作伙伴共建世界模型的 benchmark 与 arena,目标是给这类模型建立统一的评估标准。评测基准的规模与组织形式没有披露。
同场更新的图像、音乐与视频线
图像模型 Qwen-Image-3.1 亮相,定位生产力级别的图像生成。演讲给出的场景包括服饰海报、电影分镜、学术原理图和中文小字排版,考察点是参考图复刻、编辑能力与信息组织。编辑侧,模型基于空间理解与人像 ID 保持,可以把一张自拍变成抱玩偶、线稿、杂志封面风格等多种结果,也可以生成可 360 度播放的完整全景图。
音乐模型 Happy Shrimp 1.1 给出四个提升方向:旋律的记忆点更强,人声唱法更多样,对创作意图与复杂指令的理解更强,多语言演唱的发音更清晰。按演讲口径,这个版本可以生成百余种曲风与十余种流行音乐类型,输出人声歌曲与纯音乐。
视频生成线的下一个节点在 11 月。郑波把这条路分成三个阶段:最早是 DiT 验证阶段,解决视频能不能生成出来;今年上半年进入多模态参考阶段,模型同时理解文字、图片、视频与音频;现在走向 Agentic Video,模型从生成素材片段转向理解创作目标,从一个想法拆解剧情与分镜。新版本的方向是更长、更可控、更完整、更智能。
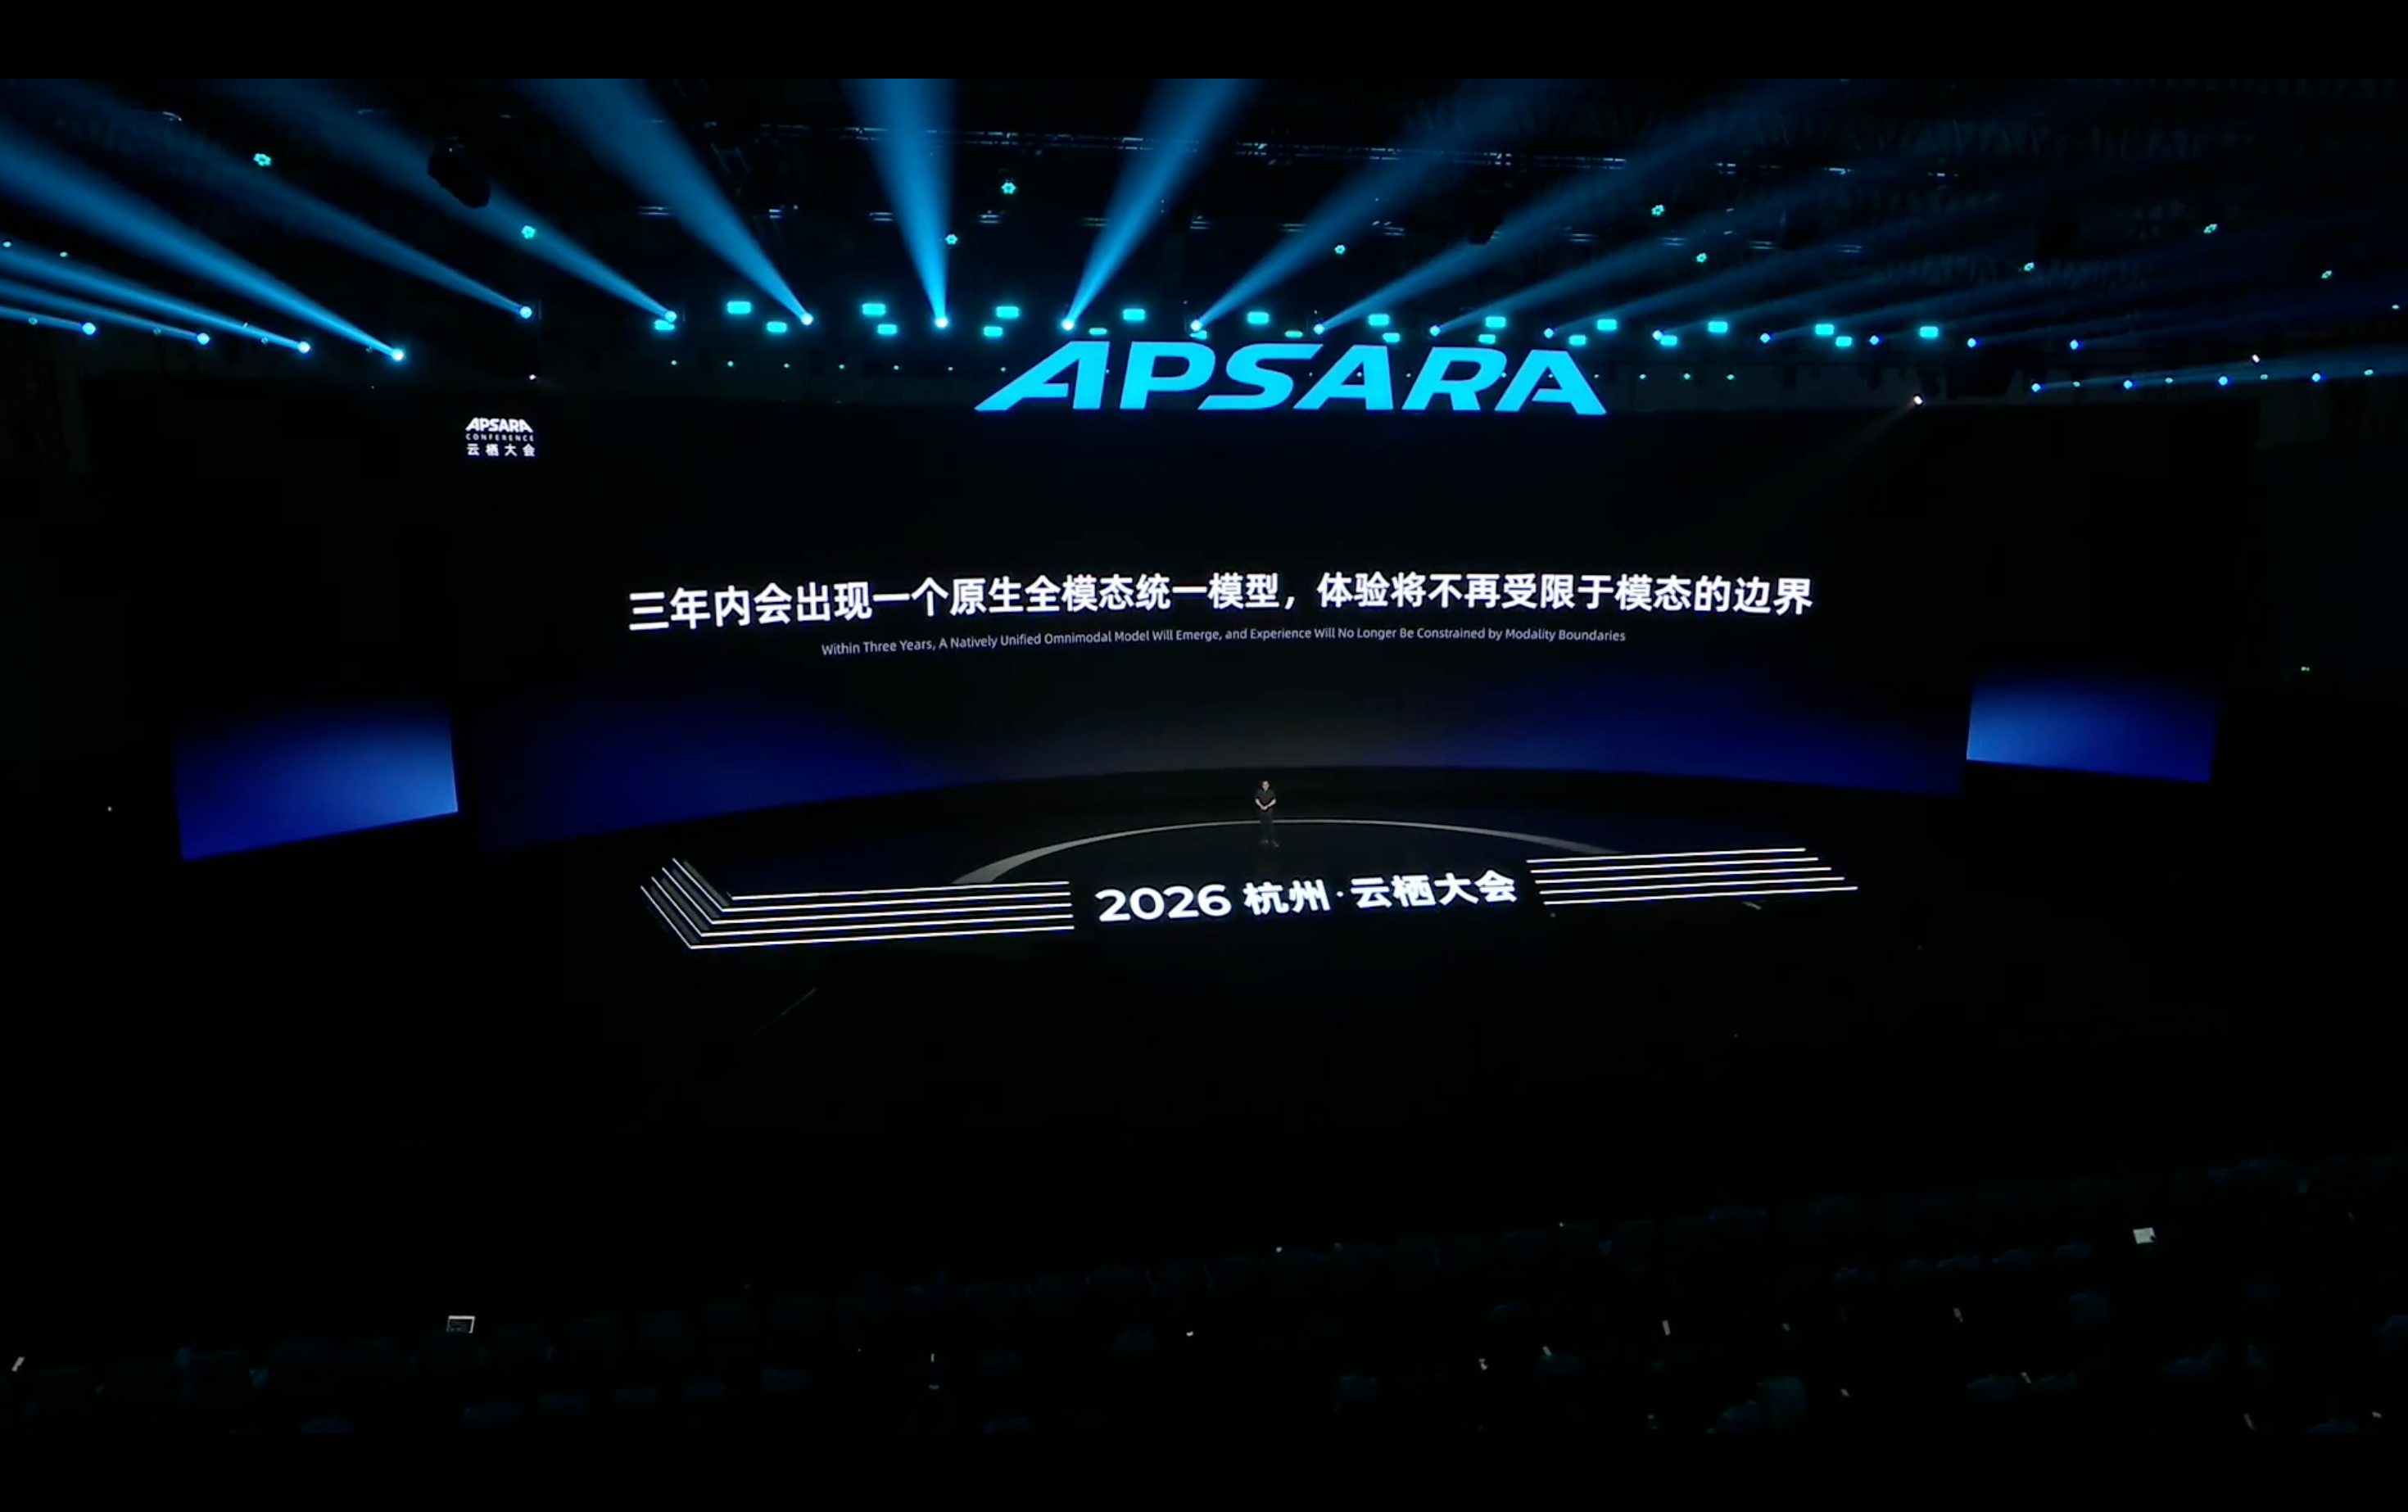
「三年内会出现原生全模态统一模型」
郑波把话说到两三年之后。他说,如果过两三年回头再看,今天这些按模态分开的模型很可能都是过渡形态,某种意义上的后训练模型。他认为三年之内会出现一个原生的全模态统一生成模型:一个模型就能生成图像、视频、音乐,也能理解世界。他的理由是,这不是几个模型能力的拼接,而是模型的原生能力,体验的生产将不再受限于模态的边界。
他引用的外部数据指向同一个方向。他提到 ACM 通信的一份研究,称目前人类识别 AI 生成内容的准确率平均只有 51.2%,与抛硬币接近;另有数据显示 63% 的视频营销人员在用 AI 视频工具,到 2030 年 AI 图像与视频生成的市场规模预计达到 608 亿美元。
这些改动的证据都在厂商一侧。这版世界模型没有公开的试用入口,也没有第三方实测。「三年内」是演讲方的判断,不是可核验的时间表。
 AI 速览