9月21日消息,阿里通义千问开源图像模型 Qwen-Image-2.1 的权重。视觉生成部分 7B 参数、32 层单流扩散 Transformer(Single-Stream DiT),文生图与图像编辑共用一套权重,支持生成和编辑带透明通道的 RGBA 图像,单次可接收 10 张参考图,默认 2048×2048、40 步推理,覆盖 2K 分辨率。与权重一同发布的还有两个提示词改写检查点,都是微调后的 Qwen3.5-VL 9B。 授权条件是这一版与前面几版最大的差别。此前 Qwen-Image 各版本的权重挂在 Apache 2.0 下,这一版改用 Qwen Research License,用途限于研究或评估,商用需要另行申请授权。
一版把生成和编辑合并的轻量模型
Qwen-Image 系列过去把生成和编辑分开发布,编辑能力单独出模型。Qwen-Image-2.1 把两条线并进同一模型,视觉生成部分仍是 7B 规模、32 层单流 DiT。文本编码交给 Qwen3-VL 8B,把文字指令和条件图像编码成统一表示;图像侧用 64 通道 RGBA 自编码器,16 倍空间压缩,这是输出透明通道的结构前提。
7B 只覆盖视觉生成部分。整条链路还包含 Qwen3-VL 8B 文本编码器和两个 Qwen3.5-VL 9B 改写检查点,官方没有给出全套权重的总参数量,也没有给出推理速度与显存需求。
模型默认 2048×2048、40 步,覆盖 1:1 到 9:16 七种比例。
权重发布当日,Diffusers、ComfyUI、vLLM-Omni、SGLang 和 LightX2V 五个推理框架宣布接入。SGLang 的适配代码在 9 月 17 日提交,覆盖 DiT、RGBA 自编码器、Qwen3-VL 条件注入与多参考图输入,20 日随版本合并。模型还通过 FlagOS 软件栈适配了多个国产芯片平台。
7B 怎么撑起多图编辑
轻量模型接收 10 张参考图,瓶颈在注意力计算。Qwen-Image-2.1 的解法是混合粒度注意力:文本部分(系统前缀和编辑指令)使用 token 级因果掩码,逐词做序列计算;图像生成部分使用 chunk 级双向掩码。输入图像与编辑指令作为静态上下文,在去噪首步计算一次并写入 KV 缓存,后续步骤复用。
按官方描述,这套机制的作用是提升推理效率、降低显存开销,官方没有给出加速比或显存占用的具体数字。它降低了每一步重新编码参考图的重复计算,而多图输入正是重复计算最重的场景。
硬件门槛方面,官方给出的显存受限路径是模型卸载,把部分计算放到 CPU 上执行;vLLM-Omni 一侧另有 FP8 量化、张量并行与 Ulysses 并行可选。社区论坛有早期用户称该模型能放进 12G 显存的显卡运行,但这是单条帖子,没有说明分辨率与步数,不足以当作通用的配置参考。
透明图:从生成到编辑
透明图像是这次更新的重点。官方在博客里交代了沿革:2025 年 12 月发布的 Qwen-Image-Layered 是专门支持透明图像生成的模型,2.1 把这套能力收进统一模型,由提示词决定输出普通图像还是带透明通道的图像。
落到用法上,提示词里写明要透明背景,模型输出的结果就带 alpha 通道,省掉先出图再抠图的工序。除单个主体,官方样例还包括由多个元素构成的组合素材;反向也成立,给一张普通 RGB 照片,模型把指定主体提取成 RGBA 图层,供后续合成复用。
透明素材生成后可以继续改。官方演示了两个方向:保留透明背景的前提下修改主体表情;修改透明图层里的文字,示例把「BLOOM」改成「Qwen-Image」。这两类修改对应设计与电商场景里的常见返工,活动名称换了但图案要留住,表情要调整但角色要能认出是同一个。
多图编辑与保真
编辑能力的另一部分是多图条件下的构图。官方样例覆盖三个场景:六张单人肖像合成一张合照、模特与衣服鞋子包帽子共五张图拼出完整搭配、十张家居图生成室内布置。
局部编辑提供三种指定方式。圈选用不同颜色的圆圈同时标出多个区域,官方示例的指令是去掉蓝色圈的金属手表、把红色圈的头发改成黑色、把绿色圈替换成灰色短袖亚麻睡衣。涂抹适合标出新增对象的位置,示例在鲨鱼右侧的白色涂抹区域加入一名潜水员。前两种方式会遮盖原图内容,因此模型也接受原图与独立掩码两张图作为输入,由掩码指定编辑范围。
保真方面,官方给出的方向是保存人像的面部特征和商品文字、纹理、形态。这些效果目前只有官方展示与媒体自测,缺少可比较的第三方基准。
评测分数与它的边界
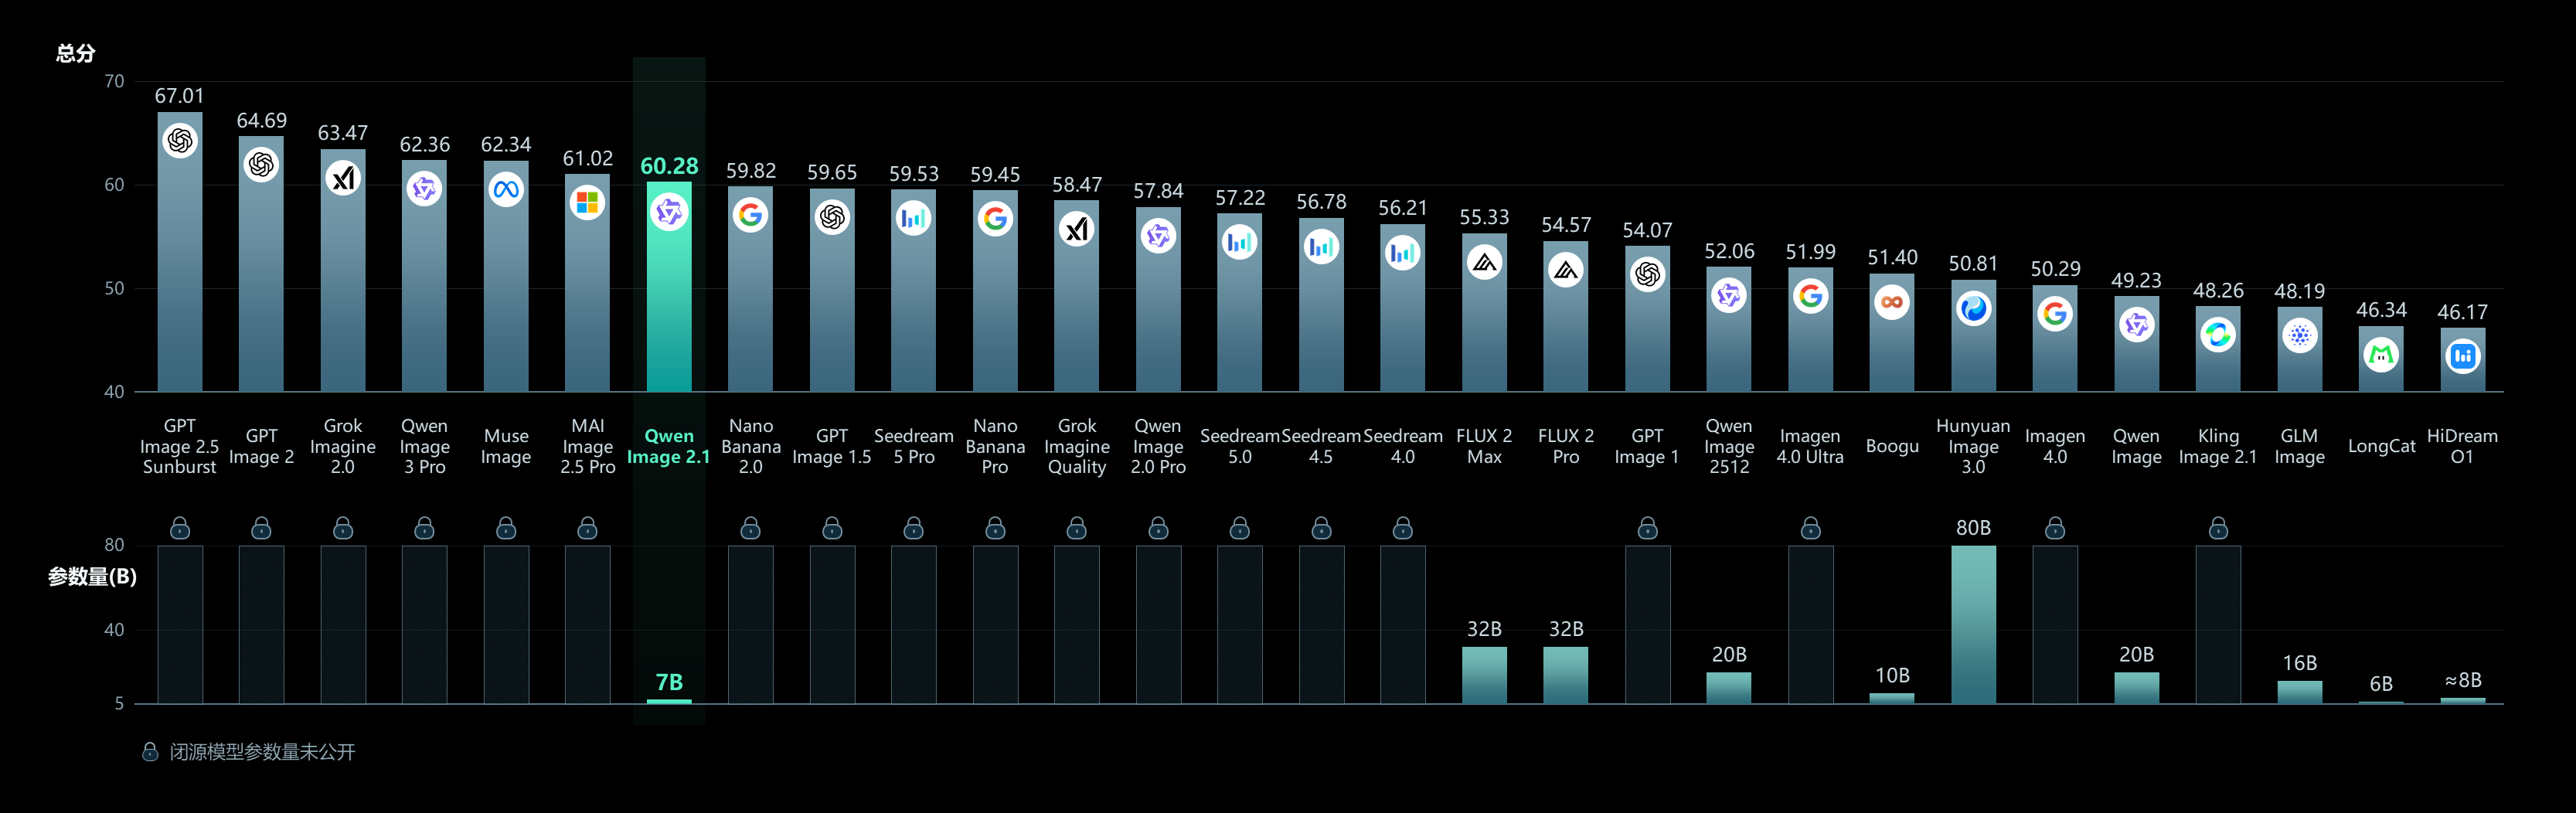
官方在博客中放出的 Qwen-Image-Bench 对比图显示,Qwen-Image-2.1 总分 60.28。这张图收了 24 个条目,60.28 排第 7;与它同源的数据集榜单只收 18 个条目,因此两处的名次不能对照着看。同一张图里,排在前六位的是 GPT Image 2.5 Sunburst 67.01、GPT Image 2 64.69、Grok Imagine 2.0 63.47、Qwen Image 2.5 Pro 与 Muse Image 2.5 Pro 62.34、MAI Image 2.5 Pro 61.02。60.28 在图中标注了参数量的模型里最高。 这张图也标出了参数规模:Qwen-Image-2.1 为 7B,FLUX.2 Max 与 Pro 为 32B,HunyuanImage 3.0 为 80B,GLM Image 为 16B;Seedream 4.5 与 4.0 在图中没有标注参数量。
基准由 Qwen 团队自建,Qwen-Image-Bench 数据集已经公开,包含 5 个一级维度和 56 个三级评估维度、1000 条双语提示词。榜单分数由 Q-Judger 依据中文提示词的生成结果计算,英文提示词的结果尚未公布。
数据集内的排行榜第 1 名是 GPT Image 2(64.69),Qwen Image 2.0 Pro 以 57.84 排在第 5,2.1 尚未进入榜单。2.1 的分数来自官方博客配图,尚无第三方复现,也没有第三方对这套基准本身做过独立审计。参数对比和排名都出自厂商口径,宜按此理解。
开放权重,商用要另谈
这版权重挂在 Qwen Research License Agreement 下,协议发布日期为 2026 年 9 月 20 日。第 2(a) 条授予的使用、复制、分发和修改权利写明「FOR NON-COMMERCIAL PURPOSES ONLY」,第 1(i) 条把非商业定义为「仅供研究或评估用途」。第 2(b) 条要求商业用途另行取得许可,申请邮箱在协议中给出。
这与该系列此前的授权方式不同。Hugging Face 上的 Qwen-Image 仓库标注 Apache 2.0,Qwen-Image-Edit、Qwen-Image-Edit-2509、Qwen-Image-Edit-2511、Qwen-Image-Layered 等版本同样如此。Qwen-Image-2.1 连同同日发布的两个提示词改写检查点,都改用了研究许可。
协议还规定,用该模型或其输出训练、微调出分发的模型时,需在产品文档中标注「Built with Qwen」或「Improved using Qwen」;许可方为杭州通义实验室技术有限公司,管辖法律为中国法律,专属管辖地为杭州市的人民法院。
对使用者的实际影响落在交付环节。评估、跑分、写教程、个人项目都在授权范围内;把输出用于客户交付、商品图、付费产品,需要先确认是否已取得商业授权。此前基于 Apache 2.0 做商业部署的团队,在这一版上需要重新确认授权。
 AI 速览