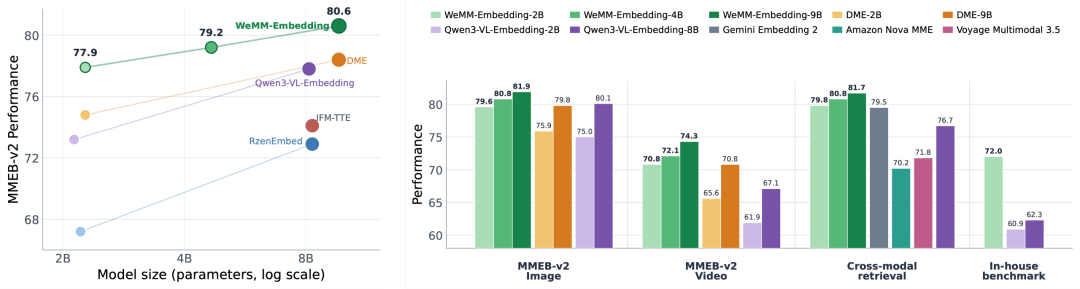
9月4日消息,微信视觉团队宣布开源自研多模态嵌入模型 WeMM-Embedding,提供 2B、4B、9B 三个版本,支持文本、图像、视频、视觉文档以及任意交错的多模态输入。官方公布的成绩显示,9B 版本以 80.6 分位列 MMEB-v2 榜单第一;2B 版本以四分之一的参数规模取得 77.9 分,以 0.1 分优势超过此前领先的 8B 开源模型 Qwen3-VL-Embedding-8B。该模型已在微信搜索与推荐系统中全量上线,日调用量达十亿量级。
开源了什么:三档规模,公开榜单第一
WeMM-Embedding 是微信线上每天调用十亿量级的通用多模态嵌入模型,作用是把文字、图片、视频映射到同一个向量空间,让搜索和推荐可以通过向量相似度跨模态找内容。
官方公布的成绩覆盖三组基准。在包含 78 个数据集的 MMEB-v2 上,9B 版本 80.6 分位列第一,在图像、视频和视觉文档任务上分别取得 81.9、74.3 和 83.3 分;4B 版本 79.2 分;2B 版本 77.9 分,超过 Qwen3-VL-Embedding-8B 的 77.8 分。在覆盖 190 个任务的 MMEB-v3 上,9B 与 2B 分别取得 59.5 和 56.0 分,2B 在工具检索、GUI 检索、记忆检索等文本检索与智能体任务上为所有对比基线中的最高分。在 12 项公开跨模态检索基准上,三个版本平均得分 79.8、80.8、81.7,其中 2B 超过所有对比的开源基线,与专有模型 Gemini Embedding 2 表现相当。 统一序列:图文视频进同一条链路
架构上,WeMM-Embedding 没有采用图像、文本各自编码再对齐的双编码器路线,而是基于 Qwen3.5 多模态架构作为统一骨干。输入模型时,文字转为文本 token,图片和视频转为视觉 token,按内容的原始顺序排列成一条完整的多模态序列,对应朋友圈、公众号文章这类图文交错的真实内容。
序列末尾加入一个专门的 <embedding> token,读取完整段内容后,其最后一层的隐藏状态经过归一化,就是这段内容的向量表示。token 的位置可以复用:放在视频后得到纯视频表示,加入字幕文本后再放一个,又得到视频与文本的联合表示。一次前向计算,可以同时提取多个层次的内容表示。
两阶段训练加蒸馏:2B 超过 8B 的来源
训练分两阶段。第一阶段用数亿规模的多模态数据建立广泛的表示能力,覆盖自然共现的图文、视频文本、内容描述、搜索匹配、分类、多模态问答等任务;针对同一 batch 内同源内容重复导致的错误负例,加入重复感知掩码,把可疑负例屏蔽掉。官方称,围绕同一任务组织 batch、提供更有效的负样本,是一阶段影响最大的设计之一。
第二阶段从"见得广"转向"分得细":对数据做语义重采样与质量过滤,降低高频语义的重复曝光,补充困难负样本。查询红色连衣裙时,粉色连衣裙比汽车更能逼出模型对颜色和属性的分辨力。在此基础上,9B 模型担任教师,向 2B 和 4B 蒸馏。教师提供的不是单个正确答案,而是候选之间完整的相似度关系:第一名与第二名差多少、哪些候选不正确但仍相关。消融实验显示,嵌入蒸馏为 2B 带来 0.9 分提升,第二阶段整体优化累计带来 2.2 分提升。
套娃表示:精度与成本之间加一个旋钮
大规模检索场景里,向量要长期存储、反复检索,维度越高成本越高。WeMM-Embedding 采用套娃表示学习(Matryoshka Representation Learning,MRL):训练时同时考核 64、128、256、512、1024 等多个截断长度,让信息按重要程度在维度上排列,靠前的维度概括核心语义,靠后的补充细节。
推理时计算一次完整向量,业务按成本截取前若干维即可,无需重新训练。官方数据显示,2B 版本用 256 维仍能保留完整维度下 98.7% 的图像和视频性能,向量长度只有 2048 维的八分之一。海量召回用短向量粗筛,候选集缩小后再用高维精排。
从榜单到十亿量级调用
在微信内部 26 项任务基准上,2B 版本相比同规模基线从 60.9 提升至 72.0,分类、搜索、跨域匹配、文章相关、视频相关五类任务均提升。模型已部署在视频号、直播、公众号、电商与朋友圈的推荐与搜索系统中,承担候选检索、排序特征构建、用户序列建模和跨域内容理解,完成 14 次在线 A/B 测试后全量上线,长尾内容与新发布内容的提升最明显。
模型权重、推理代码与评测工具已全部开放:下载代码、准备一张图或一段视频、运行推理脚本三步即可生成向量,推理时可指定输出维度。项目地址见文末。
对多模态检索的开发者来说,这份开源值得留意的地方不在单一榜单第一,而在三件事的组合:公开榜单成绩、蒸馏加 MRL 的降本路径,以及日调用十亿量级的真实业务背书。榜单成绩可回查公开榜单;内部业务数据为官方自述,尚无第三方复现。
 AI 速览