AI 速览
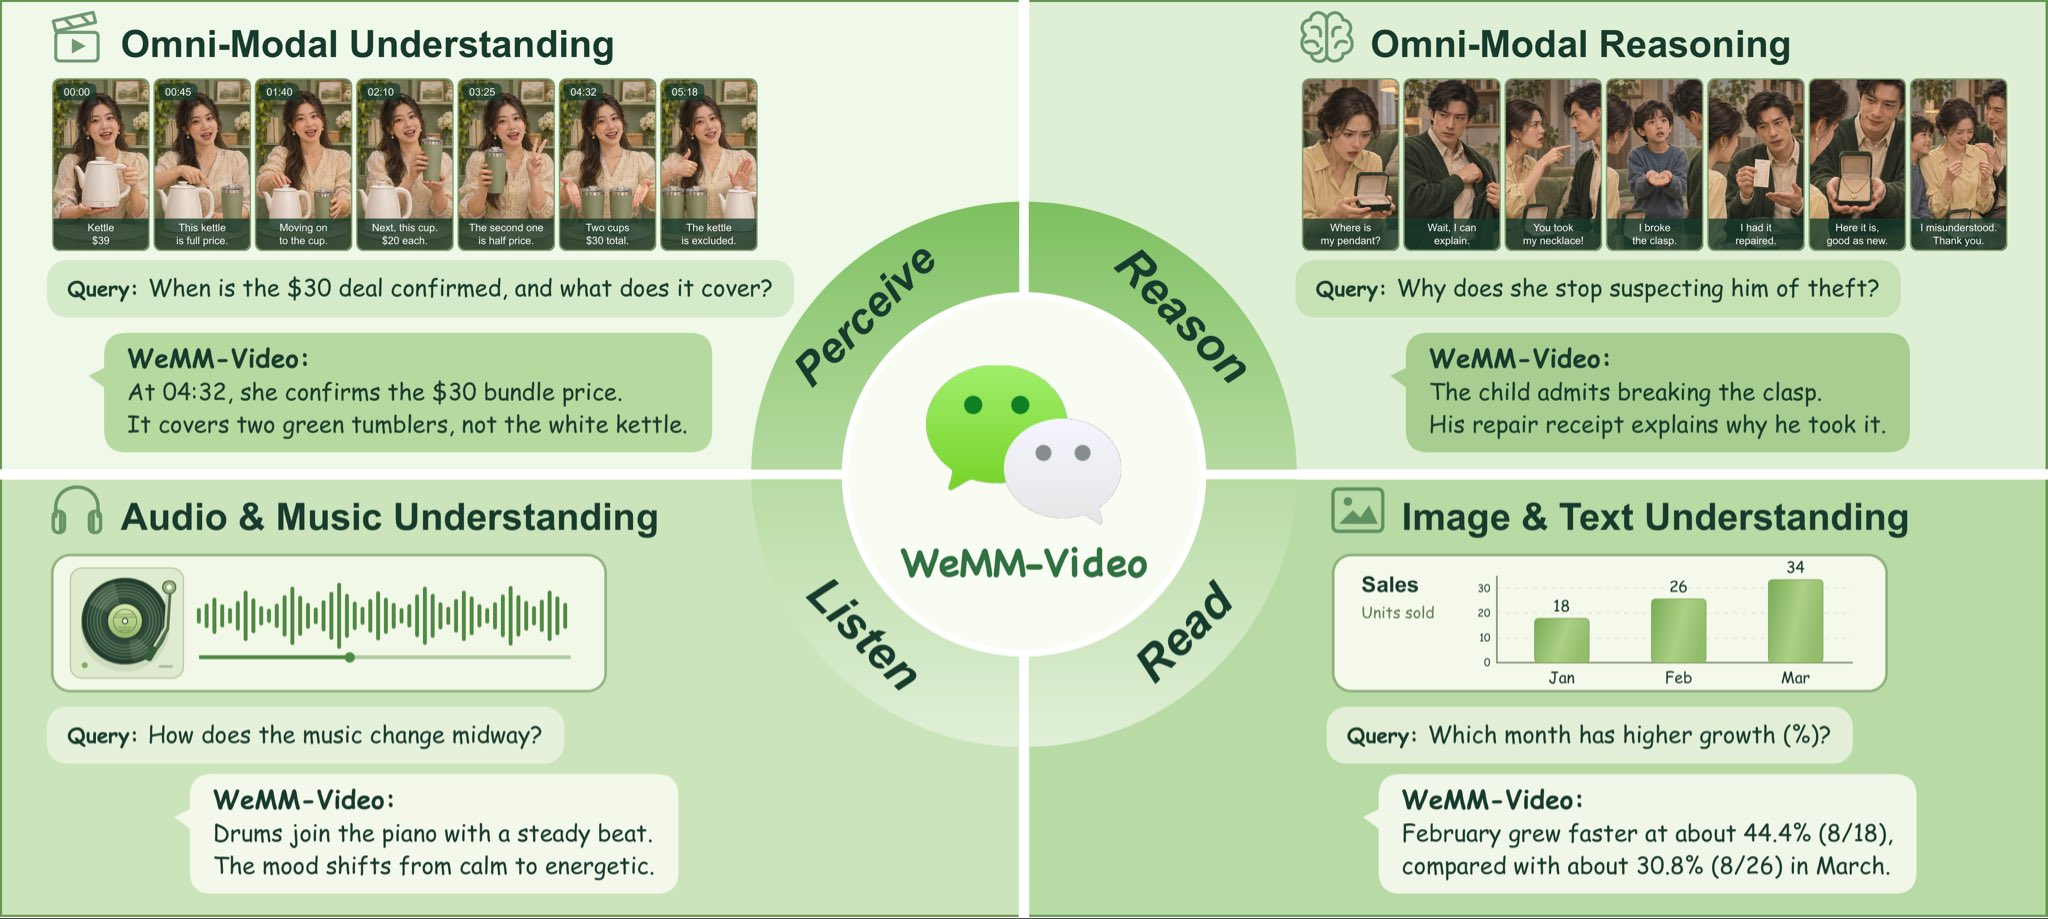
腾讯微信视觉团队开源全模态视频模型 WeMM-Video,适合处理带原声视频的开发者参考。 核心事实 - 发布主体:腾讯微信视觉团队开源全模态模型系列 WeMM-Video,支持文本、图像、音频和视频输入并以文本作答 - 模型规格:含 2B、4B、9B 稠密模型及 35B-A3B 混合专家架构,四款均支持中英文 - 训练数据:整个系列使用约 1.2 万亿多模态 Token 训练,音视频联合数据占 45.4% - 能力设计:可同时读取画面和原始音轨,提供直接作答的 Instruct 模式与多步推理的 Thinking 模式 - 开源内容:已公开模型权重、量化版本及评估复现流程,含 BF16、FP8、AWQ、GGUF、NVFP4 格式,模型卡标注 Apache 2.0 许可 避坑提示 - 分数来源:旗舰版接近 Gemini 3.0 Flash 为官方自测结果,来自团队技术报告,并非第三方复测 - 单项差异:Daily-Omni 上以 83.4 分高于 Gemini 的 82.4 分,但 MMOU 测试中以 74.5 分落后 Gemini 的 84.7 分 - 效果边界:论文分数不能直接代表直播电商、短剧等业务中的实际效果 关键数据 - 参数规模:35B-A3B 共 350 亿参数,每次推理激活约 30 亿参数 - 基准成绩:Video-MME 带音频测试中 Thinking 模式得 86.4 分,Gemini 3.0 Flash 为 88.6 分,Seed2.0-Mini-0428 和 Qwen3.5-Omni-Flash 分别为 83.6 分和 79.3 分 - 权重体积:35B-A3B 的 BF16 权重文件约 67.39 GiB 价值点 对有音视频理解需求的开发者,这是一份含权重、量化版本和复现流程的开源方案,可直接下载测试对象自测。