2026年3月,理想汽车MindVLA团队与国创决策智能技术研究所联合发布重磅研究成果——「硬件协同设计扩展定律」(Hardware Co-Design Scaling Laws),以数学化、可预测的方式解决了端侧大模型部署的核心痛点:如何在车载芯片等资源受限设备上,同时实现模型高精度与低延迟。这一理论突破不仅让同等算力下模型智商提升19.42%,更将架构研发周期从数月压缩至一周,标志着理想汽车从车企向「智能驾驶+具身智能」AI公司的彻底转型。
一、端侧AI的核心困境:大模型与硬件的「适配鸿沟」
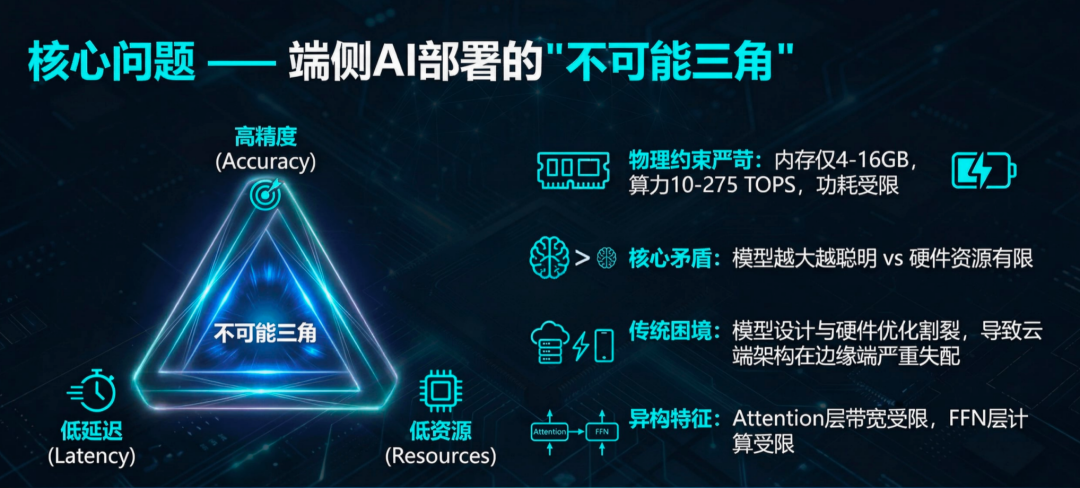
智能驾驶、具身智能等场景长期面临「不可能三角」难题:模型越聪明需越大参数量,而车载芯片受功耗、散热、内存限制,无法承载云端级模型。传统模式中,模型设计与硬件优化割裂,如同「给F1引擎配卡车底盘」,导致100TOPS算力芯片实际效能利用率仅30%,云端10毫秒完成的推理任务在车载端可能延迟至300毫秒,对自动驾驶而言相当于「高速盲开数米」。
为破解这一困局,理想团队跳出「先造模型再适配硬件」的传统思路,提出「软硬协同设计」理念——在模型架构设计之初即深度融入硬件参数,实现算法与硬件的原生匹配。
二、核心创新:三大支柱构建端侧AI scaling law
该定律通过「损失建模+延迟预测+帕累托优化」三大核心组件,构建起可量化、可计算的端侧大模型设计框架,无需实际训练即可算出最优架构。
1.损失缩放定律:精准预测模型「聪明度」
团队训练170个不同架构的Transformer模型(覆盖Dense与MoE两类,层数4-48层、宽度256-4096、MoE专家数1-64),每个模型训练100亿token,最终拟合出精度预测公式。该公式包含深度项、稀疏驱动项、基础容量项与KV-cache项,能根据模型超参数直接预测验证损失,拟合精度达R²=0.975(训练集)与R²=0.952(验证集),实现「输入设计方案,算出模型智商」。
2.Roofline延迟模型:预判硬件运行速度
基于经典Roofline模型,团队从第一性原理推导Transformer端侧推理延迟的完整数学表达,首次系统建模KV缓存、MoE路由等大模型特有负载对车载SoC内存子系统的影响。通过芯片峰值计算能力(FLOPS)与内存带宽两大核心参数,可精准判断任务是「计算受限」还是「带宽受限」,20分钟内即可评估5万+种架构配置的延迟表现,解决了传统测试效率低下的问题。
3.PLAS框架:帕累托最优架构搜索
开发帕累托最优LLM架构搜索框架(PLAS),将损失建模与延迟预测结合,在芯片算力、带宽、内存约束下,自动锁定「最低损失+最低延迟」的最优解。这些最优解构成「帕累托前沿」,突破了「速度与精度不可兼得」的物理极限,且在不同约束下存在闭合解,无需训练即可直接计算得出。
三、三大关键定理:覆盖全场景约束
团队通过数学推导,给出不同硬件约束下的架构设计准则:
延迟约束(内存充裕):MoE专家数越多、每次激活越少越好(「免费午餐」效应)。自动驾驶sub-50ms延迟场景下,应采用top-1路由,内存允许范围内最大化专家池,新增专家不增加延迟却能提升模型容量;
内存约束(速度够用):模型越宽,MoE应越稀疏(宽度每翻倍,最优激活率下降2.3倍)。例如2B参数模型推荐16个专家激活2个,500M参数模型需更密集配置;
双重约束(常见场景):预填充与解码阶段分别对应精确闭合解,适配端侧设备普遍面临的内存与延迟双重压力。
四、颠覆性发现:重构端侧模型设计范式
研究推翻多项传统认知,揭示端侧最优架构的核心特征:
MoE全面主导:端侧batch=1场景下,100%帕累托最优架构为MoE,最优配置多为8-16个专家激活1-2个;
宽而浅优于深而窄:模型深度通常<20层,宽度显著增加,内存带宽与缓存效率比理论TOPS更关键;
FFN激进压缩:最优FFN扩展比远低于传统4×,甚至可<1×,需芯片支持灵活配比;
量化增益亚线性:INT8量化仅实现1.3-1.6倍加速,非线性操作是瓶颈,需硬件原生支持混合精度计算;
阶段差异化配置:预填充偏好少专家,解码偏好最大化专家,芯片需支持动态资源分配。
五、实测验证:19.42%精度提升+效率革命
在NVIDIA Jetson Orin端侧平台的测试中,协同设计架构表现碾压行业基准:
精度突破:与Qwen2.5-0.5B(通义千问5亿参数端侧模型)相比,同等延迟下困惑度从63.14降至50.88,降幅达19.42%,训练全程保持领先优势;
跨平台泛化:在Jetson Thor等不同硬件上均验证了定律的普适性;
效率飞跃:架构选型流程从「训练-测试-调优」的数月周期,简化为「输入硬件参数→计算最优架构→小规模验证」的六步流程,耗时仅一周。
六、产业价值:从理论到落地的技术闭环
该定律并非单纯理论突破,而是与理想汽车全栈技术布局深度绑定:
适配自研芯片:为即将量产的5nm车规芯片马赫100量身定制,其数据流架构与定律适配后,单颗有效算力达英伟达Thor-U的3倍,双芯片配置有效算力达5-6倍;
构建技术生态:形成「马赫100芯片+协同设计定律+星环OS+MindVLA模型」的完整闭环,芯片未量产即可通过定律算出最优VLA架构;
行业开源共享:计划开放代码与评测协议,覆盖汽车、机器人、IoT、移动端等全场景,推动端侧AI从「堆算力」向「榨算力」转型。
七、行业意义:定义端侧AI新规则
如果说OpenAI的Scaling Law回答了「云端模型为何越大越聪明」,理想的协同设计定律则解决了「端侧设备如何让模型最聪明」。在摩尔定律放缓的背景下,这一突破标志着AI发展进入「精细化利用算力」的新阶段——不靠芯片晶体管翻倍,而是通过数学化设计释放硬件潜力。
对智能驾驶行业而言,该定律让车载模型在延迟<100ms的约束下实现精度跃升,紧急场景中可更早感知风险、更快避险;对整个端侧AI领域,它提供了首个可操作的科学方法论,证明最优架构必须与硬件深度绑定,为「算法定义芯片」提供了坚实理论支撑。理想汽车用底层基础科学突破,奠定了智能驾驶下半场的领跑优势。
 AI 速览