智谱AI于2026年2月正式开源GLM-OCR,一款仅0.9B参数的轻量级多模态OCR模型。开源不到两个月,该模型在Hugging Face上已获得超360万次下载。3月12日,团队进一步公开了完整技术报告,详细披露了模型架构、训练策略和基准测试细节。本文将深入解读GLM-OCR的核心技术亮点,并与百度千帆OCR、DeepSeek-OCR等同期竞品进行全面对比。 GLM-OCR是什么?
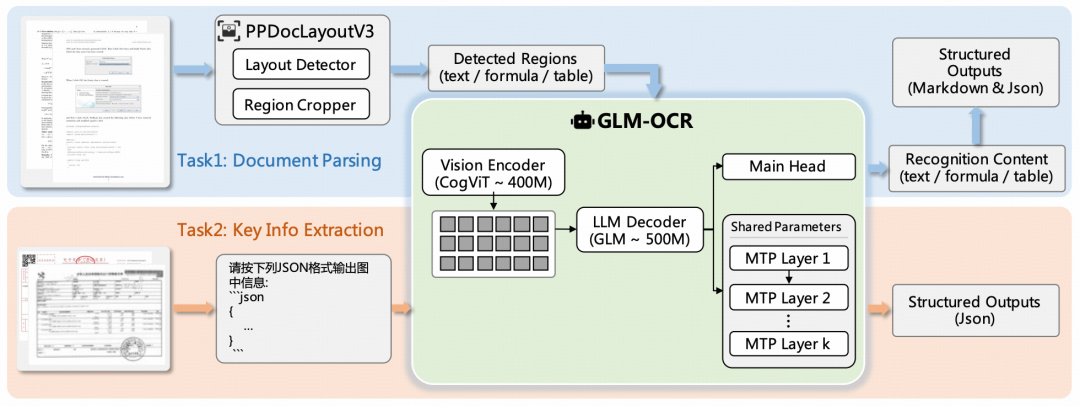
GLM-OCR是智谱AI推出的专业级文档理解模型,基于GLM-V编码器-解码器架构构建。与动辄数十亿甚至上百亿参数的通用视觉语言模型不同,GLM-OCR将参数量控制在0.9B(视觉编码器CogViT约0.4B + GLM解码器约0.5B),却在多项权威文档解析基准中刷新了最优成绩。
该模型核心定位是"小尺寸、高精度",面向企业级文档数字化场景,涵盖文本识别、表格解析、公式提取、关键信息抽取、印章识别、手写体识别等任务。
核心技术亮点
1. 两阶段流水线:版面分析 + 并行识别
GLM-OCR在技术报告中指出,小参数模型在直接处理复杂版面文档时容易产生幻觉和重复生成。为此,团队采用了"先分析版面、再并行识别"的两阶段方案:第一阶段使用PP-DocLayout-V3进行版面检测,将文档分解为段落、表格、公式等语义区域;第二阶段由GLM-OCR核心模型对各区域独立处理,最后通过合并模块恢复阅读顺序,输出Markdown或JSON格式。
这种模块化设计的好处在于:各区域可以并行处理,大幅提升推理效率;同时将复杂版面问题拆解为多个简单子问题,降低了幻觉风险。
2. 多Token预测(MTP):更快也更准
传统自回归解码每次只生成一个token,对长文档而言效率较低。GLM-OCR引入了多Token预测机制,在主预测头之外附加了k个共享参数的辅助预测头,每步可同时预测多个后续token。
这一机制带来两大收益:其一,显著减少解码步数,降低推理延迟;其二,促使模型进行更长远的"规划",在表格标签、Markdown语法等具有强局部依赖性的结构化输出中尤为有效,减少了标签断裂和格式错乱。
3. 四阶段渐进式训练
GLM-OCR的训练分为四个阶段逐步推进:
第一阶段是视觉编码器训练,使用数百亿图文对数据,采用MIM与CLIP双目标函数,并通过知识蒸馏增强特征提取能力。
第二阶段是视觉-语言预训练,将CogViT接入GLM-0.5B解码器,在图文、文档解析、视觉问答等数据上联合训练,同时引入MTP目标。
第三阶段是监督微调(SFT),在精心整理的OCR数据集上进行任务特定优化。
第四阶段是强化学习(RL),采用GRPO算法,通过任务感知的奖励函数提升结构化输出的可靠性。这一阶段的加入是GLM-OCR区别于多数开源OCR模型的关键——强化学习让模型在格式一致性和边界case处理上有了明显提升。
4. 统一框架支持文档解析与关键信息提取
GLM-OCR将文档解析和关键信息提取(KIE)统一在同一个生成式框架中。两者都被表述为"以视觉输入为条件的结构化生成问题",仅在预处理策略和提示词设计上有所差异。文档解析走版面检测 + 区域识别的完整流水线,而关键信息提取则直接将完整文档图像和任务提示词输入模型,由模型隐式定位相关区域并输出JSON格式结果。
基准测试表现
公开基准:多项第一
在OmniDocBench v1.5文档解析榜单中,GLM-OCR以94.62分位列综合第一,超越PaddleOCR-VL-1.5(94.50)、DeepSeek-OCR-v2(91.09)、Gemini-3 Pro(90.33)和Qwen3-VL-235B(89.15)。 细项来看,GLM-OCR在表格识别上表现尤为突出:Table TEDS得分93.96,Table TEDS-S得分96.39,均为最优。在OCRBench纯文本识别中得分94.0,在公式识别UniMERNet上得分96.5,在关键信息提取Nanonets-KIE上得分93.7——这些都是开源模型中的最好成绩。
内部基准:真实场景优势明显
团队还在六大真实业务场景上进行了内部评测。GLM-OCR在印章识别上得分90.5,远超第二名dots.ocr的63.0;在多语言文本识别上得分69.3,领先PaddleOCR-VL-1.5的54.8;在票据关键信息提取上得分94.5,甚至超越了GPT-5.2的83.5。
这些内部测试结果验证了GLM-OCR不仅在学术基准上表现优异,在噪声多变的真实OCR部署场景中同样具备强大的泛化能力。
与同期竞品的对比
2026年初,国产OCR模型迎来一波集中开源潮。除GLM-OCR外,百度千帆OCR(Qianfan-OCR)、DeepSeek-OCR-v2、PaddleOCR-VL-1.5等模型也先后发布。以下是主要差异:
GLM-OCR(0.9B) 走"极致轻量 + 专项优化"路线,参数最小却综合性能最强,特别适合边缘部署和高并发场景。API成本仅为传统OCR方案的十分之一,每百万token 0.2元。
百度千帆OCR(4B) 走"端到端统一架构"路线,将文档解析、版面分析和文档理解整合在单一模型中,支持192种语言。创新性的"Layout-as-Thought"机制让模型在思考阶段先生成版面分析结果,再输出最终内容。在OmniDocBench v1.5上得分93.12,略低于GLM-OCR。不过千帆OCR的优势在于多语言覆盖更广、端到端架构更简洁,且完全基于百度自研昆仑芯P800训练。
DeepSeek-OCR-v2(3B) 走"极致压缩效率"路线,核心创新是Visual Causal Flow(视觉因果流),能用极少的视觉token实现高精度OCR。单台A100每天可处理超20万页,在大规模批量处理场景中有明显优势。OmniDocBench v1.5得分91.09,精度略低但效率极高。
PaddleOCR-VL-1.5(0.9B) 同为轻量级方案,在OmniDocBench v1.5上得分94.50,与GLM-OCR不相上下。优势在于支持100多种语言、对不规则版面(竖排文字、弯曲扫描件等)处理更为稳健,且有飞桨生态的完整工具链支持。
总体而言,如果追求最高精度和最低部署成本,GLM-OCR是当前的最优选择;如果需要广泛的多语言支持,千帆OCR和PaddleOCR更合适;如果场景是超大规模批量处理,DeepSeek-OCR-v2的token压缩能力则更具性价比。
部署方式与使用指南
GLM-OCR提供了从云端到边缘的多种部署选项:
云端API:通过智谱开放平台调用MaaS API,无需GPU。输入输出统一定价,每百万token仅0.2元,1元即可处理约2000张A4扫描图片。
vLLM部署:适合生产环境的高并发推理。安装transformers后执行vllm serve zai-org/GLM-OCR即可启动服务,开启MTP可进一步提升推理性能。
SGLang部署:另一高性能推理框架选项,同样支持MTP加速。
Ollama部署:适合本地开发测试和边缘设备,量化后仅需约1.5GB显存即可运行。
此外,GLM-OCR提供了完整的Python SDK,支持一行命令完成端到端文档解析。3月12日新增的Skill模式更是做到了pip install glmocr + 设置API Key即可使用,无需GPU和复杂配置。
如需针对特定领域进行适配,GLM-OCR还支持通过LLaMA-Factory框架进行微调,教程已发布在官方GitHub仓库中。
当前局限性
技术报告也坦诚指出了GLM-OCR的几项局限:两阶段流水线存在误差传播风险,版面检测不准确会影响下游识别;跨页依赖和不规则多栏结构可能导致阅读顺序重建不完善;在极低分辨率、严重失真文档或训练语料中代表性不足的语言上可能出现性能下降;作为生成式模型,在换行和空白符处理上仍有轻微随机波动。
相关链接
- 技术报告:https://arxiv.org/pdf/2603.10910
- GitHub:https://github.com/zai-org/GLM-OCR
- Hugging Face:https://huggingface.co/zai-org/GLM-OCR
- API文档:https://docs.bigmodel.cn/cn/guide/models/vlm/glm-ocr
 AI 速览