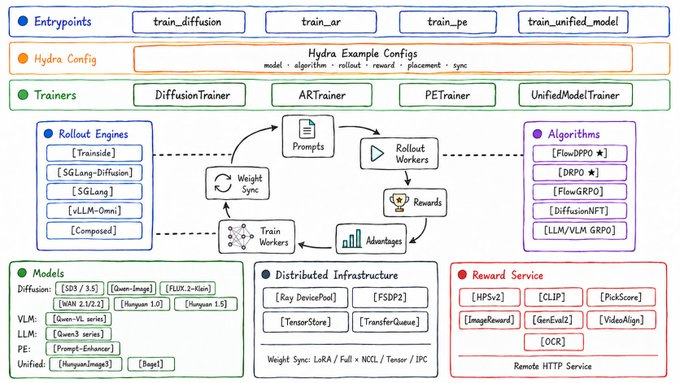
给扩散模型做RLHF,和给LLM做RLHF,本质上是两套完全不同的工程体系。一个处理离散token、一个处理连续去噪轨迹,优化算法不通用、训练管线不互通、奖励信号维度不一致。当业界开始尝试将理解与生成统一到一个模型中时,这个问题变得更加尖锐——你需要一个RL循环同时驱动文本推理和图像生成。腾讯混元团队开源的UniRL,就是为了解决这个问题而设计的统一强化学习基础设施,同时推出了DRPO和Flow-DPPO两种新算法。 背景:为什么统一多模态模型需要专用RL框架
2025年以来,统一多模态模型(Unified Multimodal Models)成为一条明确的技术路线。Show-o、Janus、EMU3、Qwen-Image等模型将文本理解、视觉理解和图像生成整合到单一架构中,不再为每个任务单独训练模型。
但预训练只是起点。要让这些模型真正对齐人类偏好、提升推理质量、改善生成效果,需要后训练阶段的强化学习。问题在于,现有RL工具链是按模型类型纵向切割的:LLM/VLM侧有GRPO、PPO、DPO等成熟方案,扩散模型侧有DDPO、Flow-GRPO、DanceGRPO、MixGRPO等专用算法,但两套体系之间几乎没有打通。
统一多模态模型同时包含语言模型(LM)组件和扩散/流匹配模型(DM)组件。LM处理离散token序列,DM处理连续去噪轨迹。两者的动作空间、策略参数化方式和梯度计算路径完全不同。UniRL-Zero等早期工作定义了统一模型RL的六种场景,但缺乏一个可复用的工程级框架将这些场景的训练统一起来。
UniRL要做的正是这件事:提供一个横跨LLM/VLM、扩散模型、流匹配模型和统一多模态模型的强化学习基础设施。
UniRL框架定位与核心设计
UniRL由腾讯混元团队开发并开源(GitHub: Tencent-Hunyuan/UniRL,MIT协议),定位为统一多模态模型的RL训练基础设施。它不是一个特定的算法,而是一个框架——在这个框架上可以实现和切换多种RL算法,面向不同类型的模型和任务。
从公开信息来看,UniRL的核心设计目标包括三个层面。
第一,统一动作空间。在一个RL循环中同时处理LM的离散token动作和DM的连续去噪动作。UniRL-Zero等前期工作已经探索了将两者形式化为联合策略优化问题的方法——LM部分用标准策略梯度,DM部分将去噪步骤建模为增广MDP中的转移——UniRL在工程层面将这一理论落地为可训练的管线。
第二,算法可插拔。框架内置多种RL算法,包括此次新推出的DRPO和Flow-DPPO,以及已有的GRPO、Flow-GRPO等。研究者可以根据任务特性选择算法,而不用每次从头搭建训练管线。
第三,多场景覆盖。支持纯文本推理、多模态理解、文生图、图像编辑、CoT增强生成、生成反思等多种RL场景,对应UniRL-Zero定义的六大统一模型RL场景。
DRPO:解决GRPO的"过度思考"问题
DRPO(Decoupled Reward Policy Optimization,解耦奖励策略优化)是UniRL框架内置的新算法之一,已被ICLR 2026接收。
GRPO(Group Relative Policy Optimization)是当前最主流的RL算法之一,DeepSeek-R1等推理模型的成功很大程度上依赖于它。GRPO的核心机制是:对同一问题采样一组回答,计算组内相对优势(group-relative advantage),用优势值加权更新策略。 但GRPO在处理多目标奖励时有一个结构性缺陷。以"正确性+简洁性"双目标为例:当一个正确但较长的回答被长度惩罚扣分后,其总奖励可能低于组内平均值,导致优势值变为负数。这意味着GRPO会主动抑制这个正确回答——即便它的推理完全正确,只是表述较长。
结果是模型陷入两难:要么追求简洁但牺牲准确率,要么保持准确但无法缩短推理链。实验中,直接给GRPO加长度奖励会导致显著的性能下降。
DRPO的解法是将正确回答和错误回答的学习信号彻底解耦。正确回答的奖励只在正确组内归一化,不受错误回答的干扰。长度惩罚可以按比例缩减正确回答的正向信号,但永远不会把它推入负值区间。错误回答则在负样本组内独立处理。
DRPO在数学推理基准上的实测数据显示,在Qwen2.5-1.5B和7B模型上,DRPO相比加入长度奖励的GRPO基线在AIME、AMC等数学推理任务上同时提升了准确率和推理效率,实现了"更短且更准"的推理输出。
Flow-DPPO:将DPPO扩展到流匹配模型
Flow-DPPO是UniRL推出的第二个新算法,将DPPO(Diffusion Policy Policy Optimization)的思想扩展到流匹配(Flow Matching)模型上。
DPPO最初由Ren等人提出,核心思想是将扩散模型的去噪过程建模为一个增广MDP(bi-level MDP):每个去噪步骤被视为一个独立的动作,可以计算逐步的优势函数,然后用PPO框架进行策略梯度更新。这种设计让PPO的稳定性优势得以在扩散策略中发挥,已在机器人操控等连续控制任务中验证有效。
但DPPO原生适配的是DDIM采样器和标准扩散模型。流匹配模型(如FLUX、SD3、Stable Diffusion 3.5等)采用不同的前向/反向过程数学形式,DPPO不能直接迁移。
Flow-DPPO正是填补这一空白。它将DPPO的增广MDP框架适配到流匹配的ODE/SDE采样路径上,使得基于PPO的策略优化可以应用于流匹配模型的去噪轨迹。这与此前的Flow-GRPO(将GRPO扩展到流匹配模型)形成互补——GRPO是无价值网络的方法,依赖组内相对优势估计;DPPO/PPO则引入价值网络做基线估计,通常在信号较稀疏的场景下更稳定。
竞品横向对比
统一多模态模型的RL训练是一个快速演进的领域,UniRL并非唯一的方案。以下是当前主要的技术路线和代表性工作:
LLM/VLM专用RL方向,GRPO和DeepSeek-R1是核心参照。GRPO已成为事实标准,大量后续工作围绕它做改进。OpenRLHF、veRL等开源框架提供了LLM侧的RL训练基础设施,但不覆盖扩散模型。
扩散/流匹配模型专用RL方向,Flow-GRPO和DanceGRPO是最活跃的两个方案,将GRPO适配到连续去噪过程。MixGRPO(同样来自腾讯混元)提出ODE-SDE混合采样策略进一步提升效率。SRPO(腾讯混元)则走奖励无关路线,用自校正替代外部奖励信号。FPO(Flow Policy Optimization)从另一个角度将流匹配直接嵌入PPO框架。
统一模型RL方向,UniRL-Zero是最早系统定义六种统一模型RL场景的工作,但更偏向研究验证而非工程框架。CoRL提出在同一GRPO步骤中交替"共理解"和"共生成"批次。MMaDA的UniGRPO为扩散语言模型设计了统一的GRPO变体。PairUni将数据重组为理解-生成对来平衡两个任务的优化。
UniRL的差异化定位在于:它是一个工程级框架而非单一算法论文,目标是提供可插拔的算法选择和横跨多种模型类型的统一训练管线。同时,DRPO和Flow-DPPO分别在LLM推理效率和流匹配模型策略优化两个方向上提供了新的算法选项。
实际选型建议
对于不同的使用场景,RL算法的选型逻辑可以参考以下思路。
如果你只训练LLM/VLM的推理能力,GRPO仍然是最稳妥的起点。如果推理链过长是主要问题,DRPO提供了解耦奖励的解法,避免长度惩罚干扰正确推理的学习信号。
如果你训练扩散/流匹配模型的生成质量(文生图、文生视频等),Flow-GRPO和DanceGRPO是当前最成熟的选择。Flow-DPPO则适合需要更精细逐步信用分配的场景,或者Flow-GRPO在你的任务上训练不够稳定时作为替代方案。
如果你在训练统一多模态模型(同时包含理解和生成能力),UniRL作为框架的价值才真正体现——你需要一个RL循环同时处理离散token和连续去噪,这正是UniRL的核心设计目标。
需要注意的是,UniRL刚刚开源(2026年6月9日更新),社区使用反馈和第三方复现结果还很有限。选择生产级使用前,建议在自己的模型和数据上充分验证。代码仓库:github.com/Tencent-Hunyuan/UniRL。
 AI 速览