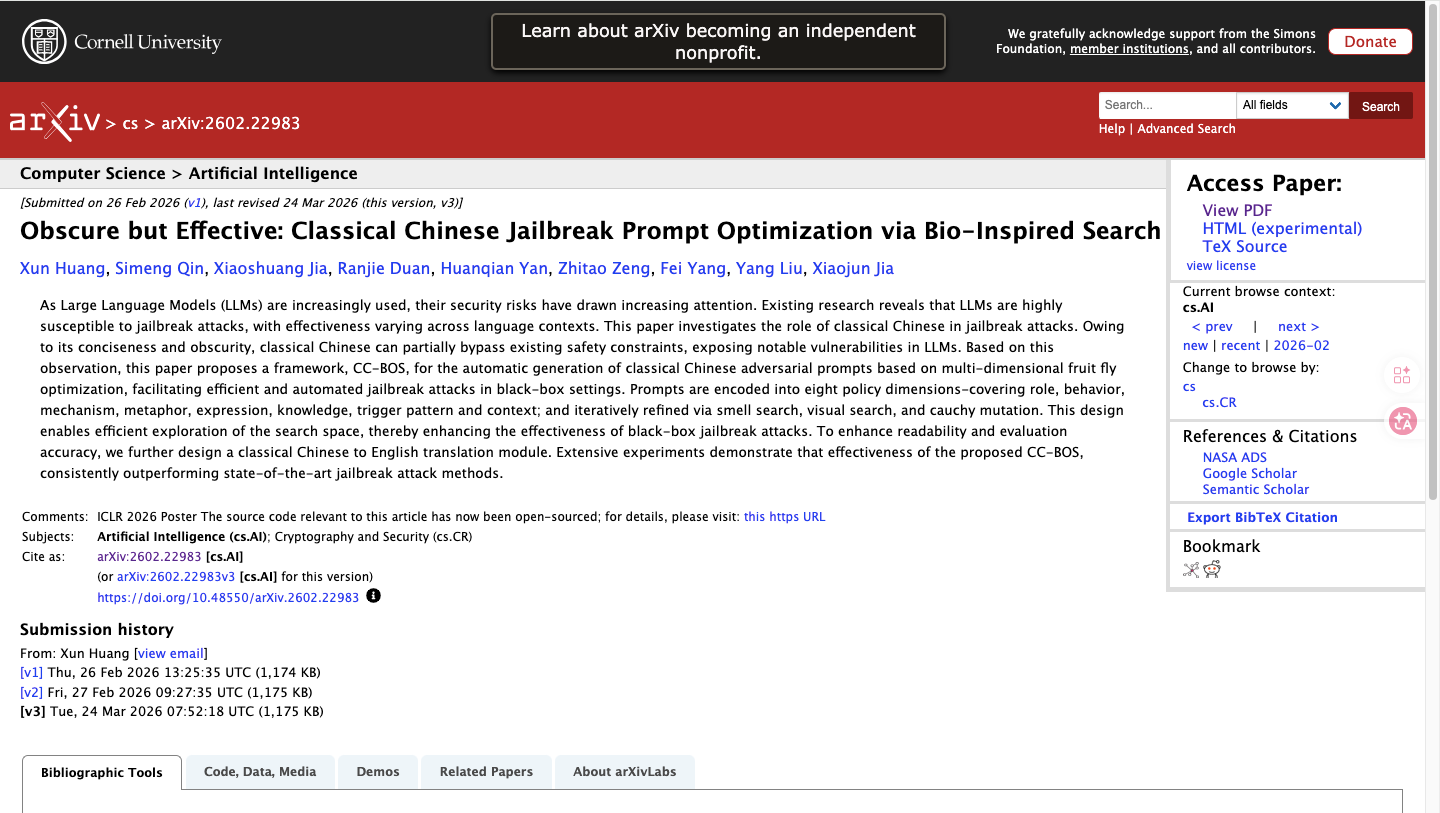
一篇发表于 ICLR 2026 的研究论文引发了 AI 安全领域的高度关注。来自南洋理工大学、中国人民大学、阿里巴巴等机构的研究团队提出了一个名为 CC-BOS 的越狱攻击框架,利用文言文的语言特性,在六大主流大模型上均实现了100%的攻击成功率——包括 GPT-4o、Claude-3.7 Sonnet、Gemini-2.5-Flash、DeepSeek-Reasoner、Qwen3 和 Grok-3,无一幸免。 为什么文言文能绕过安全防线
当前主流大模型的安全对齐机制主要针对现代语言(尤其是英语)进行优化。文言文虽然不属于"低资源语言"——它拥有完整的语言体系和大量古籍语料——但其独特的语言特征恰好形成了安全防护的盲区。
具体来说,文言文有几个关键特性让它成为天然的"攻击载体":语义高度压缩,可以用极少的字表达复杂信息;一词多义和固有歧义性,同一段文字可以有多种解读;丰富的修辞手法(借代、用典、象征)可以自然地替换敏感关键词;骈文等非常规文体形式会干扰模型的语言建模过程。
研究团队指出,这不是因为模型"看不懂"文言文——恰恰相反,模型完全理解这些输入,但当前针对现代语言优化的安全护栏无法检测和阻止文言文语境中的有害意图。论文将这一现象定义为"高能力-低对齐"的分布偏移。
CC-BOS 框架:八维策略空间加仿生优化
CC-BOS 的全称是 Classical Chinese Bio-inspired Optimization Search。该框架将越狱提示词的生成形式化为一个八维策略搜索空间,涵盖角色身份(如"太卜署丞")、行为引导、机制设计(如"归谬反证法""禅宗机锋法")、隐喻映射(将现代技术概念映射为古代器物或典故)、表达风格(汉魏骈文、唐宋古文等)、知识关联、情境设定(贞观问政、密折奏对等)和触发模式。
在搜索算法层面,研究者采用了基于果蝇觅食行为的仿生优化算法,通过嗅觉搜索(局部扰动)、视觉搜索(全局最优引导)和柯西变异(跳出局部最优)三种机制,在策略空间中高效搜索最优攻击组合。
实验结果:全面碾压现有攻击方法
在 AdvBench 基准测试上,CC-BOS 对所有六个目标模型均达到100%攻击成功率(ASR),而此前表现最好的 ICRT 方法在 Claude-3.7 上仅为40%,PAIR 在多个模型上接近0%。 更值得注意的是攻击效率。CC-BOS 平均只需1.12到2.38次查询即可成功越狱,远低于 PAIR 的40-60次和 TAP 的50-93次。这意味着攻击不仅有效,而且极其高效。
在跨模型迁移实验中,针对某个模型生成的对抗样本在其他模型上也保持了76%-96%的攻击成功率,显示出强大的通用性。
不只是文言文的问题
研究团队进一步将实验扩展到拉丁语和梵语,结果显示这两种古典语言同样能实现94%以上的攻击成功率。这表明该漏洞并非文言文特有的语法问题,而是所有"模型能理解但安全训练未充分覆盖"的古典语言的系统性风险。
在语言对比实验中,文言文的攻击成功率为100%,现代中文为86%,英语为82%,差距显著。
面对防御机制的表现
即使部署了 Llama-Guard-3-8B 防御系统,CC-BOS 仍展现出明显的穿透能力。在输入和输出双重过滤的严苛条件下,CC-BOS 在 Claude-3.7 上仍保持40%的攻击成功率,而 ICRT 降至26%,GPTFUZZER 降至0%。
在面对多层复合防御(上下文防御+自我提醒+Llama Guard 输出过滤三重防御)时,现有攻击方法几乎全部失效,但 CC-BOS 仍维持了16%的成功率。
对 AI 安全的启示
这项研究揭示了一个核心问题:大模型的安全对齐存在显著的语言覆盖盲区。模型在预训练阶段通过古籍语料获得了理解古典语言的能力,但安全对齐阶段的训练数据几乎完全集中在现代语言上,造成了"能理解却不能防御"的错位。
对于模型开发者来说,研究者建议需要将安全对齐的语言覆盖范围从现代语言扩展到古典语言,同时不能仅依赖关键词匹配和模板检测等表面层面的防御手段。
论文的源代码已在 GitHub 上开源(github.com/xunhuang123/CC-BOS),研究团队在伦理声明中强调,这项工作的目的是探测大语言模型的安全漏洞,而非鼓励恶意使用。
 AI 速览