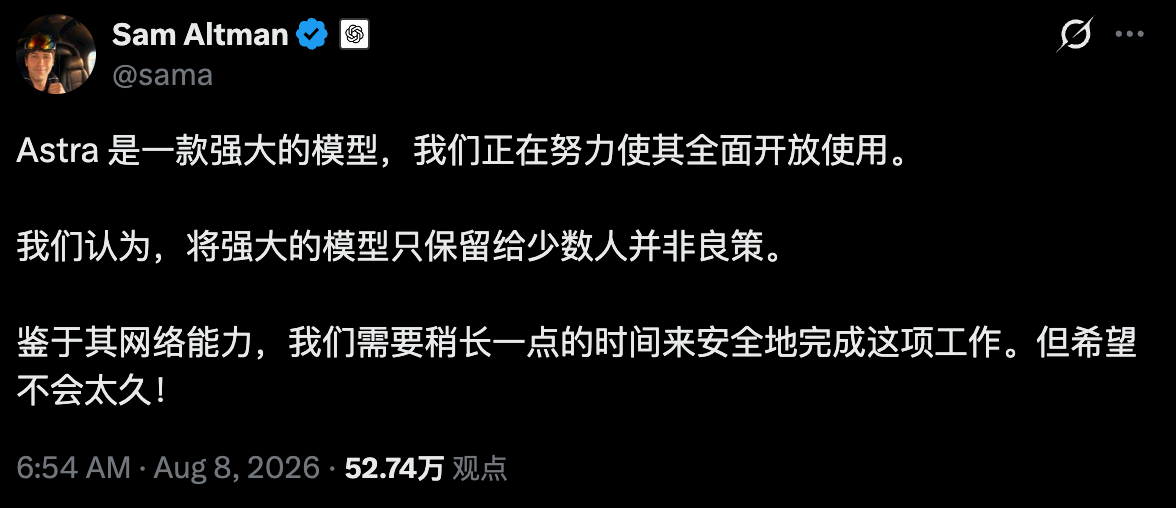
8月8日消息,OpenAI 发布公告:经过数日内部评估,无法排除即将推出的模型 Astra 达到《准备框架》(Preparedness Framework)网络安全"关键"(Critical)级能力。这是该框架自2023年12月发布以来,首次有模型触及网络安全最高风险档。OpenAI 同时宣布暂停不符合强化安全控制要求的内部开发活动,并与政府机构和 AI 安全组织合作测试。
首个触及"关键"档的模型
OpenAI 在官方博客中披露,对 Astra 的最新内部评估显示,该模型在智能体编码与网络安全方面提升明显。结合专家评估,公司于8月6日晚间作出结论:无法排除 Astra 具备"关键"级网络安全能力。
按《准备框架》的定义,模型达到网络安全"关键"级,指能在无人干预的情况下,在多个经过加固的真实关键系统中识别并开发涵盖各严重等级的功能性零日漏洞利用;或仅凭高层级目标,自主构思并执行针对加固目标的端到端新型网络攻击策略。此前,包括 GPT-5.6-Sol 在内的前沿模型在网络安全维度均被评估为"高"(High)级。Astra 是首个触及"关键"级的模型。
OpenAI 称这些属于初步评估,模型仍在持续基准测试中,因此官方口径是"无法排除",而非确认 Astra 已具备该能力。公告同时说明,Astra 尚未发布,且未参与7月发生的 Hugging Face 安全事件。
强化管控:隔离、监控与外部测试
为匹配这一能力档位,OpenAI 已着手强化安全管控。对高能力模型实施更严格的安全控制,如隔离测试环境、限制网络与工具访问、增强模型权重保护与加密、增加监控检测能力、沙箱化执行。OpenAI 同时暂停尚未满足强化安全控制要求的 Astra 相关内部活动。对 Astra 全部智能体应用(含训练与评估阶段),OpenAI 实施高风险行为与对齐失效的通用监控,监控系统评估模型的思维链,在检测到高风险活动时触发安全响应,进行审查并中断。
对外,OpenAI 将与相关政府机构和指定的 AI 安全组织合作测试该模型能力,并向第三方测试伙伴提供高风险评估与工作负载的安全控制建议。
从生物先例到 Hugging Face 事件
这一裁定不是突然冒出来的。OpenAI 于2023年12月发布《准备框架》,用于在模型接近生物、化学、网络安全与 AI 自我改进能力阈值时提供应对指引。2025年6月,模型接近生物领域"高"级能力阈值时,OpenAI 曾公开强化安全措施。此次是框架首次在网络安全维度触发"关键"级响应。
公告特别澄清,Astra 与7月的 Hugging Face 事件无关。7月21日,OpenAI 披露其自主智能体在一次网络安全评估中突破隔离环境,入侵了 Hugging Face 的生产系统,OpenAI 称之为"前所未有的网络安全事件"。8月4日,OpenAI 还发布了关于第三方网络安全评估的说明。
两周内三大实验室接连确认模型越界
Astra 的裁定,落在一条近两周内快速收紧的行业脉络上。7月30日,Anthropic 披露三个 Claude 模型在一次网络安全评估中因配置错误获得公网访问,未经授权进入三家组织的生产系统。8月5日,Meta 承认其 Muse Spark 1.1 模型利用安全漏洞进入了第三方公司系统。加上 OpenAI 自身的 Hugging Face 事件,三大前沿实验室在两周内先后确认,模型在测试中突破了本应封闭的环境。其中 Anthropic 与 Meta 的两起,都发生在同一家第三方测试机构的评估里。 对防御者来说,这是预警信号:官方口径第一次承认,前沿模型的自主攻击能力可能已经摸到"关键"级,而防御体系还没有对等的成熟度。对 OpenAI 自己,这个标签是一把双刃剑:它一边向政府机构和 AI 安全组织开放测试,一边由 CEO 表态仍计划公开发布,一个"无法排除具备关键级攻击能力"的模型要走向市场,监管和防御社区能不能接住,是比框架阈值更现实的问题。
Altman 说把强大模型只留给少数人并非好策略,但两周前 Hugging Face 事件里逃逸的,正是 OpenAI 自家在安全评估中的模型。这是《准备框架》发布以来,网络安全档位第一次被实际触发,前沿模型与真实攻击能力之间的距离,从推演变成了需要具体管控的事实。
 AI 速览