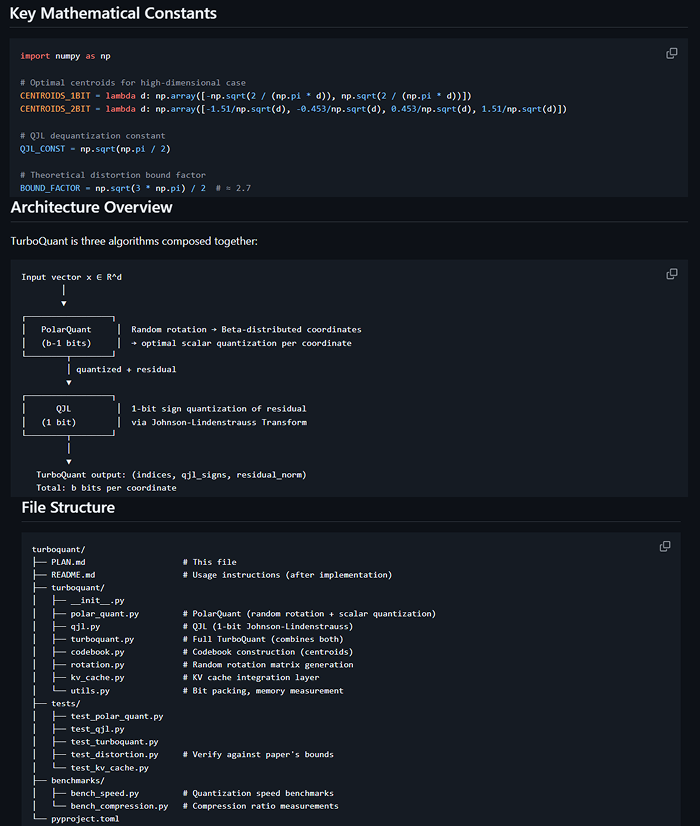
3月31日消息,独立开发者 Tom Turney 近日在 GitHub 开源了 TurboQuant Plus 项目,在谷歌未发布任何官方代码的情况下,仅用约一周时间完成了 TurboQuant 论文的完整工程实现,并集成到 llama.cpp 框架中,配合手写 Metal GPU 内核实现了 Apple Silicon 原生支持。在 M5 Max 上运行 Qwen 3.5 35B 模型时,KV 缓存压缩达到 4.6–6.4 倍,预填充吞吐量从 739 tok/s 提升至 2747 tok/s。
值得注意的是,Tom 表示:"当我说'我'的时候,实际上是和 Claude Code 以及 Codex 一起完成的,主要工作是大量的引导和监督。"这段坦诚的说明让这个项目成为 AI 辅助编程能力的一个真实样本。 谷歌论文与市场冲击
TurboQuant 是谷歌研究团队于 2026 年 3 月下旬在博客公布的极端向量量化算法,即将发表于 ICLR 2026。该算法通过 PolarQuant(极坐标旋转)和 QJL(量化 Johnson-Lindenstrauss 变换)两步操作,将大语言模型推理时的 KV 缓存压缩至约 3 bit/元素,内存占用降低约 6 倍,注意力计算速度在 H100 GPU 上最高提升 8 倍,且无需模型重训或校准数据,精度几乎零损失。
论文发布后,谷歌未开源任何官方实现代码,但市场反应迅速——内存芯片股出现集体下跌,投资者担忧 AI 硬件需求可能因此锐减。与此同时,开源社区在数天内涌现了多个平台的复现版本。
从论文到生产级实现
Tom Turney 的实现路径清晰且高效。前三天完成论文研读和核心算法构建,通过 500 多项单元测试验证 Python 原型的正确性(100% 代码覆盖率)。随后将算法移植到 llama.cpp 框架并手写 Metal GPU 内核,针对 Apple Silicon 做深度优化。最后阶段进行极致性能调优,手段包括 fp16 半精度搭配 half4 向量化蝶形运算、图侧旋转(graph-side rotation)、block-32 存储布局等。
更重要的是,他在复现论文的基础上加入了多项原创改进。Sparse V(稀疏 Value 解码)利用注意力权重作为门控信号,在长上下文推理时跳过对输出贡献微弱的 Value 向量解压操作,32K 上下文下解码速度提升最高 22.8%,且在 wikitext-103 上无可测量的困惑度损失。该技术不局限于 TurboQuant 格式,在 q8_0、q4_0 等标准量化格式上同样有效。
此外还包括:非对称 K/V 压缩(Key 保持高精度、Value 更激进压缩,解决低比特模型的质量退化问题)、时序衰减(Temporal Decay,老 token 自动降低精度,长上下文场景节省 30–34% 内存)、层自适应模式(关键层保持 q8_0 精度,整体仍获得 3.5 倍压缩)。
在 Needle-in-a-Haystack 检索测试中,启用 Sparse V 后的单针检索为 9/9(基线 7/9),多键检索在 32K 上下文中达到 100% 通过。
为什么这件事值得关注
首先,它是 AI 辅助编程范式变革的一个具体证据。一个独立开发者借助 Claude Code 和 Codex,在一周内完成了从论文阅读到 GPU 内核优化的全链路工程实现,并产出了社区可直接使用的开源代码。这种效率在传统开发模式下通常需要专业团队数月的投入。 其次,它推动了本地大模型长上下文推理的实用化。在 MacBook(Apple Silicon)等消费级硬件上高效运行 35B 参数模型的长上下文推理,降低了对高端 GPU 和大容量显存的依赖。项目已支持 turbo2(2-bit,6.4 倍压缩)、turbo3(3-bit,4.6 倍压缩)、turbo4(4-bit,3.8 倍压缩)三种格式,覆盖从极端内存压力到质量优先的不同场景。
第三,开源社区的响应速度再次碾压大厂节奏。谷歌论文发布不到一周,llama.cpp 社区讨论区已出现多个独立实现,Tom 的版本不仅是其中完成度最高的之一,还通过原创改进在部分指标上超越了论文本身的设计。
项目已在 GitHub 开源(github.com/TheTom/turboquant_plus),支持 Metal 和 CUDA 后端,可通过 --cache-type-k turbo3 --cache-type-v turbo3 参数在 llama.cpp 中直接启用。
 AI 速览