智谱团队近期披露了GLM-5在Coding Agent高并发场景下的推理工程修复记录。日均数亿次调用、平均输入超过70K tokens的负载下,系统先后暴露出乱码、复读、生僻字三类异常,稳定复现时每万次请求出现3-5次。团队历时数周定位并修复了PD分离架构KV Cache竞态、HiCache流水线同步缺失两个底层Bug,并通过KV Cache分层存储方案LayerSplit将Prefill吞吐提升10%-132%。这份排查记录揭示了大模型推理基础设施在长上下文Coding Agent场景下的真实压力。
三类异常无法稳定复现,投机采样指标反成检测信号
排查初期,团队对bad cases做本地回放、重复推理数百次均未复现,基本排除模型本身问题。直到将线上日志脱敏后全量回放,调整PD分离比例并持续提高负载,模拟Prefill堆积与Decode侧KV Cache压力,才在每万次请求中稳定复现3-5次异常。这种"与请求内容无关、与系统压力相关"的特征,把问题锁定在高负载下的状态管理。
异常检测本身成了瓶颈。复读相对好检测,乱码和生僻字用正则与字符集匹配存在漏判与误伤,模型判别又满足不了大规模消融实验的效率要求。团队最终从投机采样(Speculative Decoding)找到切入点:spec_accept_length和spec_accept_rate两个指标在异常发生时呈现稳定模式——乱码和生僻字伴随极低的spec_accept_length,说明KV Cache状态与草稿模型预期偏差显著;复读则伴随偏高的spec_accept_rate,损坏的KV Cache让注意力模式退化为高置信度循环。当spec_accept_length持续低于1.4且生成长度超过128 token,或spec_accept_rate超过0.96时,系统主动中止生成并交由负载均衡器重试。投机采样从单纯的性能优化技术,扩展为输出质量的实时监控信号。
BugFix#1:PD分离KV Cache竞态,异常率从万分之十几降到万分之三
为限制尾延迟,团队在推理引擎中引入超时Abort机制:Prefill未在规定时间完成时,Decode侧Abort请求并回收KV Cache。问题在于Abort信号未被正确传播到Prefill侧。
具体时序是:Req1发往Prefill-1(P1)和Decode(D),P1因调度排队迟迟未开始Prefill Forward。Decode等待KV Cache超时触发Abort,回收Req1占用的KV Cache槽位但没通知P1。Req2到达后被分配到Prefill-2(P2)和Decode,复用了Req1的KV Cache地址。P2很快完成Prefill并KV Transfer,Decode进入生成阶段。此时P1对Req1的KV写入仍在继续,数据写入了已被Req2复用的显存区域,覆盖了Req2的部分KV Cache。Req2读到被覆盖的数据,输出异常。
修复方案是在请求终止与KV写入完成之间建立显式同步:Decode触发Abort后通知Prefill,Prefill仅在RDMA写入未开始或全部完成时返回"可释放"信号,Decode收到确认后才回收槽位。修复上线后异常率从万分之十几降到万分之三以下。Mooncake、DistServe等PD分离方案都需要面对类似工程问题——跨节点的数据传输与显存复用必须有明确的一致性约束,否则在高负载下竞态会被放大。
BugFix#2:HiCache时序缺失,Read-before-Ready潜伏在Sparse Attention里
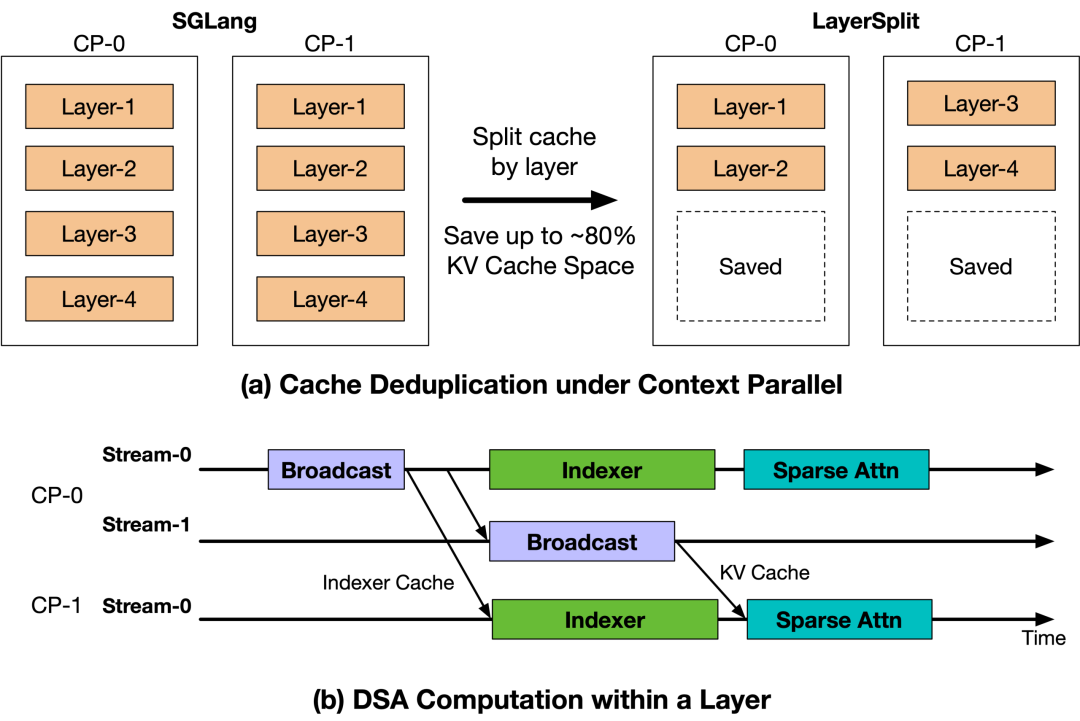
剩下的万分之三异常指向HiCache。问题出在DSA HiCache的缓存读取路径:系统从CPU内存异步换入历史前缀缓存,Load Stream负责加载KV Cache与Indexer Cache,Forward Stream依次执行Index计算与Sparse Attention。理论上Indexer计算应在Indexer Cache加载完成后启动,但原始实现没显式表达这个依赖——Indexer算子启动时未对Load Indexer Cache的完成建立同步约束,Forward Stream可能先于Load Stream完成而开始执行,出现Read-before-Ready访问。
修复就是在Indexer算子启动前引入与Load Stream的同步点,该修复已通过PR #22811并入SGLang社区,相同负载下执行时序不一致引起的异常完全消失。DeepSeek-V3的MLA、滑窗注意力实现都依赖类似的Cache流水线,这类细粒度同步Bug在多Stream重叠执行的优化中很容易被掩盖,只在特定负载下暴露。 LayerSplit分层存储:40K-120K区间Prefill吞吐提升10%-132%
修完两个状态一致性问题后,团队回到瓶颈本身。Coding Agent上下文长、Prefix Cache命中率高,Prefill是主要性能瓶颈,线上Prefill节点用Context Parallel(CP)作为主要并行策略。但SGLang开源实现存在KV Cache冗余存储,有限的KV Cache容量限制了GPU计算资源利用率。
LayerSplit的思路是每张GPU不再保存全部层的KV Cache,只持有部分层,显著降低单卡显存占用。计算时持有某层KV Cache的rank在Attention计算前将该层Cache广播给其他rank,广播与Indexer计算重叠执行,整个流程仅引入Indexer Cache广播的额外开销,规模约为KV Cache的1/8,对性能影响可以忽略。在Cache命中率90%、请求长度40K-120K区间,LayerSplit带来10%-132%的吞吐提升,上下文越长收益越显著。
局限与选型参考
这套方案的边界需要注意。LayerSplit的收益依赖较高的Prefix Cache命中率(实验基于90%命中率),低命中率场景下广播开销可能稀释收益。投机采样作为质量监控信号,依赖目标模型的behavior pattern,关闭投机采样的部署场景需要另寻检测手段。两个Bug修复都是状态一致性层面的,不属于通用算法优化——只在PD分离+HiCache+长上下文Coding Agent这种组合负载下才显式触发。
对自建推理服务的团队,几个参考点:PD分离架构需要在Abort传播上做严格时序约束,特别是跨节点RDMA写入;HiCache的多Stream重叠优化要把Load与Forward的依赖显式化,否则Read-before-Ready可能潜伏在长尾负载里;Prefill瓶颈场景下分层KV Cache存储是一条值得跟进的路径。直接调用闭源API的团队压力相对小,但需要关注供应商在长上下文Coding Agent场景下的稳定性指标——这份排查记录暴露了一个普遍现象:大多数Coding Agent异常并非模型问题,而是基础设施问题。
 AI 速览