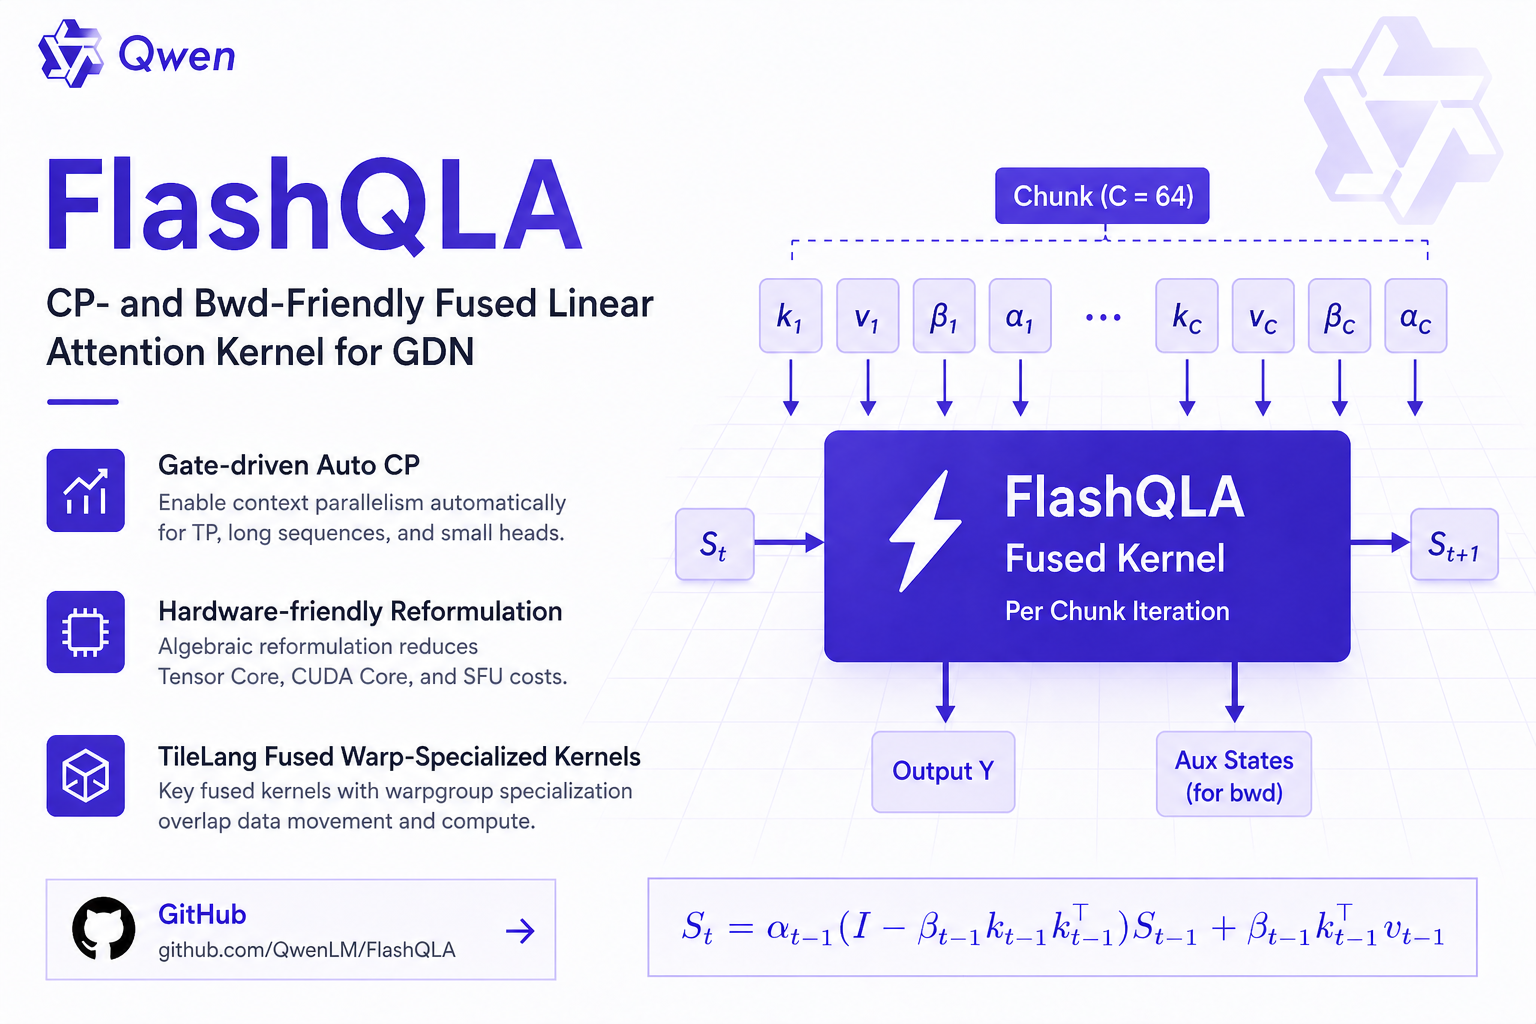
4月30日消息,Qwen团队开源高性能线性注意力算子库FlashQLA,基于TileLang实现,针对Gated Delta Network(GDN)的Chunked Prefill前向与反向流程做了算子融合与硬件优化。在NVIDIA Hopper上,FlashQLA相对FLA的Triton kernel实现2-3倍前向加速、2倍反向加速,覆盖Qwen3-Next-80B-A3B到后续Qwen3.5/Qwen3.6系列(397A17B、122A10B、35B、27B)的训练与推理场景。GitHub地址:https://github.com/QwenLM/FlashQLA。
GDN承担Qwen全系75%注意力层,算子开销不再可忽略
GDN自Qwen3-Next起成为Qwen全系列的主力注意力层,与全注意力按3:1比例交替排列,约75%的层走线性注意力路径。这套混合架构在公开资料中已被vLLM、Kimi Linear等项目验证可行,Hugging Face上的Qwen3-Next-80B-A3B官方介绍也明确将GDN+Gated Attention作为长上下文建模的核心。 随着模型规模扩展到几百B激活参数,GDN在端到端训练与推理中的开销变得不可忽视。一篇近期的FPGA加速器论文指出,GDN在batch-1解码场景下的算术强度低于1 FLOP/B,比标准Transformer的MHSA还要更memory-bound——这是所有subquadratic架构的共性问题,从Mamba、Mamba-2到DeltaNet都落在同一区间。这意味着GDN的工程优化空间主要在访存路径上,而非计算密度。
FLA Triton实现的两个矛盾点
FlashQLA要解决的是FLA(Flash Linear Attention)在GDN Chunked Prefill上的两个结构性问题。
第一个问题是访存开销大。FLA将GDN Chunked Prefill的每一步对应一个独立的Triton kernel,大多为memory-bound,K、V需要反复从HBM读取,W、U、S等中间变量也要写回HBM再被下一个kernel读取。TFLA(Tiled Flash Linear Attention)论文也指出过类似问题:FLA的chunk size有限,大量中间状态必须materialize在GPU内存里,导致长上下文预训练场景下arithmetic intensity偏低。
第二个问题是GPU利用率受限。SSM state的递推性质让chunk_gated_delta_rule_fwd_kernel能开出的thread block数量仅为batch_size × num_heads,在小模型、小batch或张量并行(TP)场景下SM利用率不够。
这两个问题的解法是矛盾的。直接写一个fully-fused kernel能把所有数据收到片上,在batch_size × num_heads足够大时是最优解;但在端侧batch=1或大模型开TP做长序列chunked prefill时,这种方案相比FLA加速有限——这正是Coding Agent、长文档处理等真实负载的典型形态。
双Kernel拆分+Gate衰减:折中解法
FlashQLA的核心思路是把GDN Chunked Prefill前向计算流程拆成两个fused kernel,中间插入Context Parallel(CP)相关的预处理。配套设计了一个数学模型自动算并行度:序列上chunk数量为N、每个CP rank上chunk数量为L,步骤2.1和3运行时间正比于L,步骤2.2正比于N/L,取L=λ√N使总时间最短。
Auto CP的触发条件很克制:仅在batch_size × num_heads ≤ 40,或batch_size × num_heads ≤ 56且seq_len ≥ 8192时开启卡内序列并行,其他场景沿用FLA原版的v_head_dim切分策略。这种条件式开启避免了在大batch场景下引入不必要的通信开销。
更精巧的优化点在Gate衰减性质的利用。GDN递推公式中,gate对后续状态的影响呈指数衰减,具备天然的滑动窗口性质。FlashQLA实测发现,60-80%的线性注意力头上gate不恒为1,只需6-8个chunk的warmup就能把误差压低到噪声以下。基于这一观察,FlashQLA为具备滑窗性质的注意力头设计了更轻量的CP preprocess流程,直接通过warmup获得精确的子序列状态,跳过了修正量M的计算。
TileLang warp-specialization实现
底层kernel基于TileLang构建,采用warpgroup specialization:同一SM内一个生产者warpgroup加三个消费者warpgroup,通过shared memory交换数据、mbarrier同步。前向流程中三个消费者分别计算V'、S、O,通过ping-pong结构遮盖计算与访存。反向流程因片上资源限制不设multi-stage,改用长计算流程遮盖访存,把bwd_dv、bwd_dhu、bwd_dqkwg、bwd_wy融合到一个kernel里。
TileLang作为底层DSL的选择有其工程理由。PyTorch近期的博客和Tawa论文都指出,Triton的warp specialization支持仍处于演进期,其异步copy机制更接近Ampere风格,在Hopper上对TMA驱动数据搬运与WGMMA重叠的支持不够充分。TileLang在编译期自动做warp specialization,前端代码无需手写producer/consumer同步逻辑。论文数据显示TileLang在H100上的Linear Attention性能优于Triton版本,这与FlashQLA的实测加速比方向一致。
适用场景与局限
FlashQLA的benchmark覆盖Qwen3.5/Qwen3.6系列的head配置(h_v ∈ {64, 48, 32, 24, 16, 8},对应TP1到TP8),与FLA 0.5.0、Triton 3.5.1、FlashInfer 0.6.9做了横向对比。加速比随TP增大而提升——这符合Auto CP在小num_heads场景下提高SM利用率的设计预期。
环境要求是硬门槛:SM90架构(H100/H200/H20)、CUDA 12.8+、PyTorch 2.8+。这意味着Ampere及更早的GPU无法直接受益,A100、4090用户仍需依赖FLA原版Triton kernel或TFLA这类替代方案。
适用场景上,FlashQLA明确指向GDN类线性注意力,对Mamba-2、xLSTM等其他subquadratic架构需要另写算子,通用性弱于FlashAttention这类全注意力kernel库。Auto CP的两个触发阈值是经验值,在特殊head/batch组合下未必最优,生产环境部署需做workload-specific的profiling验证。
线性注意力赛道近一年明显进入工程深水区。FLA、TFLA、FlashQLA、ThunderKittens各自从不同角度优化memory-bound瓶颈,Tawa等工作则在自动化warp specialization上推进。FlashQLA的价值在于把Qwen真实生产负载的优化经验沉淀为开源算子,后续Qwen3.5/3.6开源权重落地时,推理框架可以直接接入这套kernel——这比单纯的benchmark数据更有参考意义。
 AI 速览