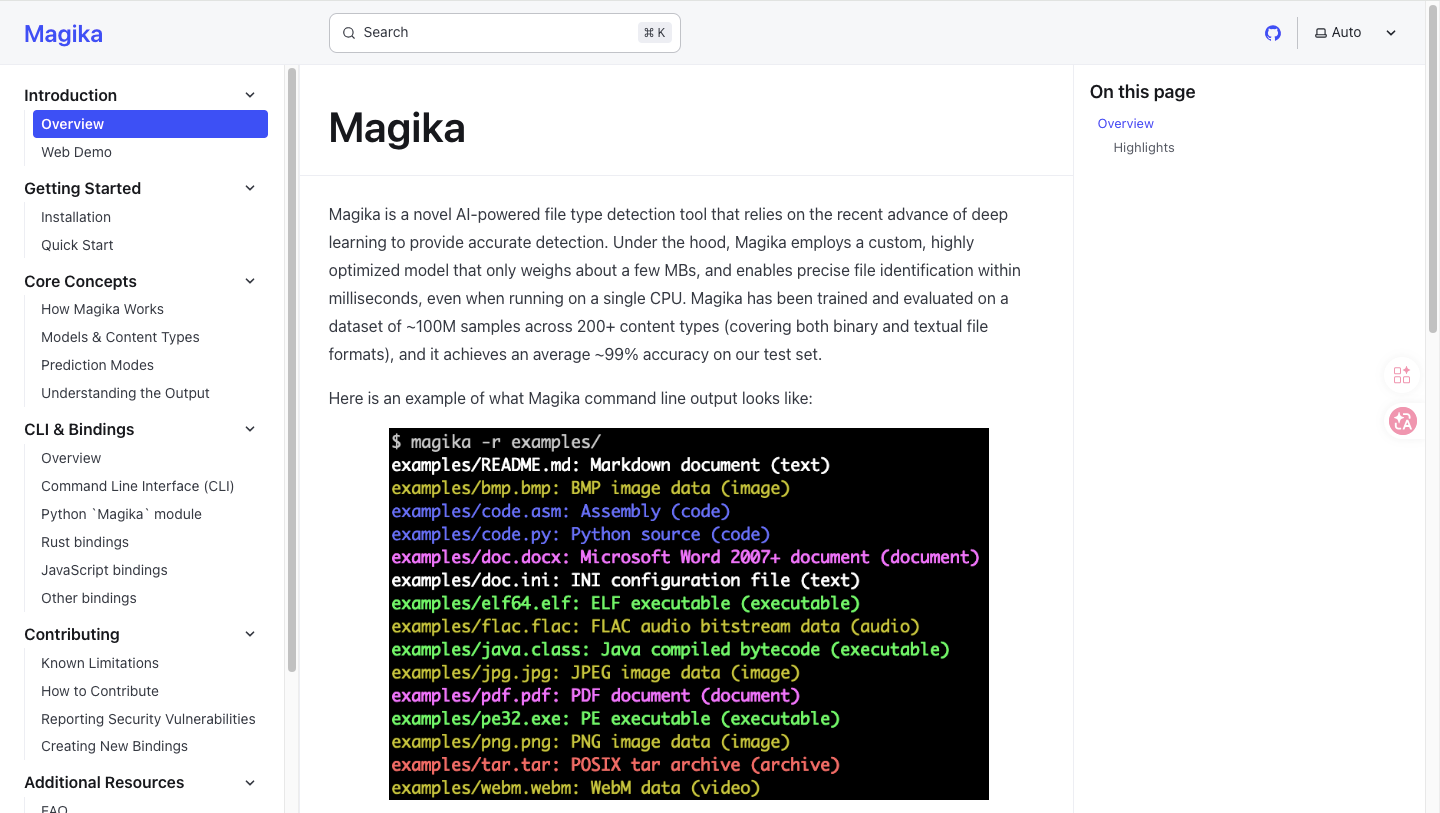
谷歌于2025年11月正式发布Magika 1.0稳定版,这是其AI驱动文件内容检测系统的首个正式版本。该版本核心引擎用Rust从零重写,支持超过200种文件类型(此前约100种),在MacBook Pro M4上单核每秒可处理近1000个文件。Magika已在Gmail附件扫描、Google Drive上传流水线和Safe Browsing中大规模部署,每周处理数千亿级文件。
传统文件类型检测工具如Linux系统的file命令(基于libmagic库)已经存在超过50年,依赖人工编写的启发式规则和magic number签名。这种方式对二进制文件表现尚可,但面对文本格式和编程语言文件时经常误判——攻击者也正是利用这一弱点伪造文件扩展名绕过安全扫描。
Magika的AI检测原理:不看扩展名,只读文件内容
Magika的核心检测逻辑与传统工具截然不同。它不依赖文件扩展名或文件头的magic bytes,而是使用一个仅约1MB大小的定制深度学习模型(用Keras训练,ONNX Runtime推理)分析文件的真实内容。
具体来说,模型从每个文件的头部、中部和尾部各提取512字节(共三段),通过这些位置的结构特征、语义模式和内容线索来判断文件类型。这种多点采样设计使得即使文件被刻意篡改或截断,Magika仍然能识别其真实格式。据谷歌在IEEE/ACM ICSE 2025发表的研究论文数据,Magika在超过100万个文件的测试集上取得了约99%的平均精确率和召回率,尤其在文本类文件上显著超越现有方案。
与传统工具的性能差距在文本文件上尤为明显。谷歌官方博客披露,Magika在Gmail等内部系统中将文件类型识别准确率提升了50%(相比此前的规则系统),使专用恶意文档AI扫描器能多扫描11%的文件,未识别文件比例降至3%。
Rust重写带来的性能与安全提升
1.0版本最核心的架构变化是将推理引擎从Python完全迁移到Rust。据Medium上CherryZhou的技术分析,Rust实现将推理延迟降低了约40%,在高吞吐环境中内存开销减少了一半。更重要的是,Rust的内存安全特性从根本上消除了C/C++中常见的内存相关漏洞——这对一个专门处理不可信文件的工具而言至关重要。
性能方面,Magika 1.0采用ONNX Runtime执行模型推理,搭配Tokio异步运行时实现并行处理。据谷歌官方博客基准数据,在MacBook Pro M4上单核处理速度接近1000文件/秒,多核环境下可轻松扩展到数千文件/秒。模型加载完成后,单文件推理时间约5毫秒(据GitHub仓库README),与非AI工具几乎持平。
安装方式也很简洁。Linux/macOS用户执行curl -LsSf https://securityresearch.google/magika/install.sh | sh即可获得原生Rust CLI,Windows用户可通过PowerShell脚本安装。开发者可通过Python(pipx install magika)、TypeScript(npm实验包)和Rust库将Magika集成到自己的项目中,GoLang绑定也在开发中。
200+文件类型覆盖与Gemini合成数据训练
Magika 1.0将支持的文件类型从约100种扩展到200种以上,覆盖了多个此前难以自动化检测的领域。
在数据科学和机器学习方面,新增了Jupyter Notebook(ipynb)、NumPy数组(npy/npz)、PyTorch模型、ONNX文件、Apache Parquet和HDF5等格式。编程语言方面新增了Swift、Kotlin、TypeScript、Dart、Solidity、WebAssembly和Zig等。DevOps领域覆盖了Dockerfile、TOML、HashiCorp HCL、Bazel构建文件和YARA规则。数据库与图形方面增加了SQLite、AutoCAD(DWG/DXF)、Adobe Photoshop(PSD)和Web字体(WOFF/WOFF2)。
更精细的区分能力是1.0的另一亮点。此前容易混淆的格式现在可以准确区分,例如JSONL与JSON、TSV与CSV、C++与C、JavaScript与TypeScript、Apple二进制plist与XML plist。
扩展格式支持面临两个技术难题。首先是数据规模——未压缩的训练数据集超过3TB,谷歌团队使用自研的SedPack数据集库实现流式解压直接送入内存训练。其次是稀有格式的数据稀缺问题,许多专用格式和遗留格式根本找不到足够的真实样本。谷歌的解决方案是利用Gemini生成高质量合成训练数据,将现有代码和结构化文件从一种格式"翻译"为另一种格式,配合数据增强技术构建了覆盖全面的训练集。最终训练和评估数据集涵盖约1亿个文件。
与传统工具和竞品的对比
文件类型检测领域的工具可分为三类:传统规则型(libmagic/file、TrID)、AI驱动型(Magika、OPSWAT File Type Detection Engine)和混合型。
libmagic/file是Linux世界的默认标准,依赖手工维护的magic签名数据库。优势是轻量、成熟、无需AI推理开销,对二进制文件头部特征明确的格式表现稳定。但其致命短板在于文本类文件识别能力弱,且规则维护成本高。据谷歌官方博客数据,Magika在百万文件基准测试中整体准确率超出libmagic等现有工具约20%,文本文件上的优势更为显著。
TrID是另一个广泛使用的文件识别工具,拥有约3400个文件签名的可扩展数据库,支持概率排名输出。但它同样基于签名匹配,对结构模糊的文件类型力不从心。
OPSWAT在2025年发布了File Type Detection Model v3,同样采用深度学习方案,但定位于商业安全场景。据OPSWAT官方博客,其方案整合了TrID、LibMagic和自有技术,在24.8万文件/约100种类型的测试中声称综合准确率高于单一工具。不过Magika在开源生态和Google规模验证方面占据明显优势。
值得注意的是,Hacker News上也有社区用户进行了实测对比。有用户测试发现,在扫描Linux内核头文件目录(约1235个文件)时,libmagic/file命令耗时0.69秒,而早期Magika版本耗时约24秒——这说明在简单二进制格式批量扫描场景下,传统工具的原始速度仍有优势。1.0版本的Rust重写大幅缩小了这一差距,但AI推理的固有开销意味着Magika更适合需要高准确率的场景而非纯速度比拼。
局限性与适用边界
Magika并非万能工具,使用时需要了解其明确的局限边界。
在元数据提取方面,Magika只负责"这是什么文件"的分类判断,不提供文件内部的详细元数据(如图片分辨率、EXIF信息、文档作者等)。如果需要这些信息,仍需搭配ExifTool等专用工具。
在深层格式信息方面,据PCHardwarePro的技术分析文章,面对UPX打包的PE可执行文件时,Magika和TrID都能识别为PE格式,但传统file命令能进一步指出UPX打包这一关键信息——这在恶意软件分析中很重要。Magika适合作为快速分类和路由的第一层,但深度取证分析仍需专用工具。
在资源开销方面,Magika的AI模型约1MB,推理需要加载ONNX Runtime,对资源受限的嵌入式环境可能偏重。虽然1.0版本已大幅优化,但与libmagic的几十KB内存占用相比,仍有量级差距。此外,模型的检测质量高度依赖训练数据覆盖度——对于训练集未充分覆盖的冷门格式,准确率可能下降。
Magika项目在GitHub上以Apache 2.0许可证开源,自alpha版本以来月下载量超过100万次。研究论文已在IEEE/ACM ICSE 2025会议正式发表,开发者可通过官方网站的Web Demo在浏览器中直接体验,无需安装任何依赖。
 AI 速览