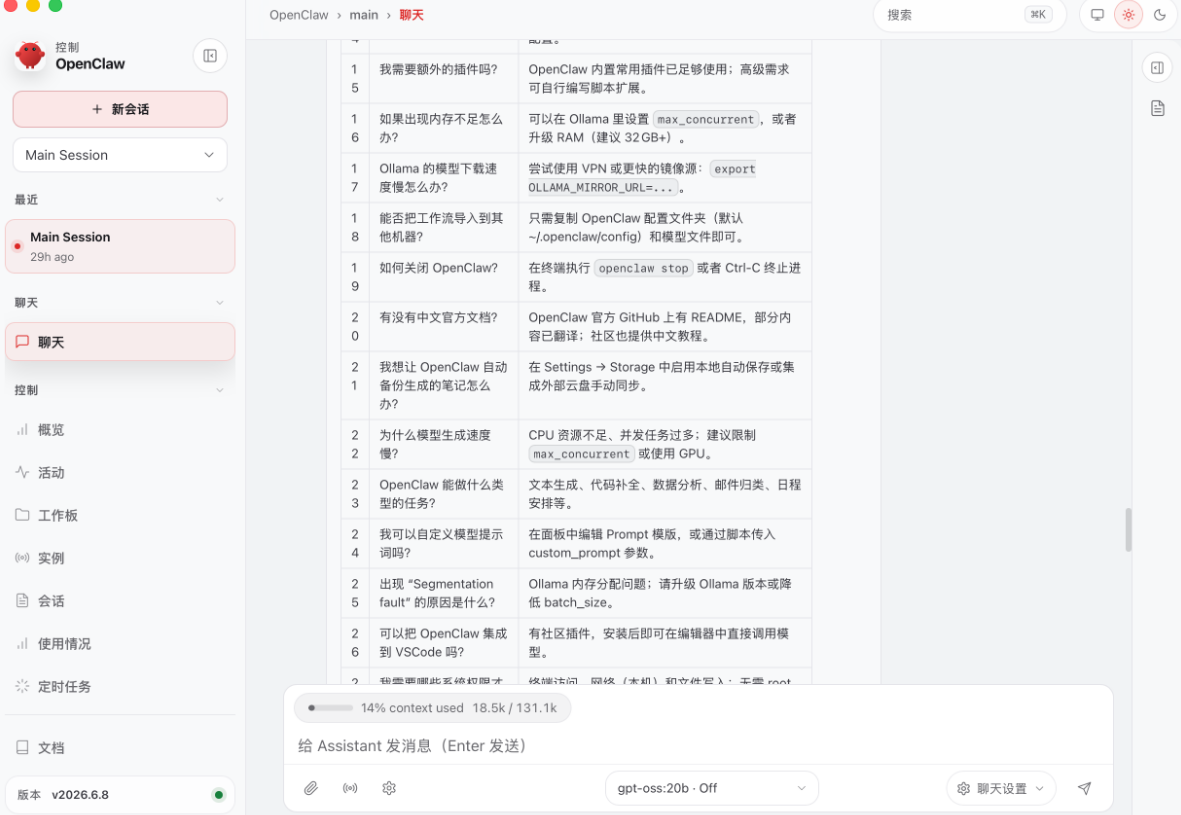
第一次打开 OpenClaw,大多数人的反应都是:功能太多,不知道从哪下手。这篇文章不讲复杂原理,只带你把整个界面认识一遍。看完之后,你基本知道每个区域是干什么的,后续再学工作流、Agent、多智能体,会轻松很多。
OpenClaw 界面左侧:项目管理区
左边这一栏是整个 OpenClaw 的导航区,第一次打开最容易迷路的就是这里。
**新会话(New Session)**是左侧最核心的功能。它的作用是新建一个 AI 工作项目。写公众号、做小红书、做周报,最好每个任务单独开一个会话,以后查资料也方便。
有一个新手非常容易踩的坑:点击左上角「+ 新会话」之后,左边会生成一条类似 agent:main:dashboard:xxxxx 的编号,很多人以为这是乱码或者出了问题。其实这只是系统自动生成的会话编号,不是项目名,也不是乱码。
正确的用法是:只点一次新会话,然后在第一句话里写清楚项目名称和规则。 比如:
项目名称:OpenClaw 新手界面教程 这个会话只处理这个项目。目标:写一篇适合公众号发布的新手教程。要求:内容准确,不确定的地方标注"需要确认"。后续所有回答都围绕这个项目,不要混入其他主题。
以后要继续这个项目,就点左边对应的会话继续。虽然显示的是编号,但点进去第一句话就是你写的项目名称。
记住一句话:新建项目 = 点一次新会话 + 第一句话写项目名称和规则。
OpenClaw 界面顶部:导航与状态栏
顶部导航栏显示当前会话的基本状态,包括连接状态、当前使用的模型信息,以及一些全局设置入口。不同版本的界面细节可能略有差异,但整体布局逻辑是一致的。
OpenClaw 界面中间:聊天内容区与上下文进度
聊天内容区是你和 AI 对话的主要区域。这里有一个很多新手看不懂的数字:% context used 和 k / k。
举个例子帮你理解:
| |
|---|
| |
| |
| 当前模型最大支持约 131000 Token 上下文 |
**Context(上下文)**可以理解成:AI 目前"记住"了多少聊天内容。
第一次聊天只有 1%,聊着聊着变成 10%、20%、50%……快到 100% 的时候,模型开始遗忘前面的内容,回答变慢,开始跑偏。
这时候正确的做法是:先让旧会话做一份交接摘要——
请把当前项目整理成一份交接摘要,包括目标、已完成内容、下一步任务、注意事项。
然后新建一个会话,把摘要粘进去继续。一个项目结束或者上下文快满了,就新建会话,不要一直聊下去。这是新手最常见的坑。
OpenClaw 界面底部:输入区与核心配置
底部输入区是整个 OpenClaw 使用频率最高的地方,每天都会用到。
模型选择位于底部中间,这里是 OpenClaw 最重要的位置之一,很多新手容易误会。
需要明确一点:OpenClaw 本身不是模型。 它只是一个调度和执行框架,真正负责"思考"的是你在这里选择的模型,比如 GPT 系列、Qwen、Llama、DeepSeek 等。OpenClaw 负责调用这些模型来完成工作。 选什么模型,直接决定了 AI 的思考质量和能力上限,这个设置值得认真对待。不同模型有不同的擅长方向和价格,可以根据任务需求切换。
聊天设置位于右下角,主要控制当前会话的行为参数,比如是否开启某些工具权限、Agent 模式的相关配置等。不同任务可以在这里做针对性调整。
发送按钮在最右边,点击发送 Prompt,也可以直接按 Enter 发送。
用一个比喻把 OpenClaw 界面串起来
如果把 OpenClaw 比作一家公司,整个界面就很好理解了:
- 上下文进度条:这个项目的"记忆容量",快满了就要归档
- 底部模型选择:你雇用的哪位"专家"在帮你处理这个项目
认识界面只是第一步,OpenClaw 真正的价值在于后续的工作流搭建和 Agent 配置。但很多人卡在"界面都没搞清楚"这一步,导致后面越用越乱。把这篇读懂,后面的进阶内容就会顺很多。遇到不确定的功能,先新建一个测试会话,大胆试,上下文满了重开就行,不会有什么损失。
 AI 速览