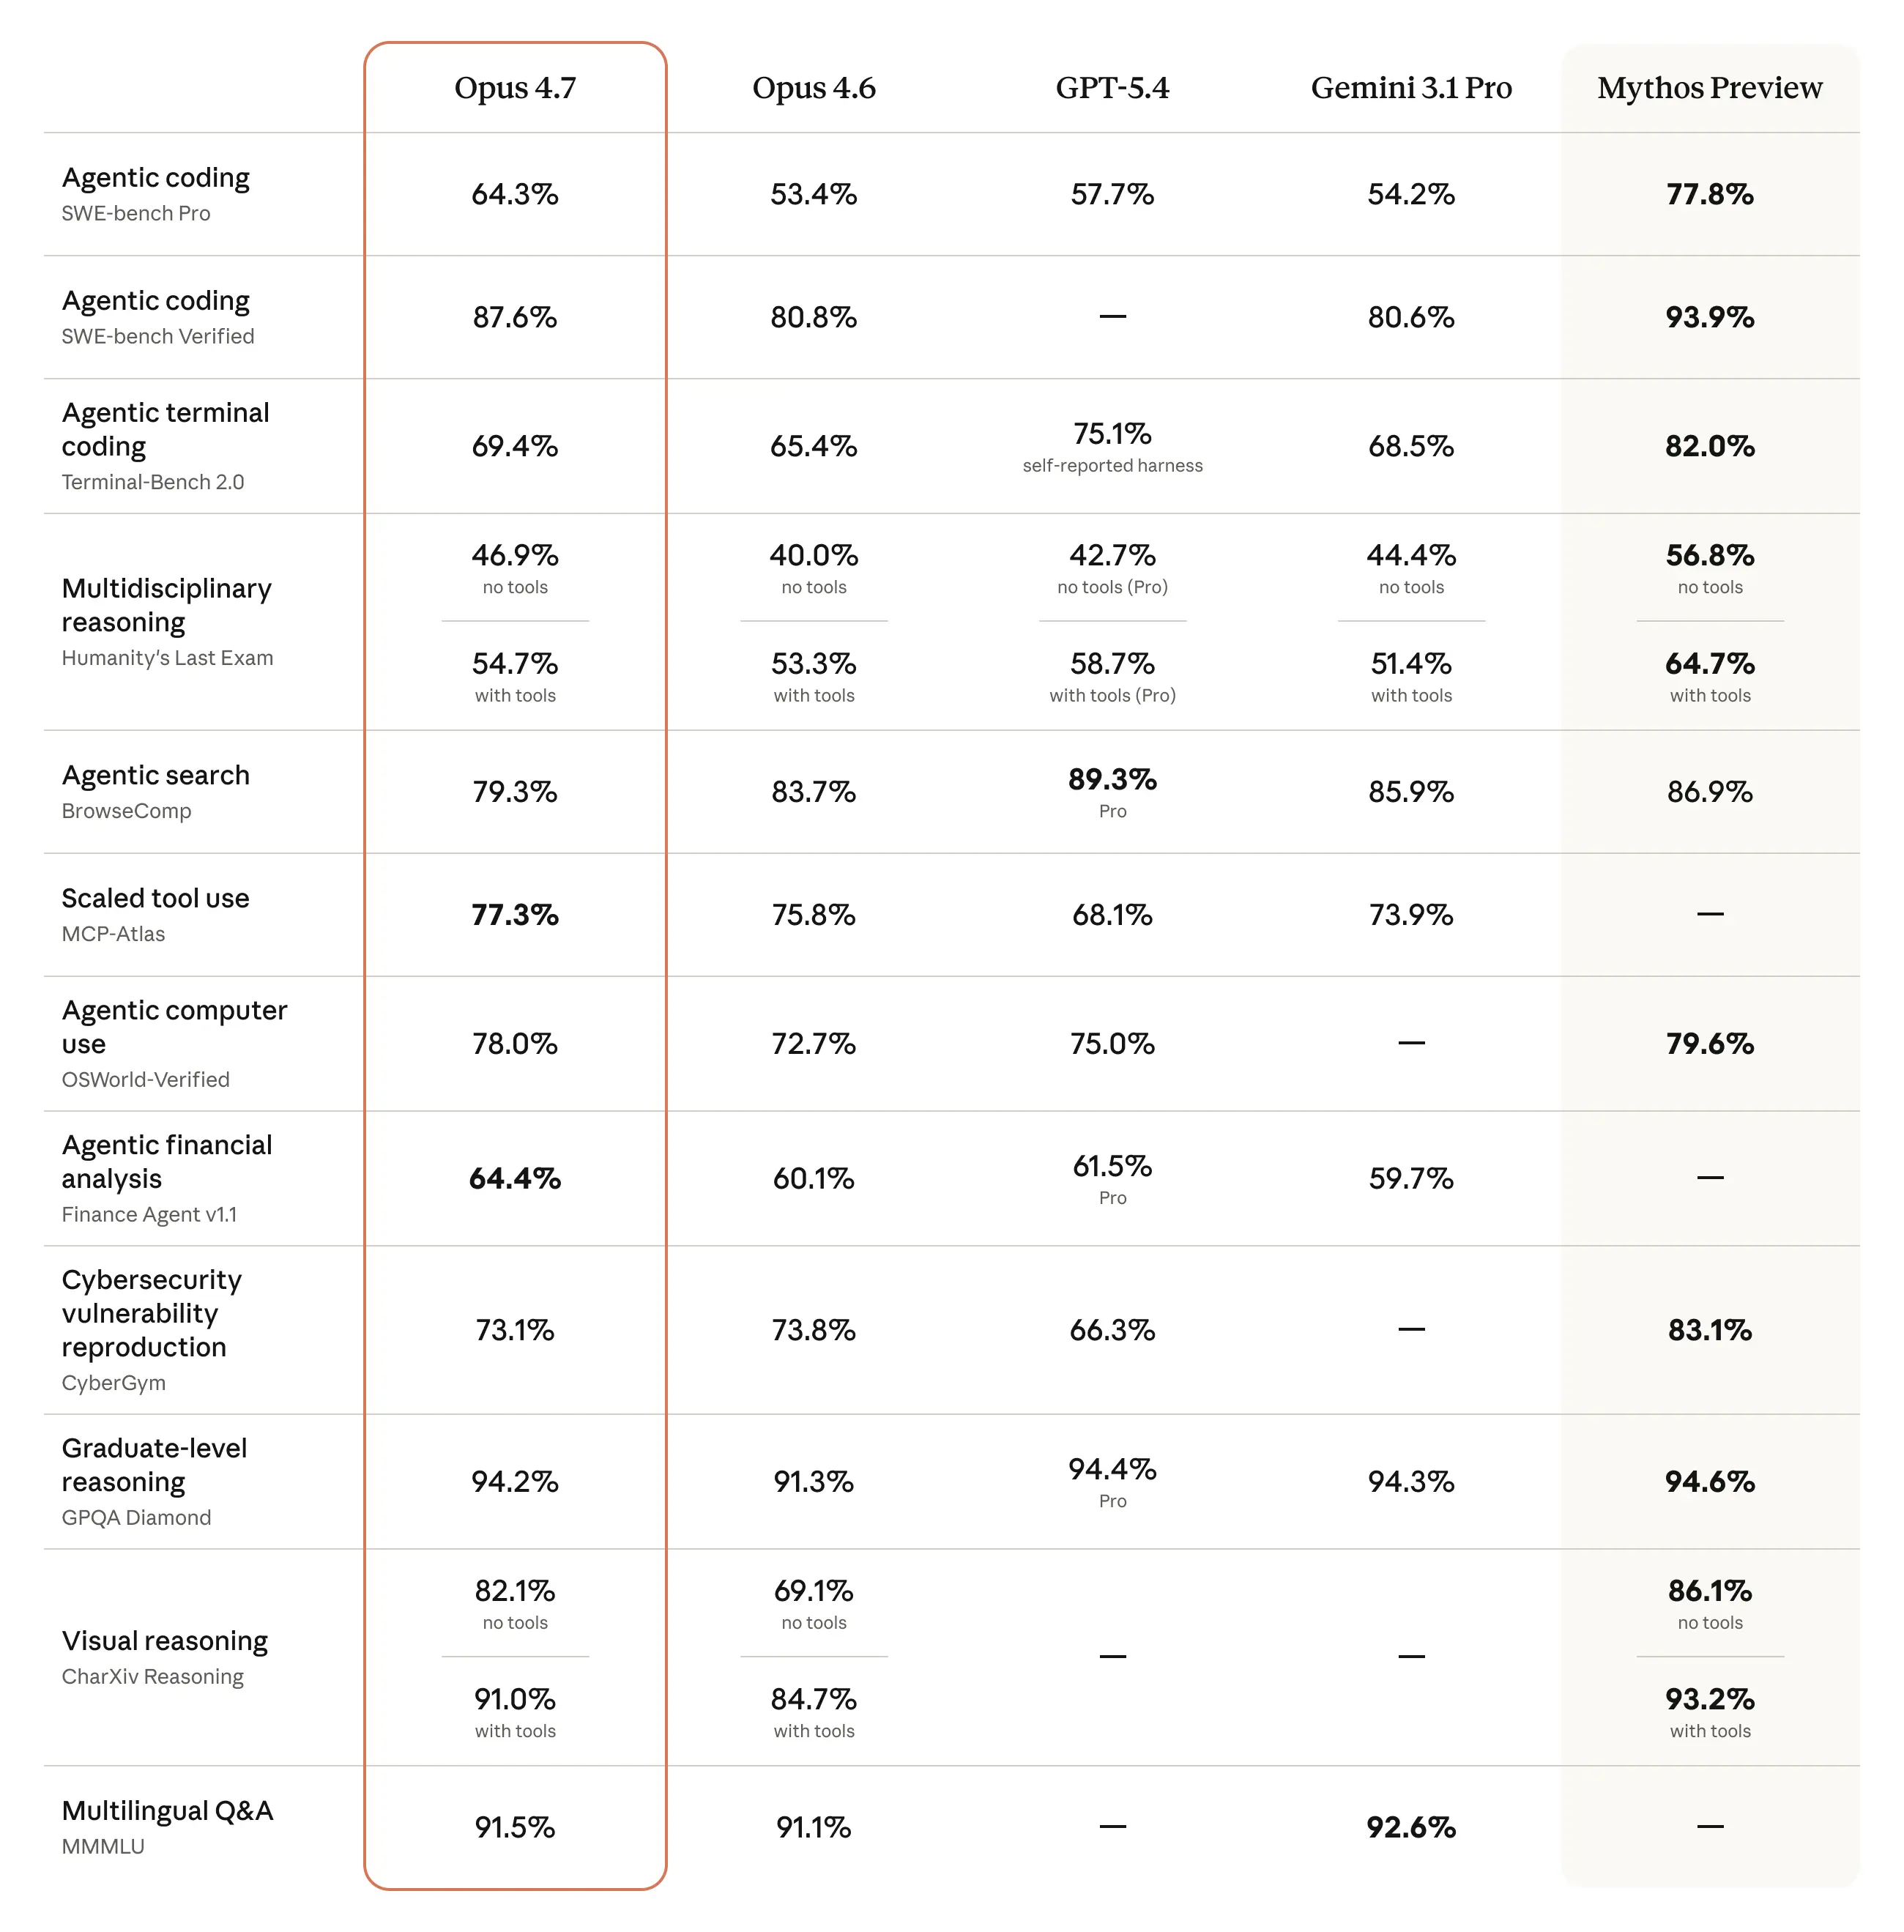
4月16日消息,Anthropic正式推出旗舰大语言模型Claude Opus 4.7。这是Opus系列最新迭代,重点强化长时程代理任务、复杂软件工程和专业知识工作能力。模型现已全面上线,支持Claude网页、App、API,以及Amazon Bedrock、Google Vertex AI、Microsoft Foundry等云平台。 基准测试再创纪录,编程能力领跑业界
- SWE-bench Verified:87.6%(较4.6版显著提升,业界顶尖)
SWE-bench Verified经过人工验证,87.6%的成绩意味着模型能独立解决近九成真实GitHub Issue。
核心能力全面升级:更自主、更持久、更可靠
Opus 4.7在长时程任务上实现质的飞跃:
- 可处理更长时间的任务,支持复杂、多步骤的长时间工作;
- 汇报前会自我验证输出,主动检查结果一致性与准确性。
这些特性让开发者能在更少监督的情况下,将高难度工作放心交给模型,真正实现“放手”式AI代理开发。
视觉与思考能力双增强
视觉能力大幅提升,可接受长边最长2,576像素的图像(约3.75百万像素,是此前模型的3倍以上)。模型能更精细地解析密集截图、复杂图表、UI设计和文档细节,极大提升计算机使用代理、数据提取和视觉推理场景的表现。
思考档位新增xhigh等级,介于High和Max之间。结合自适应思考(Adaptive Thinking)机制,用户可更灵活地在智能深度与速度/成本之间进行权衡,尤其适合编码和代理任务。
- 新增 /ultrareview(Ultra Review)命令:专为代码审查设计,可自动启动专用审查会话,标记Bug、设计问题和优化建议;
- 自动审批模式(Auto Mode):现已向Max用户开放,支持更长时间的无人值守运行,减少中断;
- 任务预算(Task Budgets)功能进入公测,进一步助力长时间自主代理工作。
定价保持不变,但实际成本需关注
API定价与Opus 4.6完全一致(输入5/百万Token,输出5/百万Token,输出25/百万Token)。不过,由于模型在复杂任务中会进行更深入的推理和自我验证,实际Token消耗可能增加,建议开发者通过effort参数、提示优化和任务预算进行成本控制。
 AI 速览