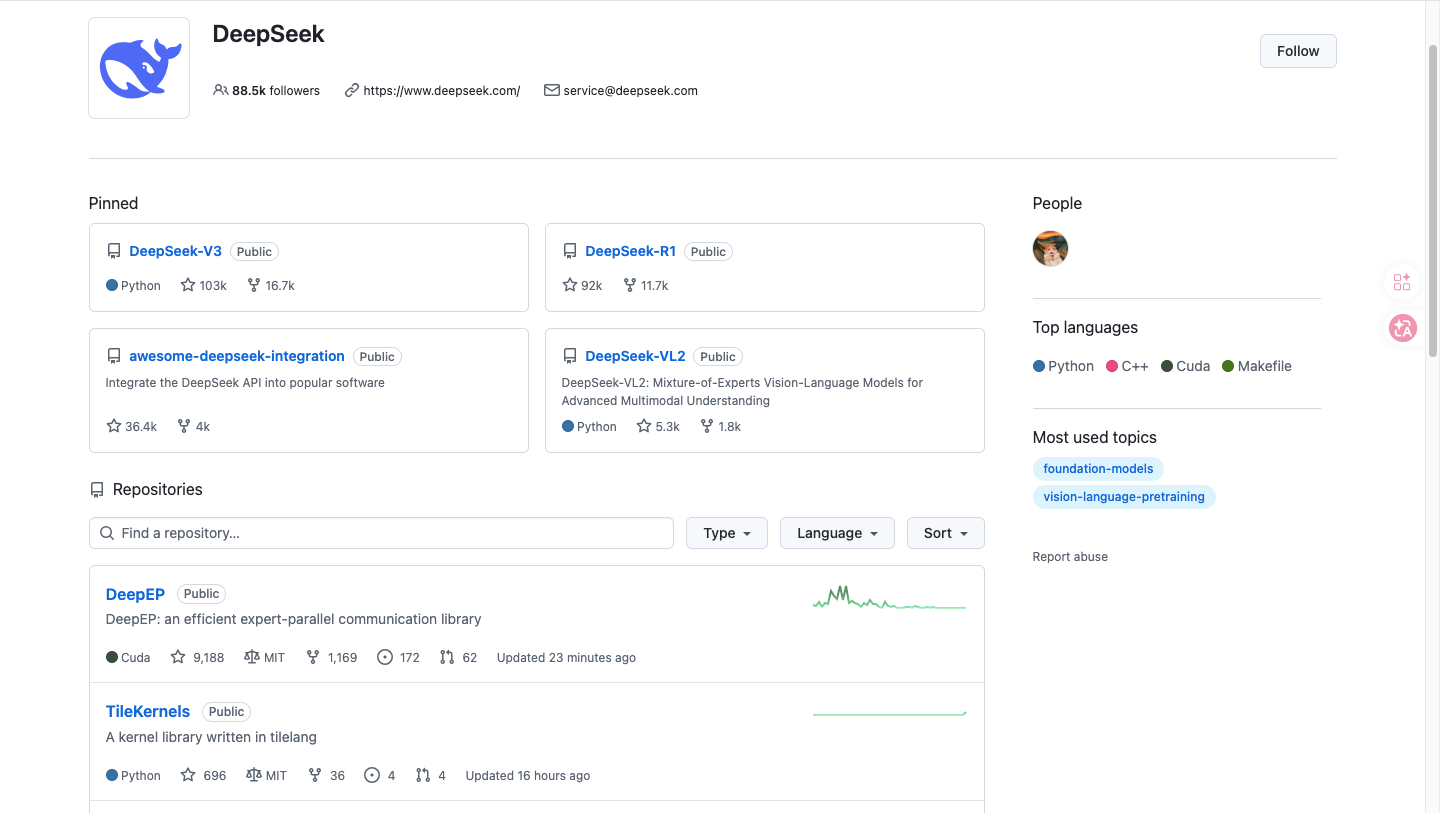
4月24日消息,DeepSeek 在 GitHub 开源 TileKernels 算子库,同日发布 DeepEP V2,两者合为面向 Hopper/Blackwell GPU 的底层优化栈——TileKernels 覆盖 MoE 路由、FP8/FP4/E5M6 量化、Engram 门控、mHC(Manifold HyperConnection)等模块并同时提供前向与反向支持,DeepEP V2 则聚焦 MoE 训练里 all-to-all 通信的延迟瓶颈。这次是典型的"不发模型、发底座",把之前仅有论文的 Engram、mHC 从研究成果下沉到可用算子层,V4 尚未正式发布但其架构底座至此齐备。 TileKernels 里有什么:逐模块拆解
仓库结构非常清楚:moe/(MoE 路由相关 kernels)、quant/(FP8/FP4/E5M6 量化)、transpose/(批处理转置)、engram/(Engram 门控 kernels)、mhc/(Manifold HyperConnection kernels)、modeling/(engram 和 mHC 的高层 autograd 建模层)、torch/(PyTorch 参考实现)、testing/(测试与基准工具),基于 TileLang 编写,MIT 许可。
技术路径上,TileKernels 绕过 NVIDIA CUTLASS 等标准库,直接针对 Hopper 和 Blackwell GPU 的 tile 级架构写 CUDA kernels。与 DeepEP V2 的切入点不同——DeepEP V2 优化 GPU 之间如何通信(专门减少 MoE 训练中 router dispatch 和 combine 阶段的延迟),TileKernels 优化每块 GPU 本地怎么用 compute 时间。两者合起来把 MoE 训练的两个最大瓶颈——跨节点通信和 tile 级计算——都覆盖了。
Engram 这一块是此次最实质的新增项。Engram 是一个条件外部记忆模块,把静态知识存储从 Transformer 层剥离出来,通过可扩展查找实现常数时间(O(1))检索。paper 原文写得直白:"该过程本质上是对一个静态查找表进行昂贵的运行时重建,把宝贵的序列深度浪费在琐碎操作上,这些操作本来可以分配给更高层的推理"。TileKernels 这次把 Engram 门控算子和建模层(modeling/engram)同时发布,代码作者包括 Xiangwen Wang、Chenhao Xu、Huanqi Cao、Rui Tian、Weilin Zhao、Kuai Yu 和 Chenggang Zhao。
mHC(Manifold HyperConnection)的算子也一同落地。这个模块处理的是训练稳定性问题——在万亿参数规模下防止梯度爆炸。mHC 是一个数学框架,把信号放大约束在 2 倍以下(相比无约束时的 3000 倍),使 DeepSeek 能够在 6.7% 的计算开销下稳定训练万亿参数模型。
Engram-27B 在等参数等 FLOPs 约束下全面超 MoE 基线
这部分的数据来自 1 月 12 日发布的 Engram 论文,此次 TileKernels 开源把这些数字背后的实现彻底公开。
评测采用严格的 iso-parameter 和 iso-FLOPs 对照:MoE-27B(26.7B 总参数,72 个路由专家 + 2 个共享专家,top-6 激活)对比 Engram-27B(同样 26.7B 总参数,路由专家从 72 降到 55,释放的参数重新分配给 5.7B 参数的嵌入模块,嵌入比 ρ=74.3%)。两个模型在同样的 262B token 预训练语料上训练,激活参数数严格匹配。
结果分布相当一致:知识维度 MMLU +3.4、CMMLU +4.0、MMLU-Pro +1.8;推理维度 BBH +5.0、ARC-Challenge +3.7、DROP +3.3;代码与数学维度 HumanEval +3.0、MATH +2.4、GSM8K +2.2。
但最值得注意的不是这些标准 benchmark 的涨幅,而是长文本检索:Needle-in-a-Haystack 基准上,Engram 把准确率从 MoE 基线的 84.2% 拉到 97%,长达 12.8 个百分点的跃升。原因是 Engram 承担了本地模式匹配,把注意力容量释放给全局上下文处理。
U 型分配律是另一条值得内化的结论:纯 MoE 基线(ρ=100%)并非最优,把 20-25% 的稀疏参数预算重新分配给 Engram 能获得最佳性能。即使 MoE 分配量缩减到 40%,配上 Engram 的模型也能匹敌纯 MoE 基线——这意味着 MoE 专家数量不需要堆到最大,给 memory 留 20-25% 反而整体更赚。
基础设施角度同样值得看:由于 Engram 的索引在推理前就已知,系统可以异步通过 PCIe 把 embedding 预取到 GPU。Engram-27B 的研究版本把一张 100B 参数的嵌入表整体 offload 到 host DRAM,吞吐损失低于 3%。对于受 HBM 容量限制的大规模部署场景,这一条单独就能改变选型逻辑。
局限与前瞻:V4 尚未发布,静态知识会过时,工程对齐还没完成
信息需要冷静拉回边界。这次开源的是底层算子,不是 V4 模型。截至 4 月 11 日,DeepSeek V4 仍未公开发布,官方 API 的 deepseek-chat 和 deepseek-reasoner 映射的仍是 DeepSeek-V3.2,上下文窗口 128K。Reuters 4 月 3 日的报道指 V4 将在"数周内"发布并在华为 Ascend 950PR 上运行,但具体时间表依旧悬而未定。
架构本身的短板也写在 paper 的潜台词里。对于事实知识频繁变动的领域——金融数据、监管框架、快速演进的代码库——静态查找表会比推理主干更快过时。论文没有讨论 post-training 的 memory 更新、查找表的微调策略、以及如何在不完整重训练的情况下刷新事实知识。把静态知识外置化,短期节省算力,长期对"知识刷新"链路的工程化要求会更高。
扩展到 trillion 级别同样不是直接外推。论文公开训练了四个模型:Dense-4B、MoE-27B、Engram-27B 和 Engram-40B,其中 Engram-40B 在预训练末期训练损失与基线的差距仍在继续拉大,说明扩展的 memory 容量在当前 token 预算内尚未完全饱和。从 27B 研究模型推断到 1T 生产模型,中间还有大量工程问题要解决。
竞品对照值得一句。NVIDIA CUTLASS 作为通用 GEMM 库仍然是行业标准,TileKernels 相当于 DeepSeek 对 Hopper/Blackwell 架构的专用优化分支——不是替代 CUTLASS 的全场景对手,而是在 MoE + Engram + FP8/FP4 这个特定组合上做到更省。同期 DeepSeek 家族的其他开源项目还包括 DeepGEMM(FP8 GEMM 细粒度 scaling kernels)、FlashMLA(多头潜注意力 kernels)、DualPipe(计算-通信重叠的双向 pipeline parallelism),整体形成了一条"模型算法 → 算子实现 → 分布式通信 → pipeline 调度"的全栈开源线。
前瞻分析:DeepSeek 这两年的路线越来越明确——不用发模型,也能往行业上游里卡位。V3 开源模型权重奠定名声,V4 前夜直接把底层算子和通信库公开,相当于把"怎么训、怎么推"这层护城河的水也放出来。对仍然依赖闭源 CUTLASS/cuBLAS/NCCL 栈的国内团队和海外中小型实验室来说,这套开源底座把 MoE + 条件记忆的训练门槛降了一档。真正要看的下一步,是 V4 正式发布后,Engram 的 U 型分配律能不能在万亿参数规模上继续成立。
 AI 速览