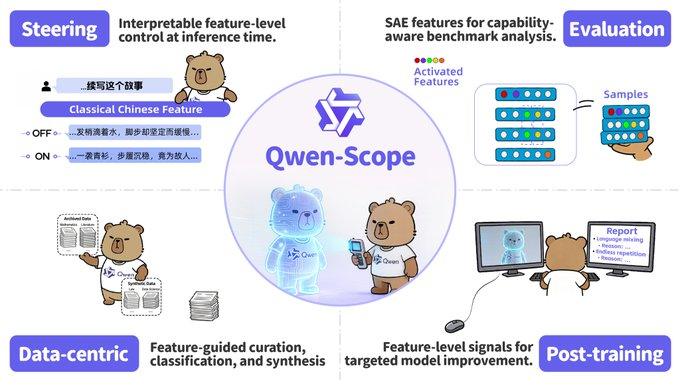
5月1日消息,阿里千问宣布开源 Qwen-Scope,这是基于 Qwen3 与 Qwen3.5 系列训练的可解释性模块,通过在 Qwen 隐藏层插入稀疏自编码器(SAE)并施加稀疏性约束,自动提取出高度解耦、低冗余且更具可解释性的隐藏空间特征。本次开源覆盖 7 个大模型、共 14 组 SAE 权重,稠密模型与混合专家模型均被纳入,是国产头部模型厂商首次在 SAE 级别公开释出可解释性资产。
14组SAE、7个模型、0.5B token:开源规模直接拉到生产级
本次开源覆盖 7 个 Qwen3 与 Qwen3.5 系列模型,包括稠密模型与 MoE(混合专家)模型,总计 14 组稀疏自编码器权重。训练数据从对应模型的预训练数据中采样 0.5B 词元,这一规模高于多数学术 SAE 项目,但远低于全量预训练,目的是在特征覆盖广度、语义强度、训练稳定性之间取得平衡。
从 Hugging Face 仓库中 Qwen3.5-27B 的配置可以看到具体规格:64 层每层一组 SAE,SAE 宽度 81920,对应 d_model 5120,每次前向只保留 50 个非零特征(L0=50)。这是一个相当激进的稀疏比——把 5120 维的稠密激活展开到 8 万级别的特征空间,再压缩到 50 个活跃特征,意味着每个特征的语义粒度被切得非常细。
横向对比:Gemma Scope 在 Gemma 2 系列上提供了从 2B 到 27B 全尺寸覆盖、SAE 宽度从 16k 到 1M 不等的选项;Llama Scope 主要覆盖 Llama 3 8B;Anthropic 的 SAE 工作未开源权重,仅以论文形式呈现。Qwen-Scope 的差异化在于覆盖了 Qwen3.5 这一国产最新一代基础模型,并且把稠密+MoE 两种架构都囊括进来——MoE 上的 SAE 训练此前几乎没有公开权重可用。
推理控制:不动权重就改输出,语言混用、风格迁移、实体替换三件事齐了
Qwen-Scope 最直接的产品级能力是特征引导推理(feature steering)。具体做法是:找到对应"中文输出"、"古典文学风格"、某个具体实体等概念的特征通道,在推理时直接抑制或放大它的激活值,模型的输出就会沿着这个方向偏移,且不需要改任何权重、不需要重写 prompt。
社区已经验证了几个典型用法:
- 语言混用修复:英文 prompt 下模型偶尔蹦出中文片段是 Qwen 系列的老问题,定位并抑制对应"中文语言特征"通道后,混用现象明显减少
- 风格迁移:放大某个"古典文学风格"特征,模型回答自动带上文言色彩,无需在 prompt 里写"请用文言文风格"
- 实体定向修改:替换或抑制特定实体特征,可以让模型在不被察觉地引导话题方向
这与 prompt engineering 的本质区别在于:prompt 是从输入端施加约束,模型仍然可能"听不进去";feature steering 是从激活层面直接干预,更稳定、更可预测。这一思路与 Anthropic 早前在 Claude 上演示的"Golden Gate Claude"(放大金门大桥特征让模型逢话题必绕到金门大桥)一脉相承,但 Qwen-Scope 把它做成了开源工具,开发者可以直接在自己的 Qwen 部署里加 hook 调用。 数据、训练、评估:SAE从可视化玩具升级为开发工具链
通义千问团队真正想推的,是把 SAE 嵌进整个模型开发流水线。三个非可视化场景在博客和技术报告里都给了具体路径: 数据侧:传统数据分类要靠人工或大模型标注,成本高且对长尾覆盖差。Qwen-Scope 的做法是仅用少量种子样本激活对应特征,再用这些特征作为分类器去筛选海量未标注数据,效率显著高于纯 LLM 标注。更进一步,对那些"长尾激活"——即在预训练数据中被某些特征激活但样本极少的情况——可以反向构造数据,定向补足模型的薄弱能力。这是典型的从可解释性反哺数据工程的玩法,过去只在 OpenAI、Anthropic 内部有零星实践。
训练侧:Qwen-Scope 把"语言混用"和"重复生成"这两个 RLHF 阶段难以根治的问题归因到特定特征通道的异常激活,然后在 SFT 和 RL 阶段对这些特征进行约束,从源头降低发生频率。这意味着调教模型不再只能靠 reward model 的隐式信号,可以直接告诉模型"别把这个特征激活那么强"。
评估侧:通过计算不同评测集上的特征激活模式,可以判断两个 benchmark 之间的能力覆盖重叠度。如果 MMLU 和某个新 benchmark 在 SAE 特征空间上高度重合,那么后者就是冗余的——这能直接降低评测成本、避免堆 benchmark 堆出虚假提升。
这四个场景里,数据和训练的应用对工程团队最实用。推理引导更适合做 demo 和小批量定制;评估优化更偏向研究团队用来设计自家 benchmark 体系。
与Claude、Gemma Scope、Llama Scope的路线差异
把 Qwen-Scope 放在整个 SAE 生态里看,能更清楚阿里押注的方向。
Anthropic 在 Claude 3 Sonnet 上做了规模最大的 SAE 训练(论文中报告的特征数达到 3400 万级别),但未开源权重,公开的更多是研究发现(如金门大桥特征、安全相关特征等)。其重心在 AI 安全与对齐,强调"让外界知道大模型在想什么"。
Gemma Scope 是目前学术友好度最高的开源 SAE 套件,覆盖 Gemma 2 全尺寸、提供多种宽度和 L0 配置,配套 Neuronpedia 的可视化平台,主要面向 mech interp 研究社区。
Llama Scope 在 Llama 3 8B 上做了 6 组 SAE 开源,规模相对收敛,仍偏研究取向。
Qwen-Scope 的差异化定位在两点:第一,覆盖 MoE 架构,这是 Gemma Scope 和 Llama Scope 都没做到的,对 DeepSeek V3/V4、Mixtral、Qwen3.5 这一类 MoE 主流路线意义重大;第二,强调工程落地,技术报告和博客花了大量篇幅讲数据合成、训练修复、评估优化等开发场景,而不是停留在"我发现了 X 个有趣特征"。这反映出阿里团队的产品化思路——SAE 不是论文工具,是基础模型团队自己的内部工具链,现在被外部化了。 局限与上手建议
几个需要承认的局限。一是 0.5B 词元的训练规模,相比 Gemma Scope 在部分配置下的 4B-16B 词元,特征覆盖深度可能有差距,长尾特征的提取质量有待社区进一步验证。二是 SAE 在 instruct 模型上的重建质量普遍弱于 base 模型——已有研究(FAST 等)指出,针对 instruct 模型需要专门的训练对齐方法,Qwen-Scope 的具体训练设置在这一点上的处理需要查阅技术报告。三是 feature steering 对生成质量的副作用:放大某个特征往往会让该特征的语义"渗漏"到不相关位置,鲁棒性需要工程上做平滑。四是 14 组权重对 7 个模型意味着平均每个模型 2 组——选哪一层、哪种稀疏配置仍然依赖任务实验。
对不同角色的实操建议:
做模型微调与对齐的团队:优先关注训练侧用法,把 Qwen-Scope 当作 RLHF 的诊断工具,定位重复生成和语言混用的源头特征。这是 ROI 最高的场景。
做内容产品和 Agent 应用的团队:feature steering 可以作为 prompt 工程的补充工具,特别是在风格控制、敏感内容过滤这类用 prompt 难以彻底解决的场景。但不建议用作生产链路的主控手段,鲁棒性还不够。
做基础模型研究的团队:Qwen3.5 MoE 的 SAE 是目前唯一的公开资源,做 MoE 路由分析、专家职能解释、跨架构特征对比的窗口期相当短。
做评测的团队:用 SAE 特征激活做 benchmark 冗余度分析是相对新颖的思路,但需要先验证特征空间的稳定性,否则结论可能随训练种子波动。
整体看,Qwen-Scope 把可解释性从 alignment 团队的"安全工具"重新定义成了模型团队的"开发工具"。这一转向比单纯追逐更大的特征数有趣得多——它让 SAE 第一次有机会进入正经的工程考核体系,而不是只活在 NeurIPS 和 ICLR 的 mech interp workshop 里。下一个值得观察的节点,是社区能不能用这套权重做出 Qwen 团队自己博客里没列出的应用场景。
 AI 速览