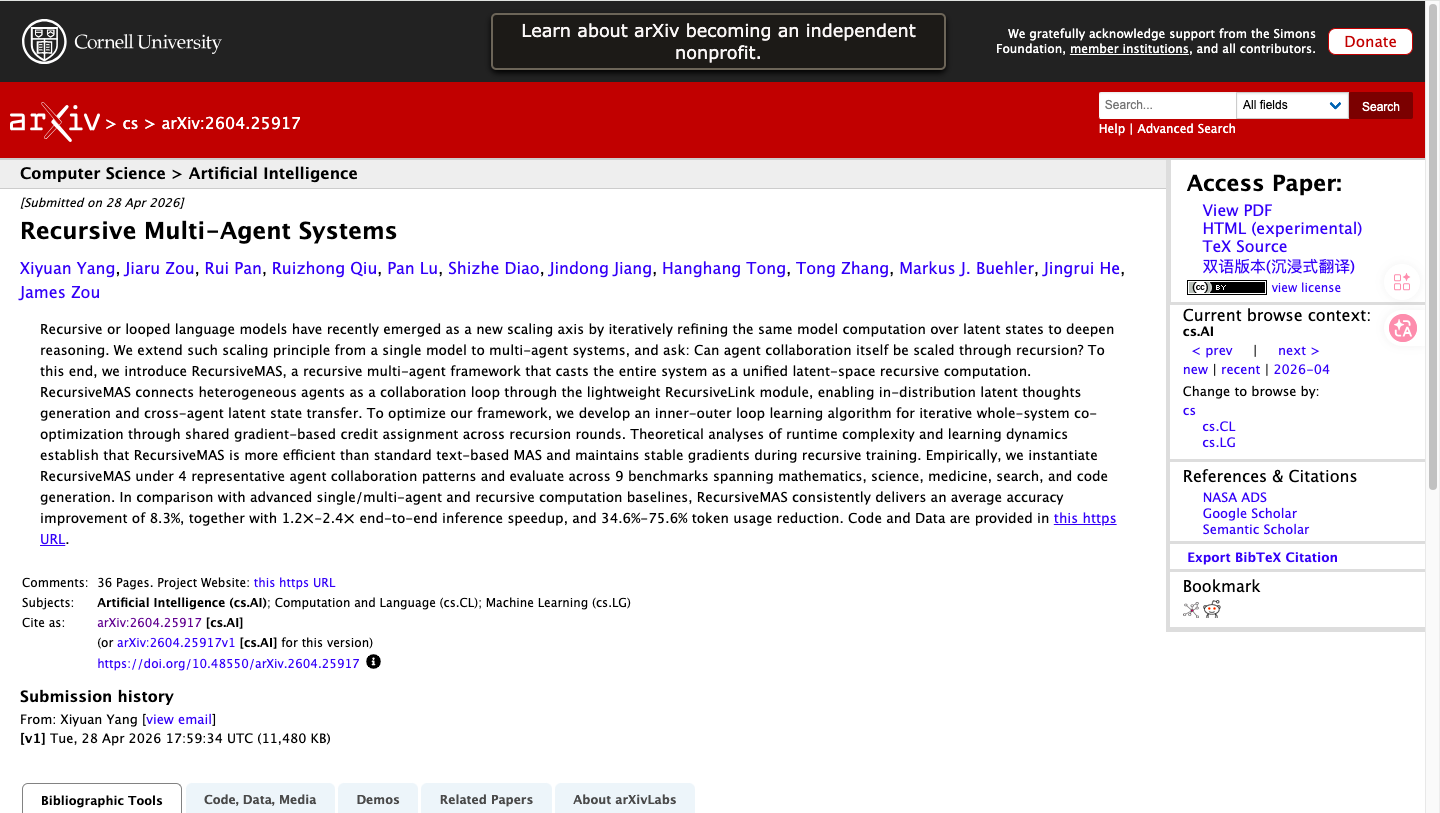
4月28日,arxiv上线一篇横跨Stanford、MIT、UIUC、HKUST四所顶级机构、12位作者联署的论文《Recursive Multi-Agent Systems》(arXiv:2604.25917),把过去半年AI研究界两条独立演进的技术路线——递归/循环语言模型(recursive/looped LMs)和多智能体协作框架(Multi-Agent Systems, MAS)——首次缝合到统一的潜空间递归计算结构中。论文给出的实证数据相当直白:在数学、科学、医学、搜索、代码生成五个任务族、九个benchmark上,相比当前最强的单/多智能体baseline,平均准确率提升8.3%,端到端推理加速1.2-2.4倍,token消耗减少34.6%-75.6%。如果数据可复现,这意味着MAS赛道下一阶段的scaling轴可能要从"堆agent数量"转向"加深递归深度"。
这不是一篇渐进式改进论文。从问题设定层面,作者直接发问"agent协作本身能否通过递归被scale"——这个问题在2025年底looped transformer、Universal Transformer、Quiet-STaR等工作之前根本不构成问题,因为大家默认agent之间通过自然语言文本传递信息。RecursiveMAS的提出实质上挑战了这个默认范式。
RecursiveLink把agent协作从"文字传递"升级为"潜空间状态传递"
理解这篇论文的关键,是抓住"latent-space recursive computation"这个核心结构。在传统text-based MAS框架(AutoGen、CrewAI、AgentScope、OpenClaw等)里,agent之间的协作发生在文本层——agent A生成自然语言输出,agent B把这段文本作为输入再生成下一段。这个机制的代价非常显著:每一轮agent切换都要经过"潜空间→token→潜空间"的双重转换,token成本叠加,且自然语言本身存在表达精度损失。OpenAI在GPT-Image-2 tape系列论文中观察到的"长程一次性输出 vs 迭代patch"风格分野,本质上也来自这个层面的设计选择。
RecursiveMAS的做法是把整个多agent系统建模成一次统一的潜空间递归计算。论文引入的核心模块叫RecursiveLink,作用是把异构agents(不同模型、不同角色定位)连接成一个协作循环,agent之间传递的不再是token化的自然语言,而是latent state——更准确地说,是论文称为"in-distribution latent thoughts"的中间表征。这种设计与近期looped language models的研究脉络一脉相承:与其让模型把思考显式化为文本再读回去,不如让思考在潜空间里直接迭代。
技术细节层面,RecursiveLink被论文描述为"轻量级模块"——意味着它不要求重训agent本身,而是作为连接层介入到agent间通信流程。这一点对工程落地非常关键:现有AutoGen、CrewAI生态里的agent定义可以被RecursiveLink"包装"接入,而不需要从头训练新模型。这种设计哲学和近期Hermes Agent的接入策略,以及Anthropic的MCP协议属于同一思路——降低agent生态接入成本,用统一协议层连接异构组件。 Inner-outer loop learning算法实现整系统协同优化
只有协作机制的论文不会发到arxiv。RecursiveMAS的另一半贡献是一套训练算法——inner-outer loop learning。这个算法解决的是一个看似抽象但工程上极重要的问题:如何让整个多agent系统作为一个统一对象被联合优化,而不是单独训练每个agent后再拼接。
具体实现上,论文把训练过程拆成内层循环和外层循环。内层循环处理单次递归内的agent协作动力学,外层循环处理跨递归轮次的credit assignment——也就是当一个最终答案出错时,如何把误差信号沿着递归链路反向归因到具体哪一轮、哪一个agent的潜空间状态贡献最大。这种gradient-based credit assignment的思路源自reinforcement learning和meta-learning领域,但应用到MAS递归训练是新颖结合。
理论分析部分,作者证明了两个关键性质。第一是runtime复杂度——RecursiveMAS相比标准text-based MAS在计算效率上有可证明的优势,这一点在论文实证数据中已经反映为1.2-2.4倍的推理加速。第二是learning dynamics——递归训练通常面临梯度爆炸或消失风险(这在RNN和早期looped transformer中都被观察到),论文证明RecursiveMAS的训练保持稳定梯度。这两个理论结果是论文能从工程trick上升为正式研究成果的关键支撑。
值得注意的是,论文同时强调RecursiveMAS对"in-distribution latent thoughts generation"的能力。这个表述背后是一个长期困扰潜空间方法的问题——latent state在递归过程中可能漂移出训练分布,导致后续agent处理时性能下降。论文似乎给出了某种正则化或约束机制保证latent state保持in-distribution,但具体技术细节需要查阅36页正文,abstract层面只能确认这是被显式处理的设计目标。
4种协作模式×9个benchmark全面验证,token消耗最高降低75.6%
实证部分的设计相当扎实。论文测试了4种代表性的agent协作模式——这4种模式具体是什么abstract没说,但参考MAS研究惯例,通常包括serial pipeline(串行流水线)、parallel debate(并行辩论)、hierarchical orchestration(层级编排)、cyclic refinement(循环精化)等模板。覆盖4种模式意味着RecursiveMAS不是只在某一种特定结构下work,而是作为一个general-purpose的协作框架被验证。
9个benchmark横跨5个任务族:数学(大概率包括MATH、GSM8K或AIME)、科学(GPQA Diamond或SciBench类)、医学(HealthBench或MedQA)、搜索(DeepSearchQA或BrowseComp)、代码生成(HumanEval、SWE-Bench或LiveCodeBench)。这个覆盖面几乎横跨了2026年Q2所有主流agent能力评估场景,结果的外推性比仅在单一benchmark上跑分要可信得多。
具体数据三个维度都有改进。准确率上,相比"advanced single/multi-agent and recursive computation baselines"——这个表述包含了当前最强的单agent模型(如GPT-5.5、Claude Opus 4.7)和最先进的MAS框架——平均提升8.3%。这个数字在2026年的frontier model竞争中很显著,要知道GPT-5.5相比GPT-5.4在Terminal-Bench 2.0上的领先也不到13个百分点,且付出了模型代际升级的代价。RecursiveMAS不换底层模型就拿到了8.3%的平均提升。 效率维度更值得产业关注。1.2x-2.4x的端到端推理加速意味着同样的query在RecursiveMAS架构下平均响应时间能砍到现有MAS的一半左右。token消耗34.6%-75.6%的降幅则直接关联到API成本——这个数字如果在生产环境复现,意味着以同样的性能上限,运行成本能压缩到原来的四分之一。对ChooseAI这类深度依赖agent链路做内容生产的平台来说,这种效率改进远比单纯的准确率提升更有商业意义。
12人跨机构合作背后的产业信号:MAS研究正在主流化
把作者列表当成产业信号读,能看出一些有意思的结构。论文12位作者覆盖至少4家顶级机构——Stanford(James Zou组)、MIT(Markus J. Buehler)、UIUC(Hanghang Tong, Jingrui He)、HKUST/UIUC(Tong Zhang)。其中James Zou是Stanford计算生物医学AI方向的代表人物,Markus Buehler是MIT材料科学+AI的标志性研究者,Hanghang Tong和Jingrui He是图神经网络与数据挖掘领域的UIUC双子星,Tong Zhang则是统计学习理论的权威。
这种跨机构、跨子领域的作者组合不是偶然。MAS作为一个研究主题,在2024年还主要是少数AI lab的内部工程探索(OpenAI Swarm、AutoGen等),到2025年下半年开始向学术界扩散,2026年Q2出现这种"4机构+12作者"的联合研究,标志着MAS已经成为主流AI研究议题之一。论文项目页recursivemas.github.io和code/data开源承诺,进一步降低了follow-up研究的门槛——按2026年AI研究的复现节奏,类似的latent-space MAS架构可能在3-6个月内出现多个独立验证。
对国内产业环境而言,这条研究线和阿里AgentScope、字节豆包Agent、智谱AutoGLM等国产MAS框架的演进高度相关。RecursiveLink这种"轻量级连接层"思路和AgentScope Tuner的设计哲学有共通之处,国产框架理论上有快速吸收RecursiveMAS核心结构的工程基础。Hermes Agent等agent平台如果选择把RecursiveLink作为可选模块集成进现有agent生态,token成本曲线可能在2026年下半年发生明显结构性下降。
局限:论文体量、训练成本、协作模式外推与生产环境差距
按学术论文的标准看,这篇工作的局限主要集中在三个维度。
第一,论文目前仅有v1版本,abstract层面给出的"平均8.3%提升、最高75.6% token减少"等数字是作者自报数据,独立第三方复现需要等到代码完整开放、其他研究组接入后才能验证。MAS领域过去出现过多次发表时数据亮眼但社区复现困难的案例,RecursiveMAS的复现性需要观察后续3-6个月的follow-up论文反应。
第二,训练成本和算力门槛在abstract中未披露。inner-outer loop learning是一种联合优化算法,理论上对训练算力的要求高于单独训练各个agent后拼接。如果RecursiveMAS的训练成本接近或超过等效底层模型的微调成本,那么对中小研究团队和工程团队就构成事实上的准入门槛。论文是否提供了pretrained RecursiveLink权重供下游使用,决定了这项研究的产业可及性,需要查阅36页正文确认。
第三,4种协作模式的外推边界未明。论文展示RecursiveMAS在4种代表性collaboration pattern下都work,但实际生产环境的agent结构往往是定制化、动态变化的——例如包含人类反馈环节的混合loop、包含外部工具调用的异构pipeline、包含安全审查节点的分层架构等。RecursiveMAS的潜空间状态传递机制在这些复杂结构下是否仍保持效率优势,论文未明确回答。从生产部署角度,团队最关心的"我现有的AutoGen/CrewAI项目能否直接接入RecursiveLink获得收益"这个具体问题,需要等待官方代码和文档公开后才能评估。
此外,潜空间方法长期存在一个未被论文显式讨论的局限——可解释性和可调试性的下降。文本层面的agent协作虽然token成本高,但每一步输出可读、可审查、可人工干预;切换到latent state之后,中间过程对外部观察者变成黑盒,这对生产环境的debug、审计和合规性构成新挑战。这个trade-off不会在benchmark数据中体现,但会在实际部署中显现。
 AI 速览