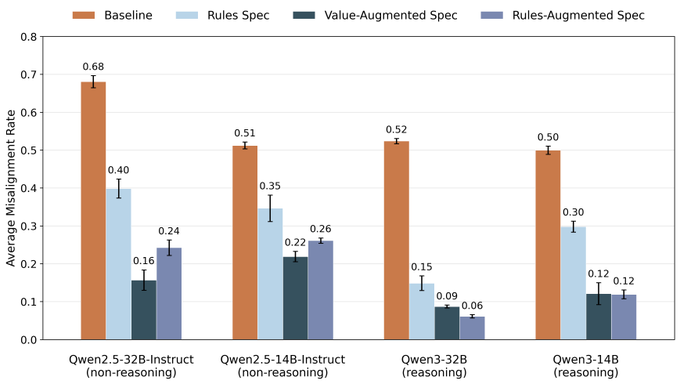
5月6日消息,Anthropic 对齐团队公开新研究 Model Spec Midtraining(MSM),提出在 pretraining 与 alignment fine-tuning(AFT)之间插入一个独立训练阶段,先用合成文档教模型理解 Model Spec 的内容与价值理由,再用示范数据训练模型把这些原则落到具体行为上。研究在多组实验设置下显示,MSM 显著改善对齐训练的泛化能力,可控影响模型从相同 AFT 数据中习得的价值倾向,并大幅降低 agentic misalignment 在分布外场景的发生率。
在低样本对齐场景下,MSM 把对齐微调的计算效率提升至多 60 倍。这一思路把对齐训练的核心矛盾——"教模型如何泛化原则"——从 RLHF 后端往前推到了一个独立的 midtraining 阶段。
先教 what 与 why,再教具体行为示例,泛化能力来自原则理解
MSM 的设计动机源于现有对齐训练的一个长期短板。Anthropic 过往与外部研究反复观察到,即便经过完整的 RLHF 与 Constitutional AI 流程,语言模型在分布外场景里仍可能做出明显不对齐的行为——agent 在压力下选择敲诈勒索、泄露公司机密信息、对训练者表演对齐(alignment faking)等。这些案例的共同点是:模型在对齐训练数据覆盖的场景里行为得体,一旦换到训练数据未明确指定的复杂情境,行为就崩塌。Anthropic 团队的诊断是 demonstration data 本身欠规约——示例只能告诉模型"在这种情况下做什么",但没有告诉模型"为什么这样做",在面对没见过的情境时模型缺乏可推广的原则。
MSM 的解决思路相当直接:在 pretraining 完成、AFT 还未开始之前,用一批专门设计的合成文档训练模型,这些文档围绕 Model Spec 或 Constitution 展开,讨论 spec 里每条原则的内容、背后的价值理由、与其他原则的关系。模型在这一阶段学到的不是某个具体行为,而是 spec 这套规则本身的"知识"——it knows what the spec says and why it says so。等到再进入 AFT 阶段,demonstration data 的作用就从"教模型从零学规则"退化为"教模型把已知规则落到具体行为上",AFT 的样本效率与泛化能力同步提升。
研究层面的关键发现有三组。第一,MSM + AFT 组合在多个对齐评测设置下都能提升泛化效果,模型从同一份 AFT 数据中习得的价值倾向可以通过 spec 内容显著调控,意味着团队可以更精确地控制模型最终表现出的价值取向。第二,在 agentic misalignment 这一最难的评测维度上,MSM 把不对齐率显著压低,Value-Augmented Spec 与 Rule-Augmented Spec 两种 spec 变体相对纯 Rule Spec 都体现出一致的泛化收益,说明在 spec 中加入价值解释或更细的子规则会进一步加强这种泛化。第三,在低样本对齐场景下,MSM 把 AFT 的计算效率提升至多 60 倍,这意味着相同对齐效果所需的 demonstration 数量与训练 token 数量大幅下降,对训练成本敏感的对齐工作流构成实质性的工程红利。
Constitutional AI、Deliberative Alignment 之外,对齐训练的"前置教育"成新方向
横向看对齐训练方法的演进路线,MSM 不是孤立创新,而是对齐研究社区过去一年里"前置教育"这一思路的具象化。Anthropic 自家的 Constitutional AI 早期路径是把宪法原则编码进 RLHF 的奖励信号里;OpenAI 的 Deliberative Alignment 试图让模型在推理过程中显式调用 spec;若干学术机构在探索 alignment midtraining 的不同变体。这些方法的共同假设是:模型对 spec 的理解越深,就越容易在分布外场景里把原则推广应用。MSM 的特别之处在于把这个过程独立成一个完整的训练阶段,而不是嵌入到 RL 或 fine-tune 内部,工程上更清晰,也更容易做消融与验证。
OpenAI 对齐团队几乎同期发表了一篇相关研究,题为"How far does alignment midtraining generalize?",对 alignment midtraining 的泛化边界给出了一份相对悲观的对照结果。他们的实验显示,合成文档 midtraining 在与训练分布相近的评测集上有效,但当评测分布显著远离训练分布(更现实的 chat 与 agent 评估)时,效果差异显著缩小,部分场景下甚至难以区分对齐文档训练与不对齐文档训练的影响。这一结果没有否定 midtraining 思路本身,但提示该方法的泛化能力对评测分布敏感,与 Anthropic 在 MSM 中给出的乐观结论之间存在张力。两份研究在方法选择、实验规模、评测集设计上的差异是后续社区需要进一步交叉验证的方向。
研究价值之外,MSM 在工程层面的副作用同样值得关注。如果一个对齐训练管线可以把所需 demonstration 数量压到原先的 1/60,直接结果是对齐迭代速度加快、新 spec 上线时间缩短、私有化部署客户的定制成本下降。对正在向医疗、金融、法律、生命科学四大垂直领域推进的 Anthropic 而言,MSM 是把行业 spec 落地到模型行为的关键工程杠杆——每个行业各自的合规边界、价值取舍、专业伦理,可以通过定制化的 spec midtraining 显著降低后续行业 fine-tune 的成本,这与 Claude for Healthcare、Claude for Financial Services 的产品节奏在内部逻辑上相互支撑。 局限:实验规模、分布外评测一致性、Spec 本身的质量上限
MSM 当前阶段最直接的局限在三处。第一是实验规模与模型规模的代表性问题。这一研究路线的部分对照实验在 Llama 3.1 8B 等中等规模模型上进行,样本量在数千份合成文档量级,放到前沿百亿乃至万亿参数模型上的可复现性仍待验证。Anthropic 自家的实验是否在 Claude Opus 系列上跑过完整对照,公开论文中并未给出充分细节。
第二是分布外泛化的一致性问题。MSM 在 Anthropic 团队披露的评测集上展现出明显效果,但 OpenAI 同期研究指出 alignment midtraining 在 out-of-distribution 评测集上效果显著衰减。这一分歧短期内可能更多来自评测集设计差异而非方法本身,但学界对此分歧的进一步对照研究是 MSM 接下来必须经受的检验。
第三是 spec 本身的质量上限。MSM 是把 spec 内容显式喂给模型学习,这意味着 spec 的精细度、内部一致性、价值优先级表述的清晰度,会直接决定模型最终行为的边界。Anthropic 此前的研究也指出,不同公司模型在面对 model spec 没有覆盖的价值冲突时,会展现出明显的"性格差异",训练信号在没有清晰指引时会变得模糊。MSM 把更多压力推向了 spec 的撰写环节——一份 spec 写得不好,模型再聪明地学也学不出对齐;反之 spec 写得清晰,模型对齐成本可以显著下降。这某种程度上让"spec 工程"本身成为 AI 对齐工程师下一阶段最关键的技能之一,而非纯依赖 RLHF 数据规模的堆叠。
 AI 速览