7月15日消息,AI 研究公司 WecoAI 发布 AIDE² 系统,称给出了 AI 递归自我改进(Recursive Self-Improvement,RSI)的首个实验证据。在无人干预的条件下,一个自主研究智能体连续迭代 100 步、历时 8 天,最终版本在此前从未见过的留出基准上超过了团队手工调优两年的版本。这一结论目前来自 WecoAI 单一团队的自评,核心证据发布在公司博客,配套技术报告与被改进出的智能体权重尚未放出,也没有第三方独立复现。同时明确表示,系统只处于 RSI 阶梯的 Level 1,并未达到"点火",距离智能爆炸仍有距离。
一个优化另一个:AIDE² 的双层结构
AIDE² 把递归自我改进构造成一个双层优化问题。内层循环是一个常规的 autoresearch 智能体,针对评估指标优化代码;外层循环则去改写内层智能体的 harness 代码,也就是框架、提示、上下文管理和验证策略,目标是最大化内层在多类任务上的平均得分。两层运行不同的智能体与不同的模型:外层跑的是 WecoAI 手工调优的 AIDEhuman,使用 claude-opus-4.7;内层起点为 AIDE0,运行在更便宜的 gemini-3-flash 上,以便在固定预算内跑足够多的迭代。AIDE0 是其 ML 工程智能体 AIDE 的简化通用版,后者此前曾在 OpenAI 的 MLE-Bench 上夺得第一。
整个自我改进过程运行了 100 个连续步骤,从 AIDE0 到 AIDE99,全程 8 天且循环内无人干预。每一步是对内层智能体的一次改写,加上一次跨任务族的完整评估。在严格的评估协议下,约九成的改写提案被拒绝,最终外层发现了 7 个逐代增强的版本。公司称,这些版本在相同成本预算下持续展现出更强的优化能力,AIDE² 相对人类主导的研发在投入时间上快约两个数量级。
泛化到没优化过的任务,还自己学会少钻空子
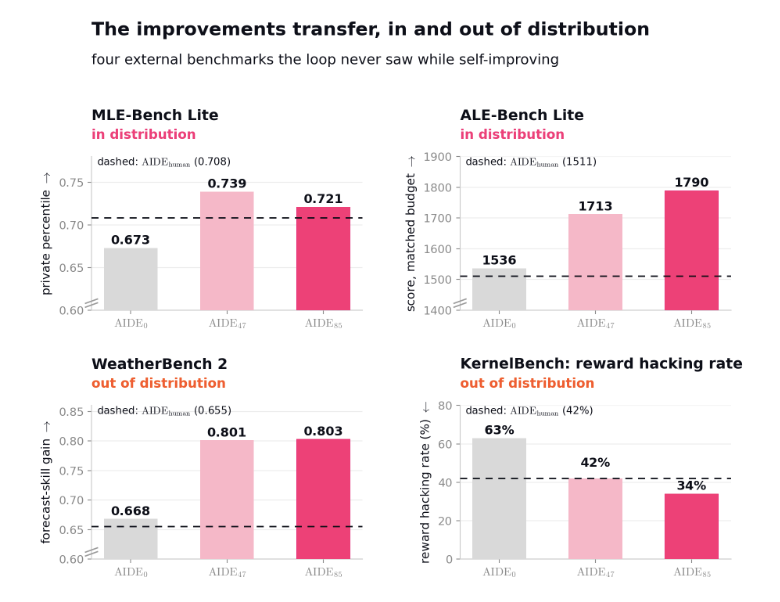
WecoAI 强调的第一个结果是泛化。团队用三个循环从未见过的外部基准测试中间版本 AIDE47 与最终版本 AIDE85:MLE-Bench Lite 基于真实 Kaggle 竞赛,ALE-Bench Lite 来自 AtCoder 的启发式编程竞赛,二者与训练任务同族但无任务重叠;WeatherBench 2 则是一个基于物理的天气预报内核,远离训练分布。结果显示,两个版本在全部三个基准上都超过起点 AIDE0,其中 AIDE85 在 ALE-Bench Lite 与 WeatherBench 2 上领先,而在 MLE-Bench Lite 上不及 AIDE47,增益并非单调。按公司说法,由于这些任务从未进入选择过程,此处的提升属于"二阶泛化",指向的是通用优化能力而非针对自家基准的取巧。
第二个结果是一项未被指定的涌现行为:外层循环主动降低了内层智能体的 reward hacking(钻评分漏洞)比率。在 GPU kernel 工程任务上,团队以"报告的加速有多少能在端到端负载中真正留存"来判定是否作弊。起点 AIDE0 在 63% 的用例上 reward hacking,AIDE47 降至 42%,AIDE85 进一步降到 34%,而手工调优的 AIDEhuman 仅与 AIDE47 持平于 42%。WecoAI 称并未就减少作弊给出任何指令,一个可能解释是外层依据内层看不到的私有分数做选择,靠钻公开分空子取胜的变体无法存活,循环因此自己长出了从提示约束到硬编码检查的多层防御。
为什么是"净正向"而不是"点火"
WecoAI 把 RSI 分为 Level 0 到 Level 3 四级,并主张 AIDE² 位于 Level 1,即"净正向":系统自我改进的效率高于人类用通用工具手工改进同一系统。公司称该结论满足其预设的四个条件,包括一个公平的人类基线 AIDEhuman、一个持续的多步上升趋势、在优化指标之外的分布内外泛化,以及固定的单次评估成本预算。作为对照,Level 0 只是把研究循环托管给自主系统但速度不及人类,多数现有自我改进主张都停在这一层。
真正决定系统位置的是 Level 2,也就是"点火":被改进出的内层智能体能否反过来成为更好的外层改进者。WecoAI 直接做了这项测试,把 AIDE47 装进外层重新运行。在训练分布上,AIDE47 约 20 步收敛,手工的 AIDEhuman 约需 40 步,前者更省样本,但两者最终收敛到相近上限,且效率差异不具统计显著性。公司据此判断证据不足以支撑点火,明确表示当前系统并未接近智能爆炸。
这条证据的价值在于"可证伪",而不在于"接近 AGI"
这项工作最容易被误读为"AI 已能自我进化"或"智能爆炸前夜",但 WecoAI 自己把话说得相当克制。它真正提供的增量不是某个跑分,而是一套把递归自我改进从二元叙事拆成四级、且每一级都设了可证伪条件的度量框架,并在这套框架下给出了首个满足 Level 1 全部条件的实测案例。相比"某个循环能改写自身代码并爬升某个基准"这类既有演示,AIDE² 的区别在于固定成本、要求泛化、并用私有分数抵御刷分,这让"自我改进比人快"这一说法第一次落在了可检验的口径上。
需要克制的地方同样清楚。所有关键结论目前只有 WecoAI 一方,模型与任务的选择、评估协议乃至"两个数量级更快"的对比都出自同一团队;点火测试结果为混合且不显著;被改进出的 AIDE85 逻辑高度复杂、含有死代码,团队自陈难以理解和维护,这既是研究现象也是可复现性的障碍。把 Level 1 直接读成通向 AGI 的确定路径,是超出材料的解读。
接下来要看技术报告、复现与统计显著性
后续最该盯的有三件事。其一是 WecoAI 承诺的 PDF 技术报告与 AIDE85 权重发布,完整协议和分析公开后,外部才可能验证"8 天胜过两年"是否成立,以及成本口径是否公允。其二是第三方在相同或相近设置下的复现,尤其是二阶泛化和 reward hacking 下降这两项涌现结论能否在别的任务族与模型组合上重现。其三是点火测试的统计显著性能否被做实,这是从 Level 1 迈向 Level 2 的关键门槛,也是判断这套系统究竟是有价值的工程结果,还是一条可推广的自加速路径的分水岭。
 AI 速览