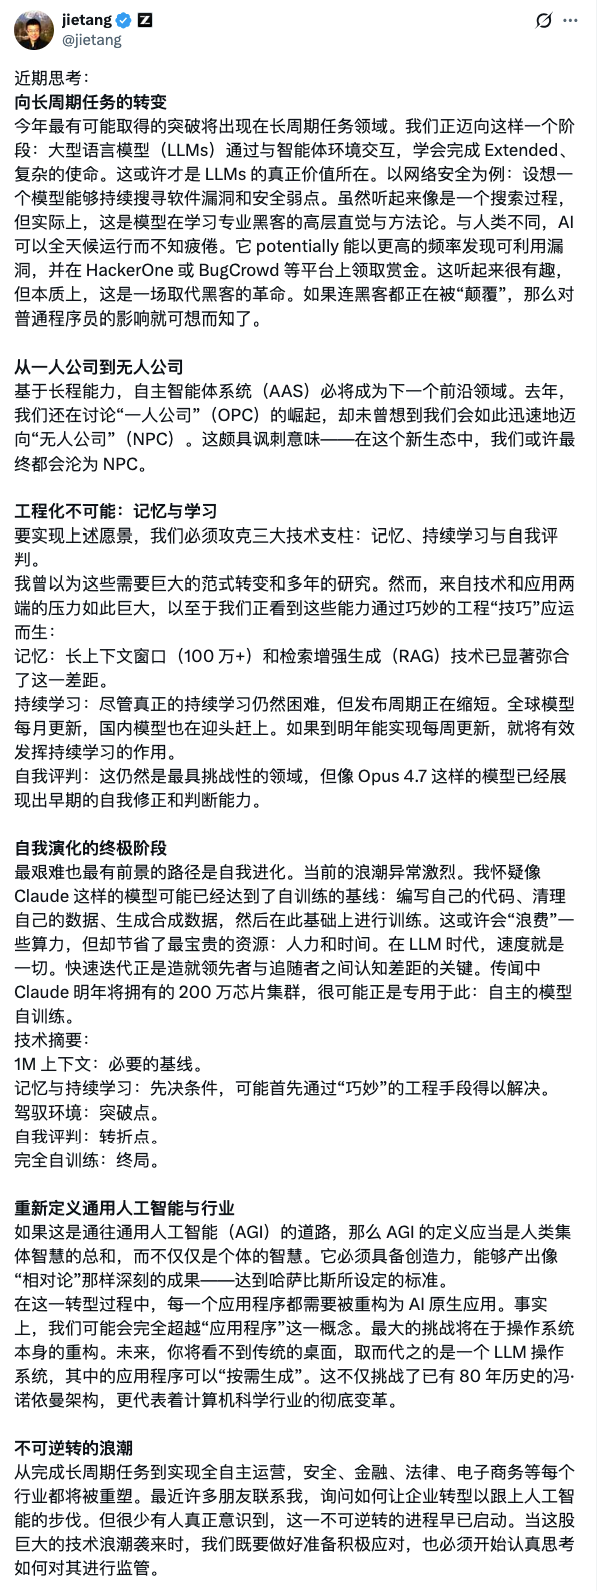
5月13日,智谱AI创始人兼首席科学家唐杰发布了一篇关于Agent长任务、自主智能体系统(AAS)、自我演化的思考。文章把长任务列为今年最可能突破的方向,把记忆、持续学习、自我评判称为三大技术支柱,把"无人公司"(NPC)和"完全自训练"作为终局描绘出来。这篇文章在AI圈内被广泛转发,有同行私下问起怎么看。结合最近做ChooseAI内容选题时积累的几个判断,顺着唐杰这条思路再往下走一段,把几个延伸出来的框架一并记下来。
唐杰的几个判断,逐条接着想下去
唐杰的核心判断是"今年最有可能取得的突破将出现在长周期任务领域",方向上没问题。XBOW、Anthropic的红队评估、HackerOne近期接受AI提交的赏金,以及Claude Code、Cursor agent mode、Devin、Manus这一批产品的相继落地,都验证了这条路径在走通。 不过例证的选择上,有个可以补充的视角。用"自动挖洞领赏金"做切口直观,但2026年5月的现实是,长任务最主流的落地其实是coding agent和deep research类工具,而非bug bounty。把漏洞挖掘等同于"取代黑客的革命",可能低估了APT级别红蓝对抗中环境建模、社工和持续渗透的复杂性——这些目前AI离独立操作还很远。
三大支柱"工程化解决"的判断,可以再拆开看。长上下文+RAG处理记忆是当前业界共识,这点成立。但用"模型发布周期缩短"来等价持续学习,严格说不是同一件事——真正的online learning(推理时持续更新权重)至今没有公开商用方案,每月或每周发版本质上还是离线训练。自我评判方面,Opus 4.7的self-critic在简单任务上work,在长链agent任务中错误累积仍是工程难题,这部分的难度可能比文章描述的更大。
至于"无人公司"和"自训练终局",当前阶段更接近行业愿景而非可执行路线图。从OPC(一人公司)到NPC(无人公司)的修辞很有传播力,但2026年的现实是各类AAS的实际任务完成率远低于演示视频,智能体在长链路任务的稳定性是行业共同短板。所谓"Claude明年200万芯片集群专用于自主自训练"也没有公开来源支撑,目前更接近行业流言。 把AGI定义为"人类集体智慧的总和"、要"产出像相对论那样深刻的成果",这个标准跟哈萨比斯的"诺奖级"宣言一脉相承,更适合作为长期愿景的锚点。在实务层面,业内对AGI的讨论已经在转向分级体系(OpenAI的5级、DeepMind更细分的Level框架),这类定义至少能映射到具体能力测试,对企业战略和监管讨论有更直接的落点。
真正值得肯定的是宏观方向感。LLM-OS、应用按需生成、冯诺依曼架构面临挑战,这些观察方向是对的,Anthropic的Skill体系、HyperFrames把HTML当视频源码、各类Computer Use探索都指向类似终局。
长任务的真正阻力:上下文侧的红利,模型侧的天花板
文章里没有展开的一个关键问题是:长任务的根本阻力到底在模型侧,还是在上下文侧?
短答是:当下是上下文侧,但终局是模型侧。
上下文侧的瓶颈是显性的、可测量的。Claude在长agent任务中的失败模式分布,大头不是"模型不会做",而是"模型在第40步忘了第3步的约束"、"在第80步把工具调用参数填成了第20步的旧值"、"长上下文里的中间段落注意力衰减"。这是engineering可治的——压缩、分段、外置memory、checkpoint回放、sub-agent隔离上下文,Claude Code的/clear、Cursor的context管理、Manus的浏览器状态序列化都在做这件事。把上下文工程做扎实,长任务完成率会有可见提升。
但模型侧的瓶颈是隐性的、决定上限的。它不是"记不住",是"不会想"。具体三件事:
第一,没有真正的planning。 当前模型的plan是把任务展开成步骤列表,但中途遇到环境变化、子目标冲突、需要回溯重规划时,大多数模型的处理方式是硬着头皮按原plan走,或者推倒重来。真正的hierarchical planning——像人类那样动态调整子目标的优先级——还没解决。
第二,没有真正的自我评判。 模型生成一个错误结果→自我审查环节也是模型→错误被合理化通过。这不是上下文不够长导致的,是奖励信号本身就不可靠。RLHF训出来的critic和actor同源,critique能力的上限就被actor能力锁死。
第三,没有真正的探索-利用平衡。 长任务里经常需要"先试一下不确定的方向,不行再回退",但当前模型的采样策略要么过于保守(总走最高概率路径)要么过于发散(temperature拉高就胡言乱语),没有像AlphaGo那种MCTS式的有原则探索。
判断是:未来12个月,上下文工程的红利还能吃,完成率会从30%涨到60%量级;但要从60%涨到90%+,必须等模型侧在planning、self-critic、探索策略上有架构级突破。
唐杰把"自我评判"列为转折点,这个排序是对的,只是低估了难度。
长任务的三档:Demo级、生产可用级、自主可托付级
接下来的问题是:长任务交付到什么程度才算具备长任务执行能力?
这个问题业界故意把标准模糊化——对demo和融资都有利。我给一个三档框架:
Demo级(当前主流): 单次成功率20-40%,失败时不知道自己失败,需要人类全程旁观。这一档可以拍演示视频、写blog、发推,但不能真正交付。SWE-Bench上的成绩、Manus的演示任务大多在这一档。识别方法:任何"成功率"宣传超过50%的,先问测试集是不是私有的、有没有retry、有没有human-in-the-loop。
生产可用级(部分场景已到): 单次成功率70%+,失败时能自己识别并报告"我搞不定这个",可以异步运行人类抽检。Claude Code在熟悉的repo里改代码、Cursor agent改前端bug、deep research类工具写调研报告,这些场景已经到了这一档——敢挂着它去开会,回来大概率能用。识别方法:用户是否敢于不看过程只看结果。
自主可托付级(真正的长任务): 单次成功率90%+,失败时有完整的rollback机制,可以连续运行24小时+无需人类干预,且失败成本可控。当前没有任何公开产品稳定到这一档。最接近的可能是一些垂直领域的专用agent(某些量化交易系统、某些工业控制),但它们严格说不是LLM-based agent,是规则+模型的混合体。
判断标准就一条:能不能"忘了它"。 给它一个任务,关掉屏幕去做别的事,几小时后回来看结果——如果做这个动作时心里发慌,那就不算具备长任务能力,只是把短任务串起来跑而已。按这个标准,2026年大部分所谓的"agent产品"都不及格。
MCP/Skill/MD/HTML:计算优化是真,叙事革命是包装
第三个值得拆的问题是:MCP、Skill、MD、HTML这一波"AI原生"工具体系,在计算侧是真的token消耗变化,还是叙事逻辑?
答案是:在结构上是token消耗优化,在传播上被包装成叙事革命。 两件事都成立,但权重不一样。
MCP本质是把工具调用的schema标准化。token变化是双向的——每次调用都要把tool list塞进system prompt,初始token开销增加;但标准化协议避免了per-tool的prompt定制,减少了重复描述的冗余。净效果是初期消耗增加、长期边际消耗下降。不是革命,是基础设施。
**Skill(SKILL.md)**是真正的token优化设计。核心原理是progressive disclosure——SKILL.md本身只有几百token的元信息,模型按需展开具体内容。对比之下,把所有"如何创建pptx"的知识直接塞进system prompt,光这一个技能就是几千上万token。skill机制把"知识"从"必须常驻"变成"按需加载",对Anthropic自己的成本和用户的有效上下文都是显性收益。这一档的优化是实在的,不是叙事。
MD作为输出格式几乎不影响token,但影响下游可用性。模型用markdown输出和用纯文本输出,token数差异在5%以内。MD的价值在于结构化——下游程序解析、人类扫读、版本管理都方便。这一档是工程便利,不是计算革命。
HTML作为中间层(HyperFrames的思路)有点特殊。HTML作为"视频源码"、"PPT源码"、"UI源码"的统一表示,带来的不是token减少而是叙事单元的统一。模型生成HTML的成本和生成专用DSL差不多,但HTML可以被所有现有工具链消费(浏览器、headless render、Puppeteer截图、CSS动画引擎),等于复用了过去30年的Web基础设施。节省的不是token,是工程量。
统一规律是:这些机制都在解决同一个问题——如何让有限的上下文窗口承载更多的有效信息密度。 Token窗口本身是物理约束(显存、注意力计算复杂度O(n²)),硬扩窗口的代价是平方级别的计算成本。所以业界的真实做法是"窗口够用就行,真本事是把窗口里塞的东西更高效地组织"。MCP、Skill、HTML都是这套组织术的不同切面。
唐杰文章里"长上下文+RAG解决了记忆"是简化说法。更准确的表述是:长上下文是基础,但围绕长上下文的信息密度组织才是真正的工程战场。
从说到做到优质化:说100做30、优20%的真实坐标
把前面的判断收口,会推到最后一个量化问题:从"说能做"到"真正做",再到"做到优质",转化率究竟有多少?
这两个量级差距比大多数人想象的大。
说到做的转化率,大约30-50%。
损耗主要来自三个地方:第一是benchmark泄漏与过拟合,公开测试集大多被训练过,发布时宣传的"70%通过率"在私有测试集上通常掉到40-50%;第二是demo cherry-pick,演示视频基本都是从N次尝试里挑出的最好那一次,Manus官方后来披露过内部数据,真实任务的单次成功率在30%量级;第三是环境脆弱性,agent在受控demo环境里跑得好,放到真实环境(网页改版、API限流、文件路径有中文空格)就崩。
做到优质化产出,再砍一半,大约15-25%。
第一个损耗是质量长尾分布。coding agent能写出能跑的代码,但代码风格、可维护性、边界条件处理这些"工程素养"的部分非常拉胯,senior工程师改AI生成的代码,通常要花掉自己重写的50-70%时间。第二是事实性与一致性问题,deep research能生成5000字调研报告,但里面的数据、引用、人名、时间戳交叉验证后,通常20-30%有问题——这是LLM的根本限制,不是工程能修的。第三是审美与判断力的真空,AI写的blog能读但有"AI味儿",AI做的设计能用但一眼能识别,优质化的最后那20%是品味,不是能力。
把这套尺子套到具体垂类,大致分布是这样:
- Coding(熟悉repo的小改动): 说90,做70,优质50。当前最成熟的场景。
- Coding(从零写新项目): 说80,做40,优质15。新项目缺少上下文锚点,容易走偏。
- Deep Research(信息汇总): 说85,做60,优质25。汇总框架能给,深度洞察严重依赖人。
- SEO文章生产: 说80,做55,优质20。可读没问题,达到benchmark逐项拆解+竞品对比贯穿+高信息密度的标准,大部分输出需要50%以上的人工重写。
- 浏览器agent(订机票、填表单): 说70,做25,优质10。环境太脆弱,任何UI改版都会击穿。
- 视频生成: 说75,做50,优质10。单镜头质量不错,有叙事、有情绪、有镜头语言的成片优质率极低。
- 社交媒体内容(小红书/抖音): 说70,做45,优质15。能批量生产合格内容,但能"爆"的那种里AI元素必须降到20%以下。
一个反直觉的判断在这里出现:优质化的瓶颈不在AI能力,在人对AI的使用方式。
同样的Claude Opus 4.7,不同的人用,优质率可以差5倍以上。决定差距的是:能否把任务拆成AI擅长的子任务(而不是甩一个大问题)、能否识别AI输出的失败模式(而不是无差别接受)、能否在关键节点注入自己的判断(而不是全盘代笔)、能否建立稳定的工作流(而不是每次重新摸索)。
对建立了工作流的人,优质化可以做到50-70%;对没建立工作流的人,优质化常年卡在10-15%。 这个分化在2026-2027年只会越来越大,因为模型在底层能力上的差距在收窄(各家都60-70分),但应用方法论上的差距在拉开。
一个结论:模型差距收窄,方法论差距拉开
回到唐杰这篇文章本身。它的价值在于给出方向感——长任务、智能体、LLM-OS、AI原生应用,这些判断在2026年5月的坐标上都成立。需要补充的部分,是技术路径的难度系数:"工程化突破"没有那么轻松,"无人公司"和"完全自训练"目前还不是路线图上的明确节点,而是更远期的愿景。
但真正值得从业者关注的不是这些远期愿景,是当下能落地的部分:
- 大部分"agent产品"还在Demo级,不要被演示视频带偏。
- MCP/Skill/HTML是真实的信息密度组织术,值得深度跟进。
唐杰看到了浪潮,但浪潮里能不能站稳,看的是每个团队、每个个人的工作流积累。模型能力是公共品,方法论是私人资产——这是这一轮AI周期里最容易被低估、也最值得投入的东西。
 AI 速览