近日 OpenAI 正式发布 GPT 5.6 系列模型,同步完成产品架构大调整:将原 Codex 深度整合进 ChatGPT 体系,拆分工作、开发、聊天三大场景,配套多档位模型与工具能力升级。本次更新不仅提升了单模型性能与性价比,更推动 AI 生产从单模型调用转向多角色协同的工作流模式,搭配针对性提示词可大幅释放长任务执行与项目落地效率。
一、产品架构重构:三区分层覆盖全场景需求
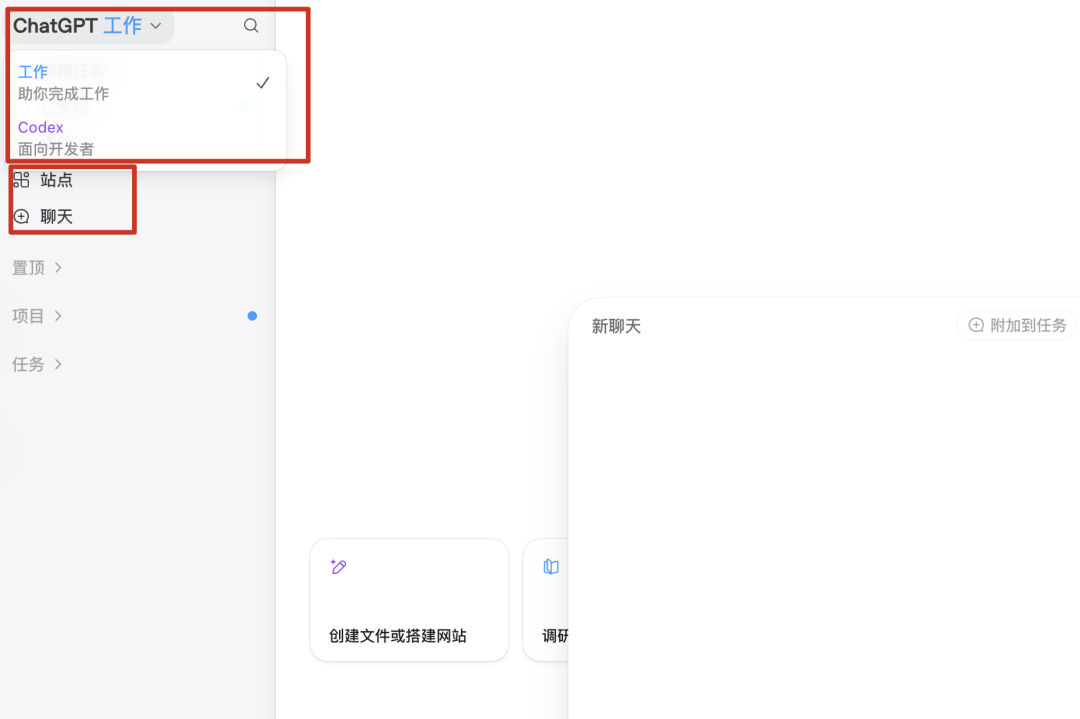
本次更新最大的产品层面变化,是 ChatGPT 完成了对 Codex 的整合升级:原 Codex 正式更名为 ChatGPT,经典聊天版更名为 ChatGPT Classic,界面拆分三大功能区。
工作区主打通用办公任务,隐藏代码执行过程,对标 Claude Cowork 模式,适合非技术用户完成文档、方案、调研类工作; Codex 区面向开发者,保留代码差异对比、合并请求等专业开发能力;
聊天区承接传统对话需求,整体形成从办公到开发的全场景覆盖。
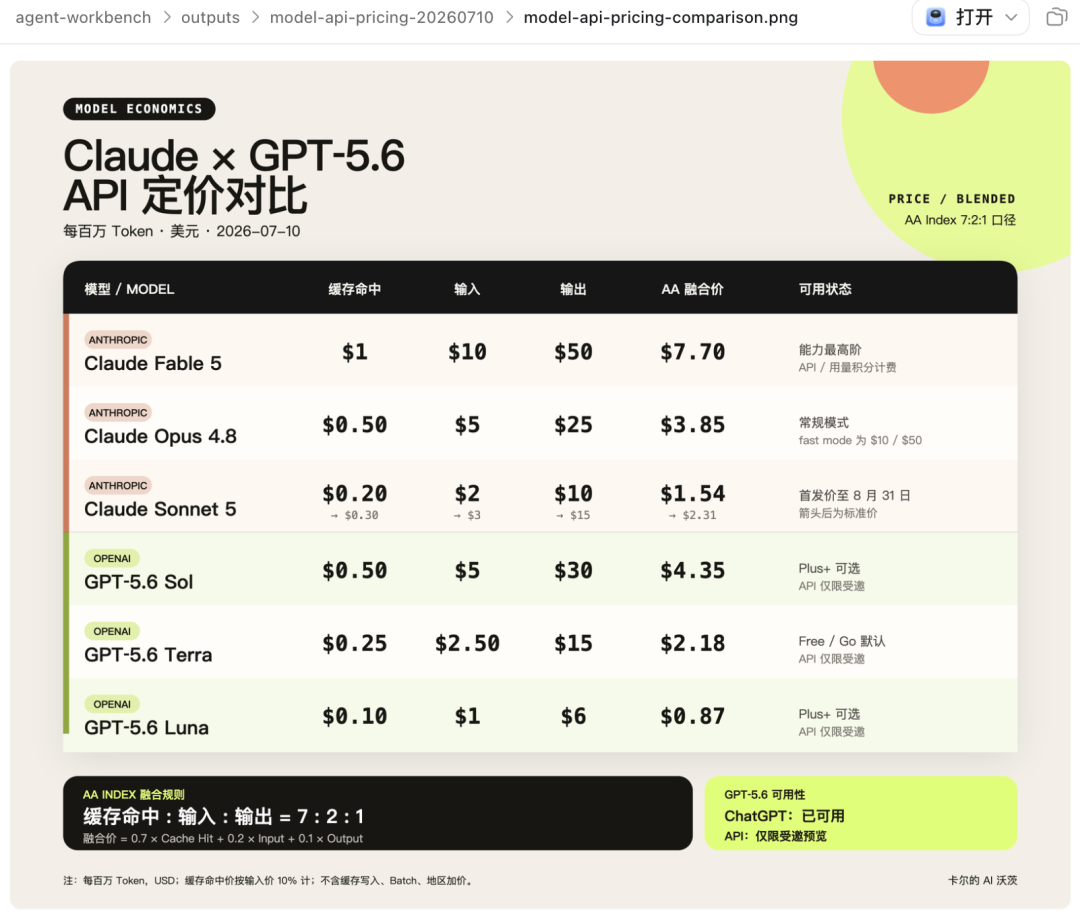
配套工具同步升级:新增站点部署功能,对话生成的网页可一键发布为可分享的在线站点;内置浏览器支持导入密码与 Cookie,新增多标签页与文件下载能力,自动化操作场景的实用性大幅提升。模型层面分为三档:Sol 超大杯主打复杂推理与长时自主任务,上下文从 272k 升级至 372k,新增 max 深度思考、ultra 多子代理并行两个推理档位;Terra 大杯性能接近 GPT-5.5,定价仅为其一半;Luna 中杯主打轻量快速响应,适配日常轻量需求。
二、性能与性价比:长任务执行优势突出
GPT 5.6 Sol 的核心定位是强执行型旗舰,与 Claude Fable 5 形成明显的能力互补。
Fable 5 更擅长顶层规划与创意发散,但容错率更低;GPT 5.6 Sol 的目标驱动与任务闭环能力更强,尤其擅长数小时至数天的长周期任务,执行过程更稳定不易出错。速度层面,依托 Cerebras 芯片加速,Sol 推理速度可达 750 tokens/s,比 Fable 5 快约 10 倍,大幅缩短重型任务的等待时间。定价上 Sol 输入 5 美元 / 百万 Token、输出 30 美元 / 百万 Token,相比 Fable 5 成本降低 43.5%,性价比优势显著。
目前 GPT 5.5 与 5.6 共用 Spud 底座,而 OpenAI 已规划直接推出全新大底座的 GPT 6,对标行业 Mythos 架构,后续将带来阶跃式能力升级。
三、三类高价值 Prompt 落地提效
结合本次升级的工具与能力,三类提示词可最大化释放模型价值。
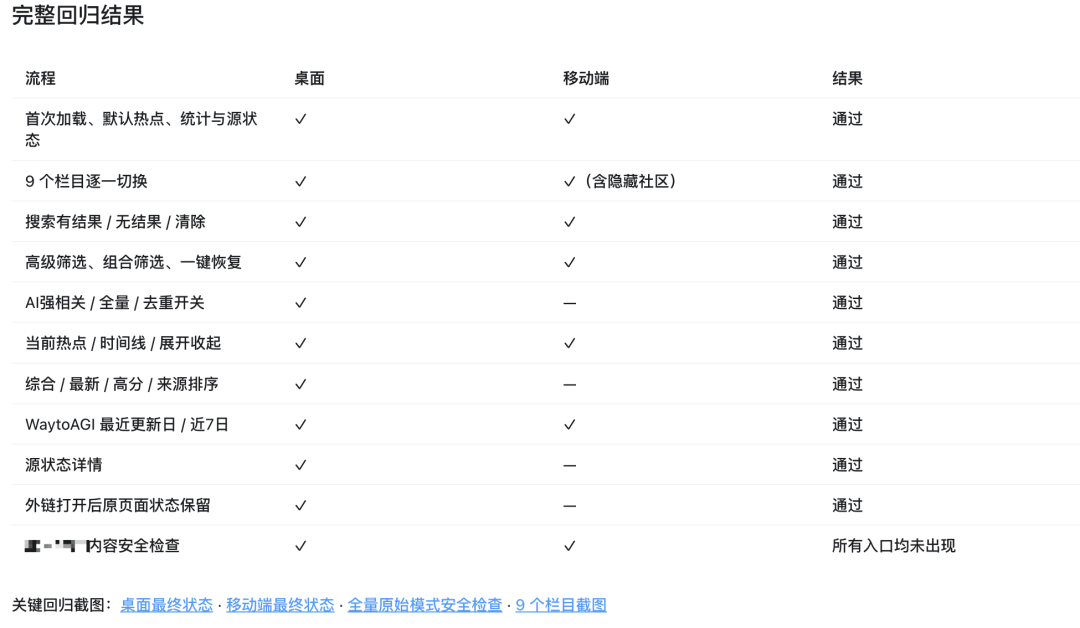
第一类是纯黑盒用户走查,利用浏览器自动化能力模拟真实用户操作,完整走完注册、支付、设置等核心流程,不读取代码仅通过真实点击测试,按严重程度输出含复现步骤、根因分析、修复方案的问题报告,还可自动修复后二次验证,适合产品上线前快速自测。
第二类是红队计划审查,在项目启动前让模型充当反对者,从六个月后失败的结果倒推核心风险点,识别未验证的假设、被忽略的失败场景与过度乐观的估算,针对每个风险给出触发条件、失败代价与最小验证实验,最终给出执行建议,大幅降低项目试错成本。
第三类是行动规范注入与多模型编排,基础版将 Fable 5 的高效执行规范注入提示词前缀,让模型做到结论先行、最小方案、实证汇报、按需暂停,显著提升执行利落度;进阶版可搭建四模型协同工作流:Fable 5 负责顶层规划,Opus 4.8 处理深度推理子任务,Sonnet 5 承接常规开发,Codex 提供独立技术视角,高风险环节采用背对背验证,兼顾成本与可靠性。
四、行业趋势:从单模型比拼到工作流协同
本次更新也折射出 AI 行业的新竞争逻辑:单一模型的跑分比拼不再是唯一核心,模型组合与工作流设计正在成为新的效率增长点。
不同模型各有擅长,合理分工搭配可在成本、效率、质量间找到最优解。行业层面规模定律仍在持续发挥作用,海外 GPT 6 蓄势待发,国内 DeepSeek V4 正式版、MiniMax M3 Pro 等大参数模型也即将上线,算力与算法的协同升级还将持续推高行业上限。 对普通用户而言,不必执着于 “最强模型”,根据任务类型选择适配模型、搭建标准化工作流,才是当下最高效的 AI 使用方式。
 AI 速览