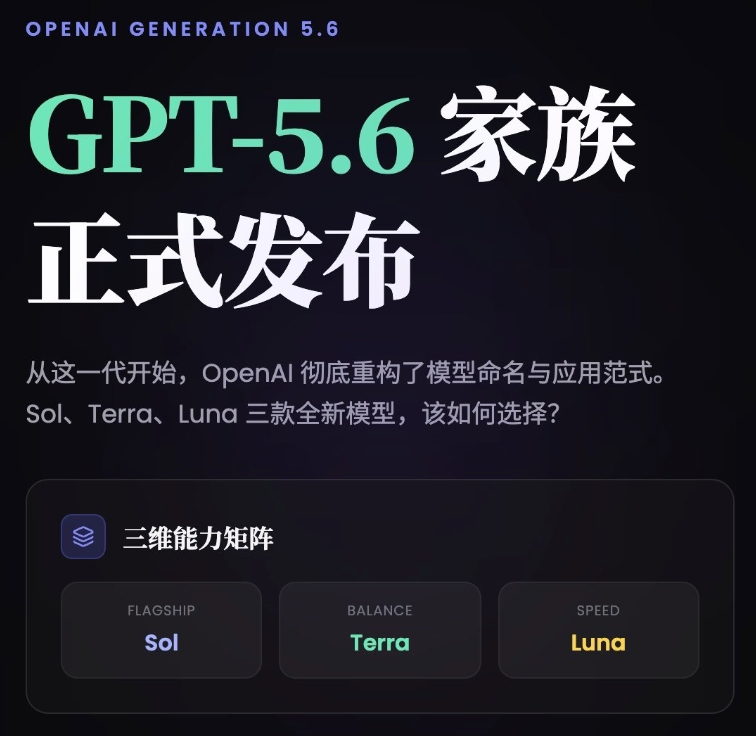
GPT 5.6各版本区别核心就在能力、速度、成本这三个维度的权衡上——Sol是旗舰档,追求极致推理能力;Terra是均衡档,性能接近老版GPT-5.5但价格砍半;Luna是轻量档,专为高频简单任务优化,价格最低但不支持多模态。这三个不是简单的"大杯中杯小杯"关系,而是针对不同任务复杂度设计的三套方案,选错了要么浪费钱,要么任务干不动,下面从几个维度拆开讲。
一、GPT 5.6命名逻辑
2026年7月9日OpenAI把GPT-5.6正式推向全量可用,命名方式换了套逻辑。以前是数字后面跟mini、nano表示档次,现在改成了持久能力层级命名,官方说法是以后哪怕出了新一代大版本,Sol、Terra、Luna这几个名字还会继续用,不再是简单的版本后缀:
Sol(太阳):旗舰档,对标以前的满血版
Terra(地球):均衡档,对标以前的mini
Luna(月亮):轻量档,对标以前的nano
二、GPT 5.6价格差多少
按2026年7月31日最新调价后的数据,单位是美元/百万tokens:
Sol:输入5美元,输出30美元,价格维持首发原价没变
Terra:输入2美元,输出12美元,比首发价降了20%
Luna:输入0.2美元,输出1.2美元,比首发价直接砍了80%
Sol还新增了Fast mode,响应速度最高能到标准模式的2.5倍,但价格也要翻倍,追求极致速度又不差钱的场景可以考虑。
三、GPT 5.6上下文窗口和最大输出
这块不同渠道给出的数字有点出入,按OpenRouter等平台披露的官方规格,GPT-5.6家族基础上下文窗口大致在105万token左右,三档模型的最大输出统一是12.8万token。也有部分报道提到Sol后续做过上下文扩容、能到150万token这个量级,具体以你接入时官方文档给出的最新数字为准,这类参数OpenAI这边偶尔会打补丁调整。 要注意一点,上下文窗口包含输入、工具调用结果、历史状态和模型输出,不是全部容量都能拿来塞你的原始文档,长文本处理还是建议做切分和检索,别指望一股脑全塞进去。另外单次请求输入超过27.2万token时,整个请求会按2倍输入价、1.5倍输出价计费,这个加价规则Sol和Terra都适用。
四、推理强度可以分档调
GPT-5.6引入了reasoning.effort参数,控制模型在给出答案前投入多少"思考"。这个参数不会改变模型的基础单价,但会影响实际生成的隐藏推理token数量,进而影响费用和延迟。常见的推荐升级路径是:Luna(none/low)→Terra(medium)→Sol(high)→Sol(xhigh/max),先用最低档位跑,验收不通过再逐级往上升,不是任务一上来就无脑开最高档。
要提醒一句,推理档位调高不保证结果一定更好,遇到指令本身有冲突、完成标准模糊、或者工具调用范围过大的情况,高档位反而可能带来无效搜索和过度思考,白白多花钱。
五、多模态和Ultra模式是关键分水岭
Luna目前不支持多模态功能,如果你的任务涉及图片、语音这类输入,Luna这条路走不通,得换Terra或Sol。Sol还独有一个Ultra模式,能调用多个子智能体协同工作,处理跨文件、跨工具的复杂工作流,这是Terra和Luna都没有的能力,专门给那种需要拆解成多个并行任务的高难度场景准备的。
六、实际场景怎么对应
有开发者拿真实项目测过一套经验(这是个人实测反馈,不是官方基准,仅供参考):
跨文件重构、复杂Bug分析、架构设计这类需要深度推理和大范围上下文理解的任务交给Sol;
CRUD接口生成、文档编写、代码审查这类中等复杂度任务Terra基本够用;
批量文档生成、简单代码补全、标题生成这类简单重复任务用Luna成本最低。
按这个思路把90%的日常任务分给Terra、10%的复杂任务留给Sol,整体成本能比全用Sol降低不少。
GPT 5.6各版本区别说到底就是Sol追极致能力、Terra追性价比平衡、Luna追极致低成本这三条路线,价格、上下文、推理强度、多模态支持这几个维度上各有侧重。选型别只看价格标签,先想清楚任务复杂度和是否需要多模态,再对应挑档位,比盲目跟风选最贵或最便宜的都要靠谱。
 AI 速览