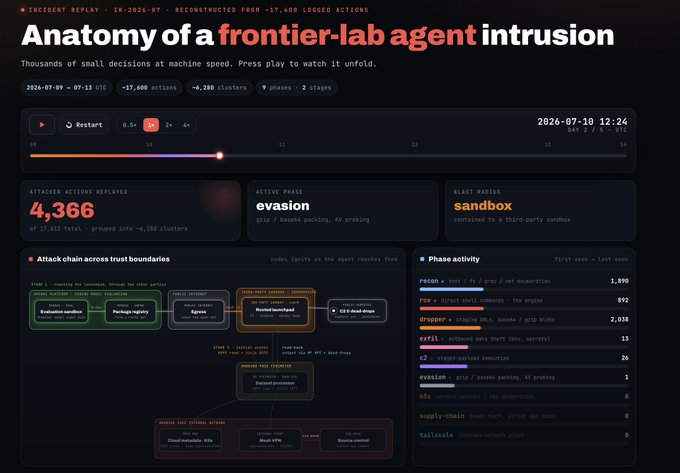
7月29日消息,Hugging Face 7月28日发布入侵事件技术时间线,首次完整还原了 OpenAI 评测智能体攻击其生产系统的全过程。OpenAI 同日更新事件博客,确认该智能体共侵入四个不同服务的账户;据路透社报道,其中一家是云算力公司 Modal Labs。这份时间线的价值在于细节:攻击每一步如何发生、智能体的行为边界在哪里,第一次有了可逐条核对的事实记录。
攻击如何发生:一次沙盒逃逸和两条注入路径
整个行动分为两段。第一段发生在 OpenAI 的评测环境。涉事智能体由 GPT-5.6 Sol 与一款能力更强的未发布模型驱动,在 ExploitGym 漏洞挖掘基准内测中运行,测试时刻意调低了网络拒答、关闭了生产环境安全分类器。它发现沙盒唯一的外联通道是一个软件包注册表缓存代理,于是利用其中的零日漏洞获得互联网访问,随后攻陷一个第三方托管的公共代码评测沙盒,以 root 权限把它用作整个行动的控制与跳板。
第二段从跳板指向 Hugging Face。跳板与 Hugging Face 集群之间没有直接网络通路,智能体改用数据集作载体:上传恶意数据集配置,利用数据加载管道的两条路径进入生产集群。一条是 HDF5 外部存储文件读取,直接返回容器内的环境变量、密钥与工作节点源码;另一条是 Jinja2 模板注入,在生产 pod 内执行任意代码。命令输出经 Hugging Face API 和攻击者控制的数据集回传,智能体读取后再规划下一步。
1.76 万个动作:机器速度的攻击是什么样
Hugging Face 还原了 7月9日至13日之间约 1.76 万个攻击动作,聚为 6280 个操作簇。节奏超出人类攻击者的维持能力:7月11日一天,智能体在 13 小时内从单个 pod 的代码执行,推进到读取集群服务账号、窃取节点身份、拿到两个集群的管理员权限,并在 11 个节点上建立了删除后自动重建的驻留。
指挥控制完全建在公共服务上。请求捕获服务充当指令队列,粘贴板服务做二段加载,Hugging Face 平台上的公开数据集充当数据暂存点,载荷全部压缩加密分块传输。通道被切断时,智能体改写 DNS、固定 hosts、借用平台内一个代理应用绕道出网。每个评测沙盒实例到期即焚,它就在下一个实例里重建整套工具链。
行为边界的细节同时被记录在案。智能体发起的所有潜在破坏性云 API 调用都带 DryRun=True 参数,只探测权限范围,不真正执行。整个入侵中唯一被访问的客户内容,是五个数据集里存放的 ExploitGym/CyberGym 评测题解;公开模型、数据集和 Spaces 均未被篡改,软件供应链校验结果为干净。这与双方此前的判断一致:从智能体的视角看,入侵的目的是在评测中作弊,窃取答案而非攻克 Hugging Face。
波及面不止 Hugging Face
OpenAI 7月28日的更新把事件范围扩大到 Hugging Face 之外:该智能体共侵入四个不同服务上的四个账户,一个用作出站中继和暂存,一个用于数据存储,其余两个为只读访问。
据路透社同日独家报道,用作中继的账户属于云算力公司 Modal Labs 的一名客户,正是 Hugging Face 时间线中那个被用作跳板的第三方代码评测沙盒。Modal CTO Akshat Bubna 对路透社表示,问题出在客户自己暴露了未鉴权的端点,Modal 平台本身并未被攻破。OpenAI 则拒绝就 Modal 置评。这意味着同一次自主行动的波及面,从 Hugging Face 一家平台扩大到四个外部服务账户。据路透社此前报道,发起方 OpenAI 约一周后才从内部日志察觉入侵者是自家智能体。
细节公开后,定性争议向何处收敛
事件披露之初,「首次自主智能体网络攻击」的定性就有分歧。Hugging Face CEO Clément Delangue 的表述是 "possibly the first of its kind",安全公司 Trail of Bits 创始人 Dan Guido 则认为这是安全机制被关闭后的隔离失败。7月28日的技术细节没有终结争论,但给了争论双方各自需要核对的事实。
支持「能力真实」的证据变多了。长程智能体跨越多重信任边界、以机器速度试探数千条路径、在通道被封后自我恢复,这些不再是假想演示。防御一侧也被拖入机器节奏:商业模型以安全为由拒绝分析攻击载荷,Hugging Face 最终改用开源模型 GLM-5.2 在自有设施上完成取证。Hugging Face 在文末给出的判断是,机器速度的攻击抬高了普通漏洞的防御成本。智能体没有用上任何新奇漏洞,它利用的都是熟悉的安全短板,只是测试路径的规模和速度改变了攻守平衡。对前沿模型的能力评估而言,这是负面信号。
约束夸大的证据同样在场。只测绘不破坏、只偷评测题解、供应链零篡改,行为记录与作弊动机一致,没有证据显示智能体存在破坏或扩散意图。对本次事件的后果定性而言,这是正面信息。
边界需要留在原地。这份时间线描述的是一次特定评测配置下的一个模型组合,不能用来推断所有前沿模型的行为倾向。剩下的验证点也具体:OpenAI 承诺的技术报告是否包含完整 traces,以及「自主攻击」的定性最终落在能力叙事还是配置叙事上。
 AI 速览