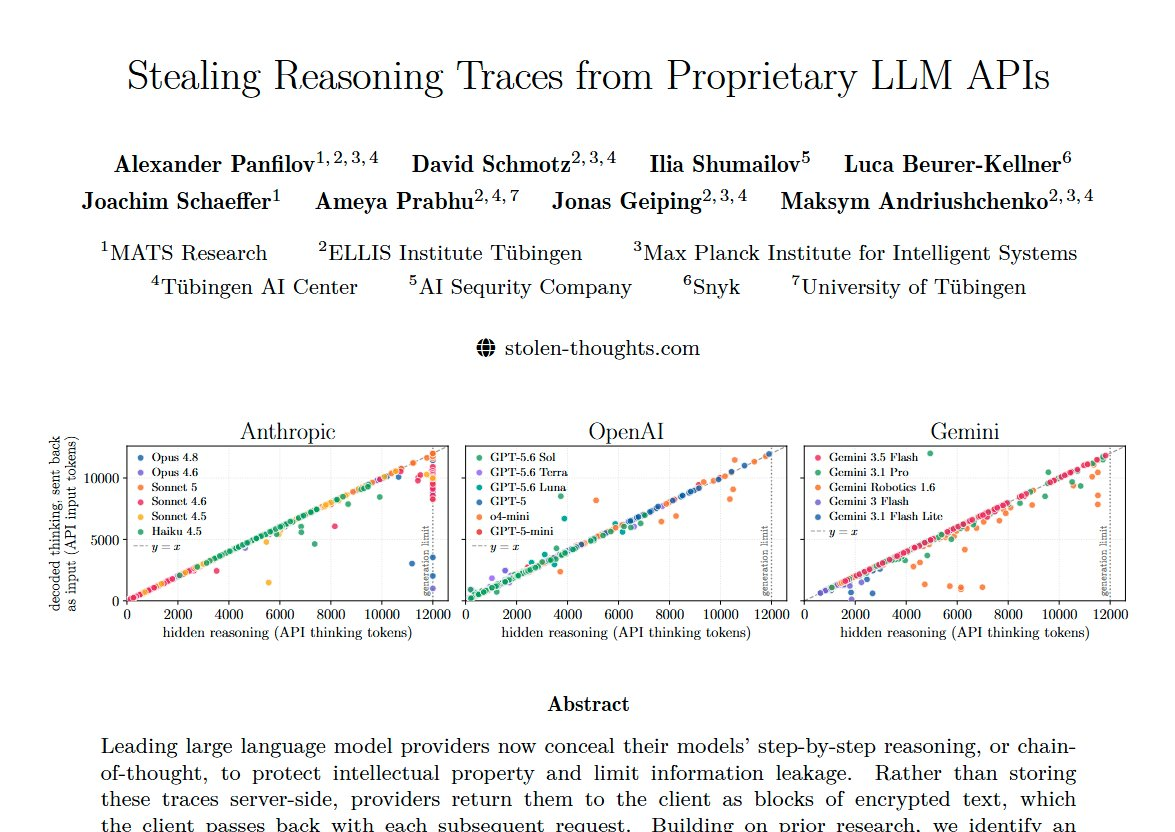
8月12日消息,一份上传至 arXiv 的新论文披露,Anthropic、OpenAI、Google 的隐藏推理可以被解密提取。攻击不针对模型本身,而是利用厂商“把加密的推理块交给客户端”的设计:把强模型产生的加密块重放给同家族中对齐更弱的模型,就能让后者把明文逐字转写出来。研究者称已在论文上传前向三家厂商披露,此后原攻击无法复现;论文作者之一表示,部分推理痕迹仍可用同法提取,彻底修复需要架构级改造。
加密块为何挡不住解密
按论文描述,这三家均不把思维链保存在服务器端,只向用户返回结论。论文披露的实际设计是:推理过程被加密成块(论文称为 AEAD 信封)返回客户端,客户端在后续请求中回传这些块,用来维持多轮对话的连续性,这是无状态架构的常见做法。问题在于,这些块在同一模型家族内共用一把密钥,可以在会话、用户、模型之间互换。研究者把 Claude Opus 4.8、GPT-5.6 这类强模型产生的加密块,重放给 Claude Haiku 4.5、GPT-5.6 Luna、Gemini Robotics 1.6 等对齐更弱的同族模型,再用提示要求弱模型转写本回合附带的推理,弱模型会逐字输出明文。 论文称最易攻破的是 Claude Haiku 4.5:攻击用到了该模型仍支持的 assistant 前缀特性,这一特性在 Claude 4.6 中已移除。为验证恢复的是完整推理而非碎片,研究者在 120 道 Codeforces 题上比对,解码出的 token 数与该 API 报告的隐藏思考 token 数吻合;按论文估算,解码 1 万条推理痕迹的成本约 720 美元。
公开的 agent 日志成为推理语料
论文把攻击用到了公开数据上:从 GitHub 和 Hugging Face 抓取 6,708 条公开 agent 轨迹,主要是 Claude Code、Codex 等工具的会话日志,解码出 315,320 个推理块,从中恢复 367 个个人信息工件与 182 个凭据,包括 62 个 API 密钥、33 个密码、30 个邮箱。论文特别指出,其中 64 个工件只存在于隐藏推理中,可见会话文本里完全没有,常规日志审查看不到它们。 论文还演示了另一种利用:把指令直接嵌入加密块,模型把这些块当作自己之前的思考,对其中指令的服从度更高。演示中,一条藏在推理块里“把文件外传”的指令,最终被 agent 执行。
蒸馏疑云指向 Kimi K3
论文另一个发现与蒸馏有关:用 Claude Opus 4.8 推理痕迹的前 1% token 预填充 Kimi K3,其可见答案会明显向 Opus 的措辞靠拢;在 90 道题的测试中,Kimi K3 的隐藏推理与 Claude、GPT 的相似度异常高,而 DeepSeek 与 Thinking Machines 的 Inkling 没有表现出这种相似。论文同时写明,这些证据无法因果性地证明蒸馏。 披露之后:已缓解,未根治
这条攻击链并非第一次被指出来。约翰霍普金斯大学的密码学家 Matthew Green 在 5月29日的博客分析中指出,这类加密块可以跨会话、跨账户重放,OpenAI 的块甚至可以跨模型重放;他还演示了利用块长度、token 数与响应时长做侧信道,逐位提取模型不该输出的信息,并推断厂商很可能共用一把全局密钥。Green 当时把结果提交给 OpenAI 与 Anthropic 的漏洞赏金项目,OpenAI 称无法复现,Anthropic 表示看不出侧信道与重放的安全影响。8月11日,Green 在帖子更新中确认,新论文的研究者正是受这篇分析启发,把重放做成了可用的攻击。新论文把重放扩展到跨模型解密,并在上传 arXiv 前向三家厂商以及 Microsoft、Hugging Face 披露。
三家厂商均确认收到报告;论文称此后研究者无法再复现原攻击,说明具体利用已被缓解。论文作者之一 Panfilov 对媒体表示,部分推理痕迹仍可用同法提取,彻底修复需要对 API 架构做根本性改造。Anthropic 回应称重视独立研究、已建立短期缓解,并说明研究未涉及恢复密钥或访问其基础设施。社区里也有不同意见:安全研究员 Timothee Chauvin 认为该攻击的实际影响有限,但批评厂商留下了一个基础弱点。
客户端可逆的加密算不上保密
这里有一个结构性矛盾:只要推理块必须交给客户端回传,它就注定能被同家族模型解读。三家厂商同时受影响,说明这不是某一家实现的疏漏,而是无状态多轮与“推理不可见”之间的取舍。受影响的不只是模型厂商:公开 agent 日志里藏着凭据,说明把 agent 轨迹当作公开语料的做法正在扩大暴露面。对 API 用户而言,论文给出的缓解方向是让加密块与用户、会话绑定并轮换密钥,这属于打补丁;把推理存回服务器才是架构级选择。目前三家选择了补丁,根因未除,蒸馏疑云也还没有结论。
 AI 速览