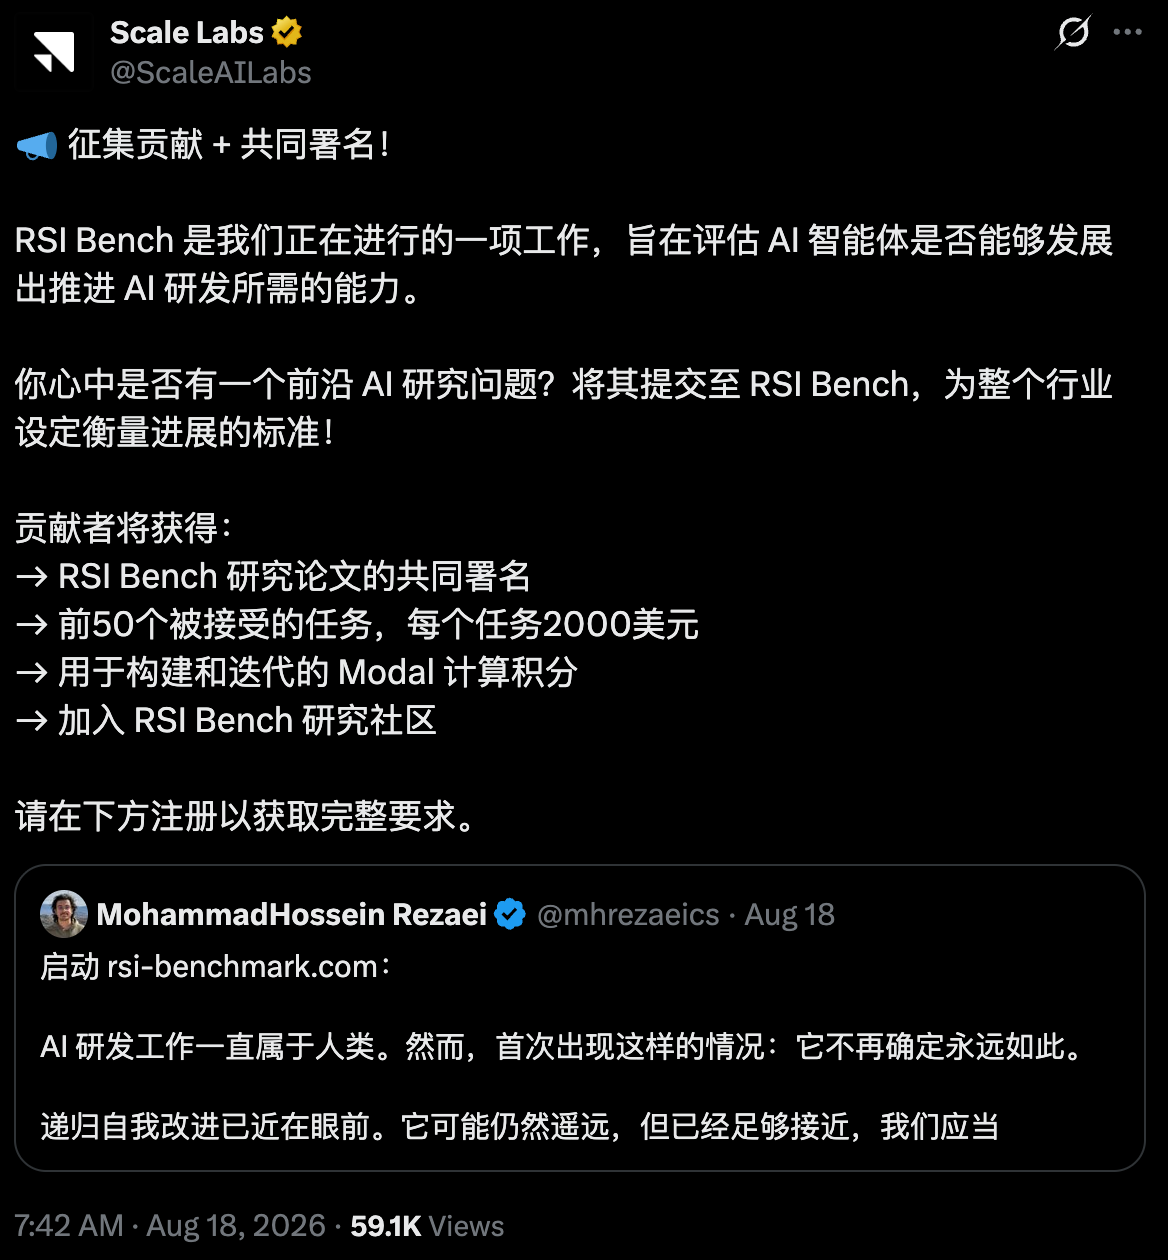
8月19日消息,数据与评估基础设施厂商 Scale AI 近日上线 RSI Bench(rsi-benchmark.com)预览版,这是一个专门度量递归自我提升(Recursive Self-Improvement,RSI)能力的基准测试。它要回答的问题是:AI agent 能否在无人干预的情况下,自主完成前沿 AI 研发的各个环节,进而构建出下一代模型。
目前该站点仍处于预览状态。任务设计准则已经公开,但完整的任务分类体系和贡献指南仍标注为待定,站点上也没有汇总榜单。它现在更接近一个公开建设中的框架,而不是一份已经定型的评测排名。
把"AI 做 AI 研发"拆成可验证的任务
RSI Bench 的核心设计,是把"AI 能否做研究"这个抽象问题拆成一批可以被客观打分的研发任务。根据官方公告,任务由前沿 AI 研发领域的专家策划,面向开放式、长时程的工作流,要求 agent 独立开展实验、迭代改进并完成多步骤的研究过程。
每个任务提供三样东西:一个起始环境、一份明确的算力预算,以及一套对照已测量基线的 verifier(验证器)。任务好不好,由验证器对着基线打分,而不是由人来主观评判。官方为好任务定了五条标准:反映真实的研发环节(数据、算子、训练、评测、对齐)、有客观验证器、算力预算固定且无法暴力破解、能区分强弱 agent、公开部分不泄露隐藏测试集。
任务按一级类目组织,已列出的方向包括 Infra & Systems、Post-training、Multimodal、Alignment、Applied、Data、Pre-training 和 Evals,基本覆盖了前沿模型研发的完整流程。除最终结果外,RSI Bench 还声明会评估 agent 的四类过程表现:是否产生真实改进而非噪声、在有限资源下的解题效率、方案能否超出针对单一任务的修补,以及能否提炼洞察并提出新方法。
站点所有页面还嵌入了一条声明和 canary GUID,要求基准数据不得进入训练语料。这一设计针对的正是基准被训练数据污染后失去区分度的老问题。
四类示例任务,以及第一批运行记录
目前站点公开了四类示例任务:on-policy self-distillation(在策略自蒸馏)、jailbreak robustness(越狱鲁棒性)、agent swarm optimization(智能体集群优化)和 nanoGPT data curation(nanoGPT 数据筛选)。
运行记录页显示,已有模型在任务上留下了公开结果。在 nanoGPT 数据筛选任务中,一个 agent 经 Codex 框架调用 azure_ai 后端的 GPT-5.6 Sol,在 42 分钟内执行了 160 步操作。其 held-out 多领域困惑度(perplexity)得分为 362.62,优于 426.38 的基线。该指标数值越低越好。这条记录录制于 8月3日,早于公告发布日。
单次运行不能说明整体格局。它能证明的是流程已经跑通:agent 在固定预算内完成了一个真实的研发环节,并且结果被验证器客观地记录了下来。但不同模型之间的系统性差距有多大,目前没有任何汇总数据可以回答。
RSI 从讨论对象变成度量对象
递归自我提升长期停留在哲学讨论和安全叙事里,被视为"智能爆炸"的前置条件。这个概念正在变成具体的工程投入:Sakana AI 于 7月正式成立专做递归自我提升的 RSI Lab;OpenAI 内部也在维护追踪研发自动化能力的 RSI Index。Scale AI 的入场补上了另一侧:一家以评估和数据为主业的公司,开始把 RSI 当作可以公开建设、公开征集任务的评测对象。
这件事目前能确定的边界很清晰。RSI Bench 给出了一套操作性定义:会不会做研究,先看能不能在固定预算内把数据筛选、鲁棒性、集群优化这类真实环节做出可验证的改进。前沿实验室关于"模型正在自动化 AI 研发"的叙事,由此开始面对一个公开的外部度量框架。而任务征集机制意味着,这套基准的覆盖面会随社区贡献持续变化,它测什么在很大程度上将由参与者共同决定。
它能否成为行业公认的标尺,目前下结论为时尚早。站点仍是预览版,任务全集和完整分类体系尚未公布,目前也没有第三方复测结果。官方已经公布的下一步只有一件:向社区征集各领域专家贡献任务。
 AI 速览