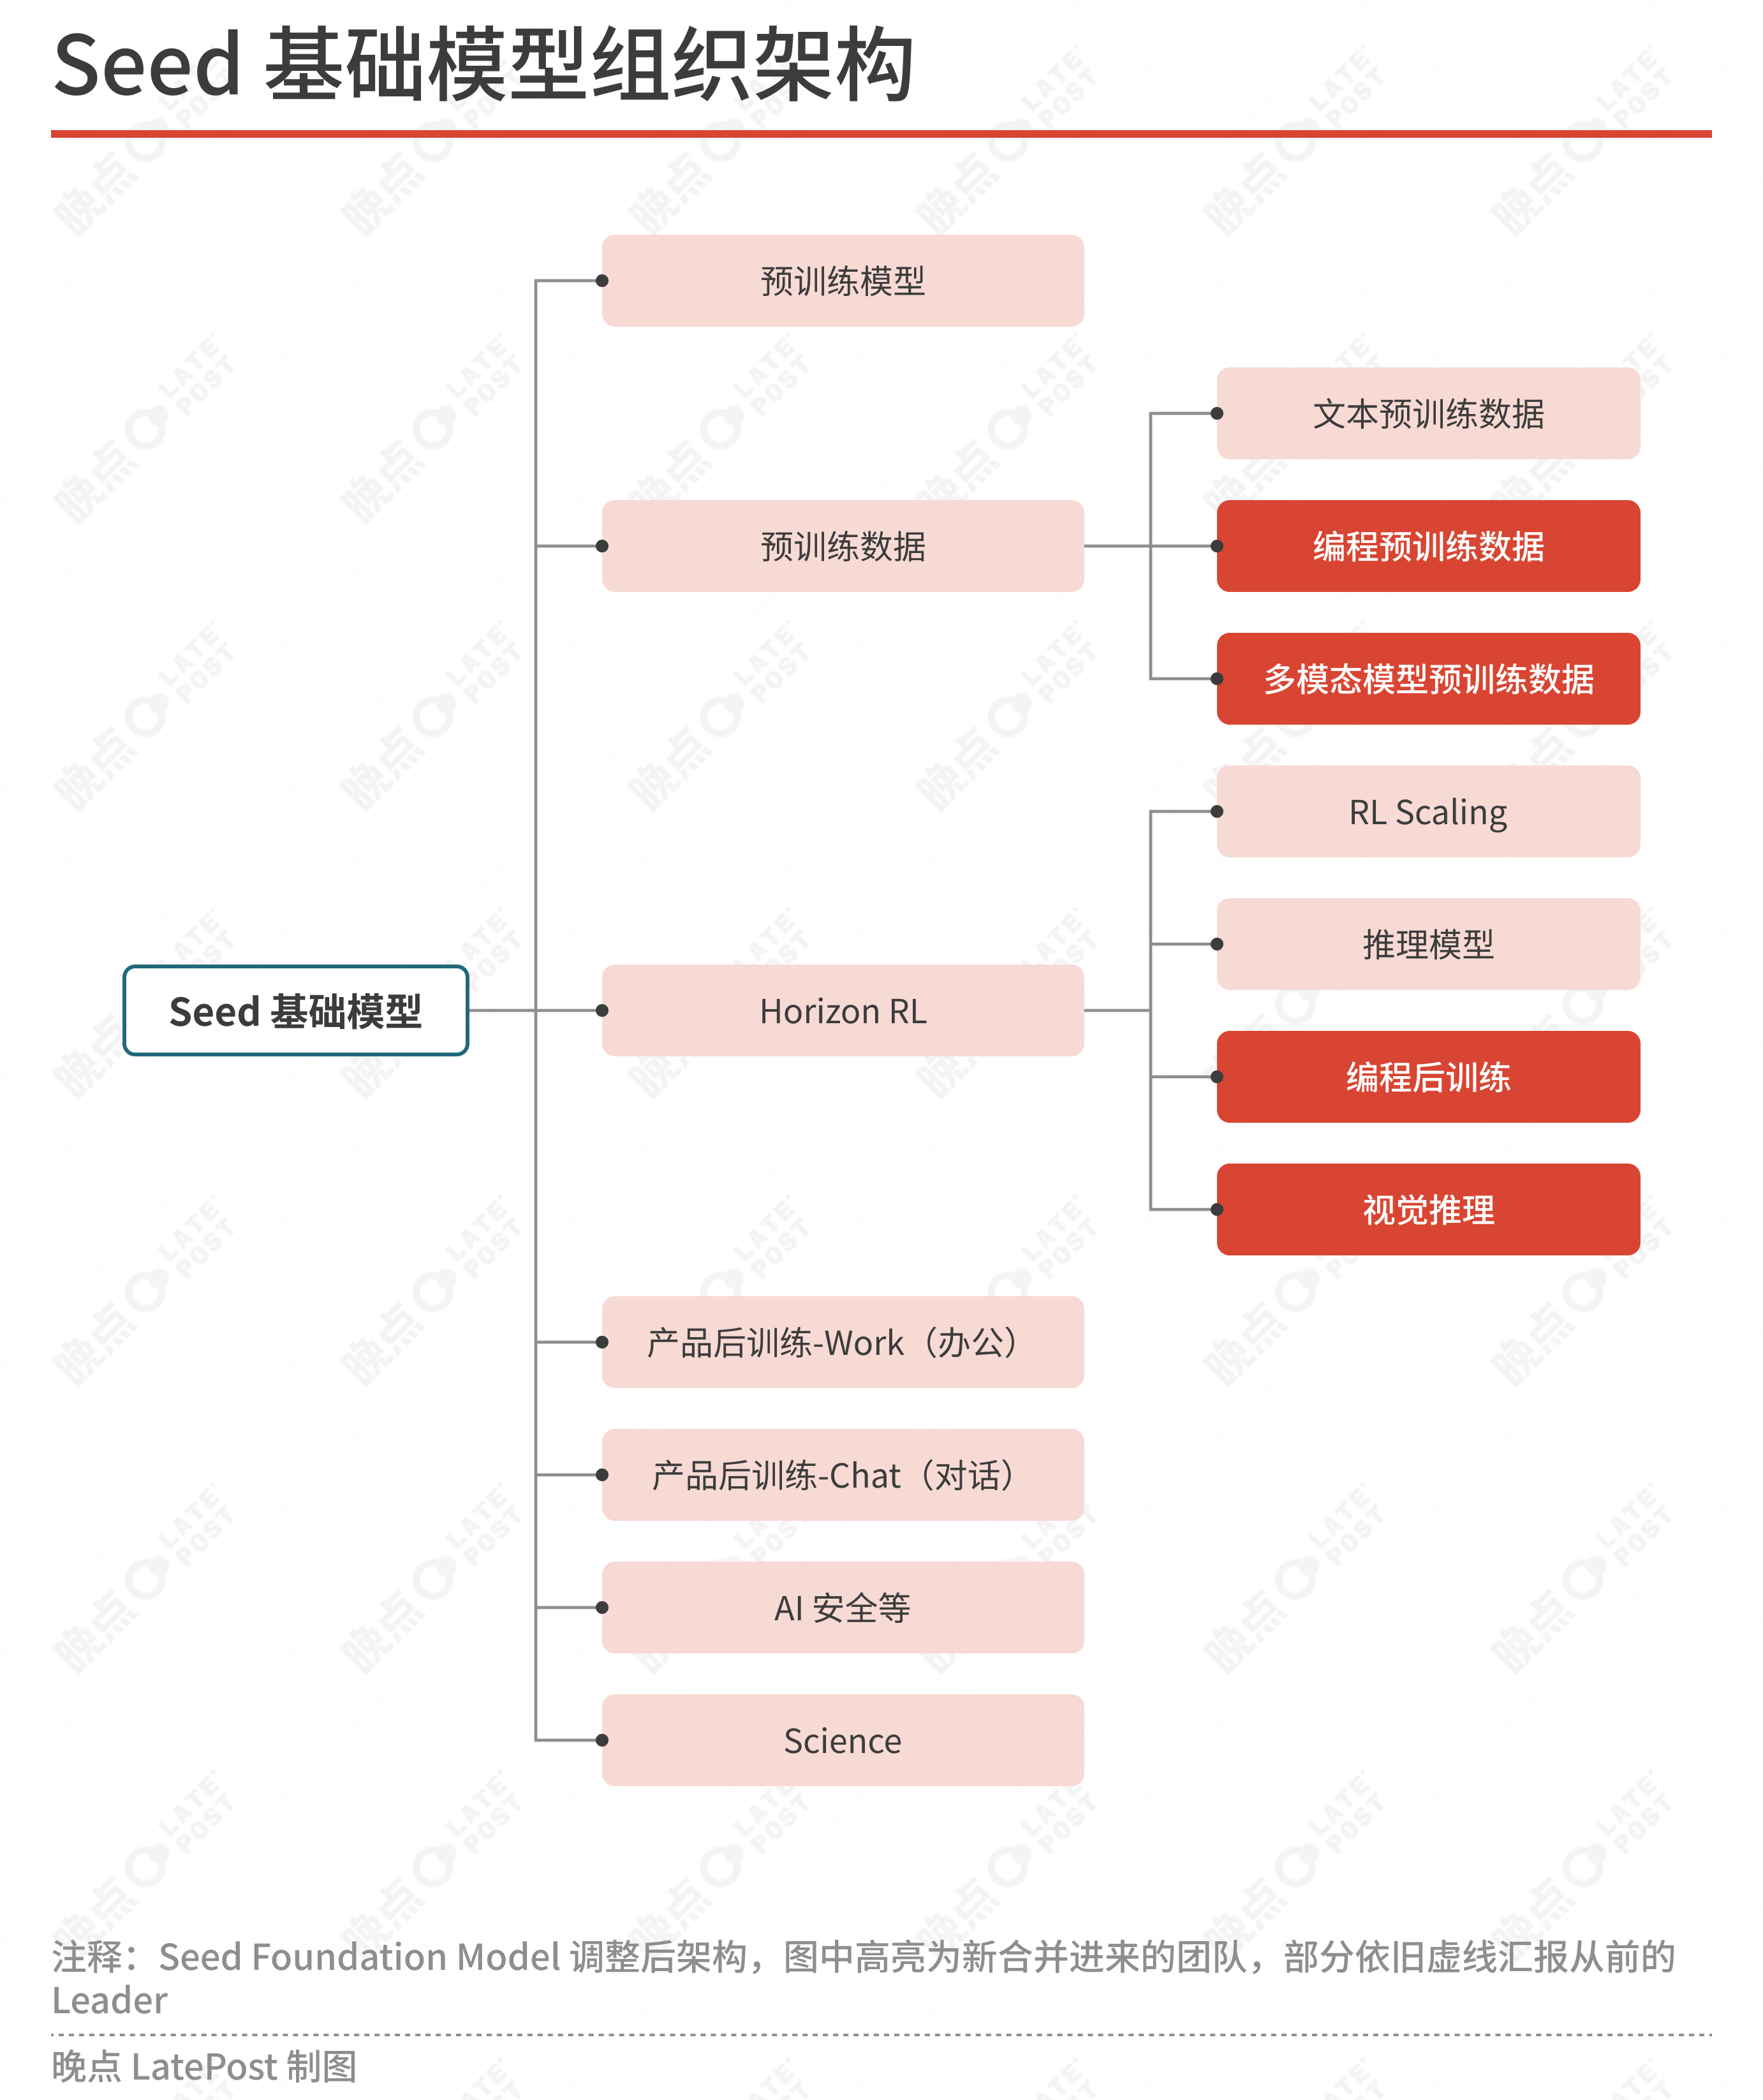
8月20日消息,据晚点独家报道,字节跳动大模型部门 Seed 已于上周完成新一轮组织调整:Seed Foundation Model 成立四个新一级部门,负责人均向吴永辉汇报。Seed 在调整公告中称,此举是“合并相似工作、减少 overlap(重合),内聚在一起”;调整的目的,是为参数规模超过 5 万亿的模型和全模态 Omni 模型铺路。
四个新部门:数据、强化学习与两条产品线
新设部门按职责划分。Pretrain Data 由李成刚负责,统一负责 Omni 模型的多模态数据与超大模型预训练所需的数据工作。这一部门由原先分散在文本模型、编程、视觉理解和语音等方向的预训练数据团队合并而来。Horizon RL 由唐晟宇负责,整合了此前散落在后训练、推理和视觉理解的后训练团队,主攻强化学习,目标是提升模型的基础智能上限。
Product Posttrain-Work 由秦禹嘉负责,服务 B 端应用,负责 Agentic 模型的整合与发布,针对办公场景优化模型的 Agentic 能力,包括支持豆包和 Dola 的任务模式。Product Posttrain-Chat 由原 Application 团队更名而来,该团队原由朱文佳负责,继续服务 C 端应用,负责对话模型的整合与发布,与 Product Posttrain-Work 分工协作。此外,Seed 还为 AI 安全及其他前沿探索方向分别任命了负责人。 从按模态划分,到按任务划分
过去,Seed 主要按照模态和研究方向划分团队,文本、代码、视觉、推理等方向各有自己的数据与后训练团队。这种组织方式在大模型研发早期便于快速补齐能力,但随着研究方向增多,团队边界越来越模糊,部分方向出现重复投入,跨团队沟通与协作成本随之上升。
此次调整中一个明显的变化,是将应用后训练团队按用户任务拆分为 Work 和 Chat 两个方向。Chat 继续服务成熟的 C 端需求,重点优化搜索问答、对话体验、个性化和安全等能力,同时控制推理成本。Work 对应办公市场,要把模型在编程场景中积累的工具调用、GUI 操作和长任务执行能力,迁移到更广泛的职场任务中。
为超大模型与 Omni 铺路
8 月初,字节跳动内部讨论了训练参数规模超过 5 万亿的模型,同时希望下一代模型直接走向能处理更长、更复杂任务的全模态 Omni。更大尺寸的模型需要更多、更丰富且质量更高的数据;语言、代码、视觉和语音进入同一个基座,各类数据放多少、在什么阶段加入、如何保持模态之间的平衡,都会影响模型最终能力,需要数据团队之间更深的合作。这给了字节更强的动力和决心,去打破原有的团队边界与分工模式。
一位从业者称,Omni 是行业的趋势,类似的调整也出现在其他公司。今年 7 月,腾讯混元将多模态模型部门与大语言模型部门合并,由大语言模型负责人姚顺雨统一管理。 集中资源:从多线并行到收敛投入
字节过去两年招聘了大量顶尖人才,分散在 Seed 的各模型研发团队内,多个项目并行探索。但大参数模型对算力需求更高,多线并行的研发模式让算力储备难以支撑,集中资源推进少数核心项目成为更现实的选择。2025 年吴永辉接管 Seed 后,已组建 Edge、Focus 和 Base 三个虚拟组织,推动不同团队共享数据和代码库;此次调整把整合推进到正式部门层面。
Seed 眼下仍处于追赶状态。晚点报道称,其 Coding、Agent 能力落后于月之暗面、智谱等创业公司,在大厂 AI 产品重心转向办公应用时,字节的反应也不是最快的。字节创始人张一鸣曾在 Seed 内部会上称,可以接受模型在一段时间内的落后,希望团队把追求智能上限作为更重要的目标。
组织调整能说明投入方向:字节选择集中资源、先理顺内部,再回到基础模型竞争。调整最终能产生什么效果,取决于人员和组织的磨合,目前还看不到更多信息。
 AI 速览