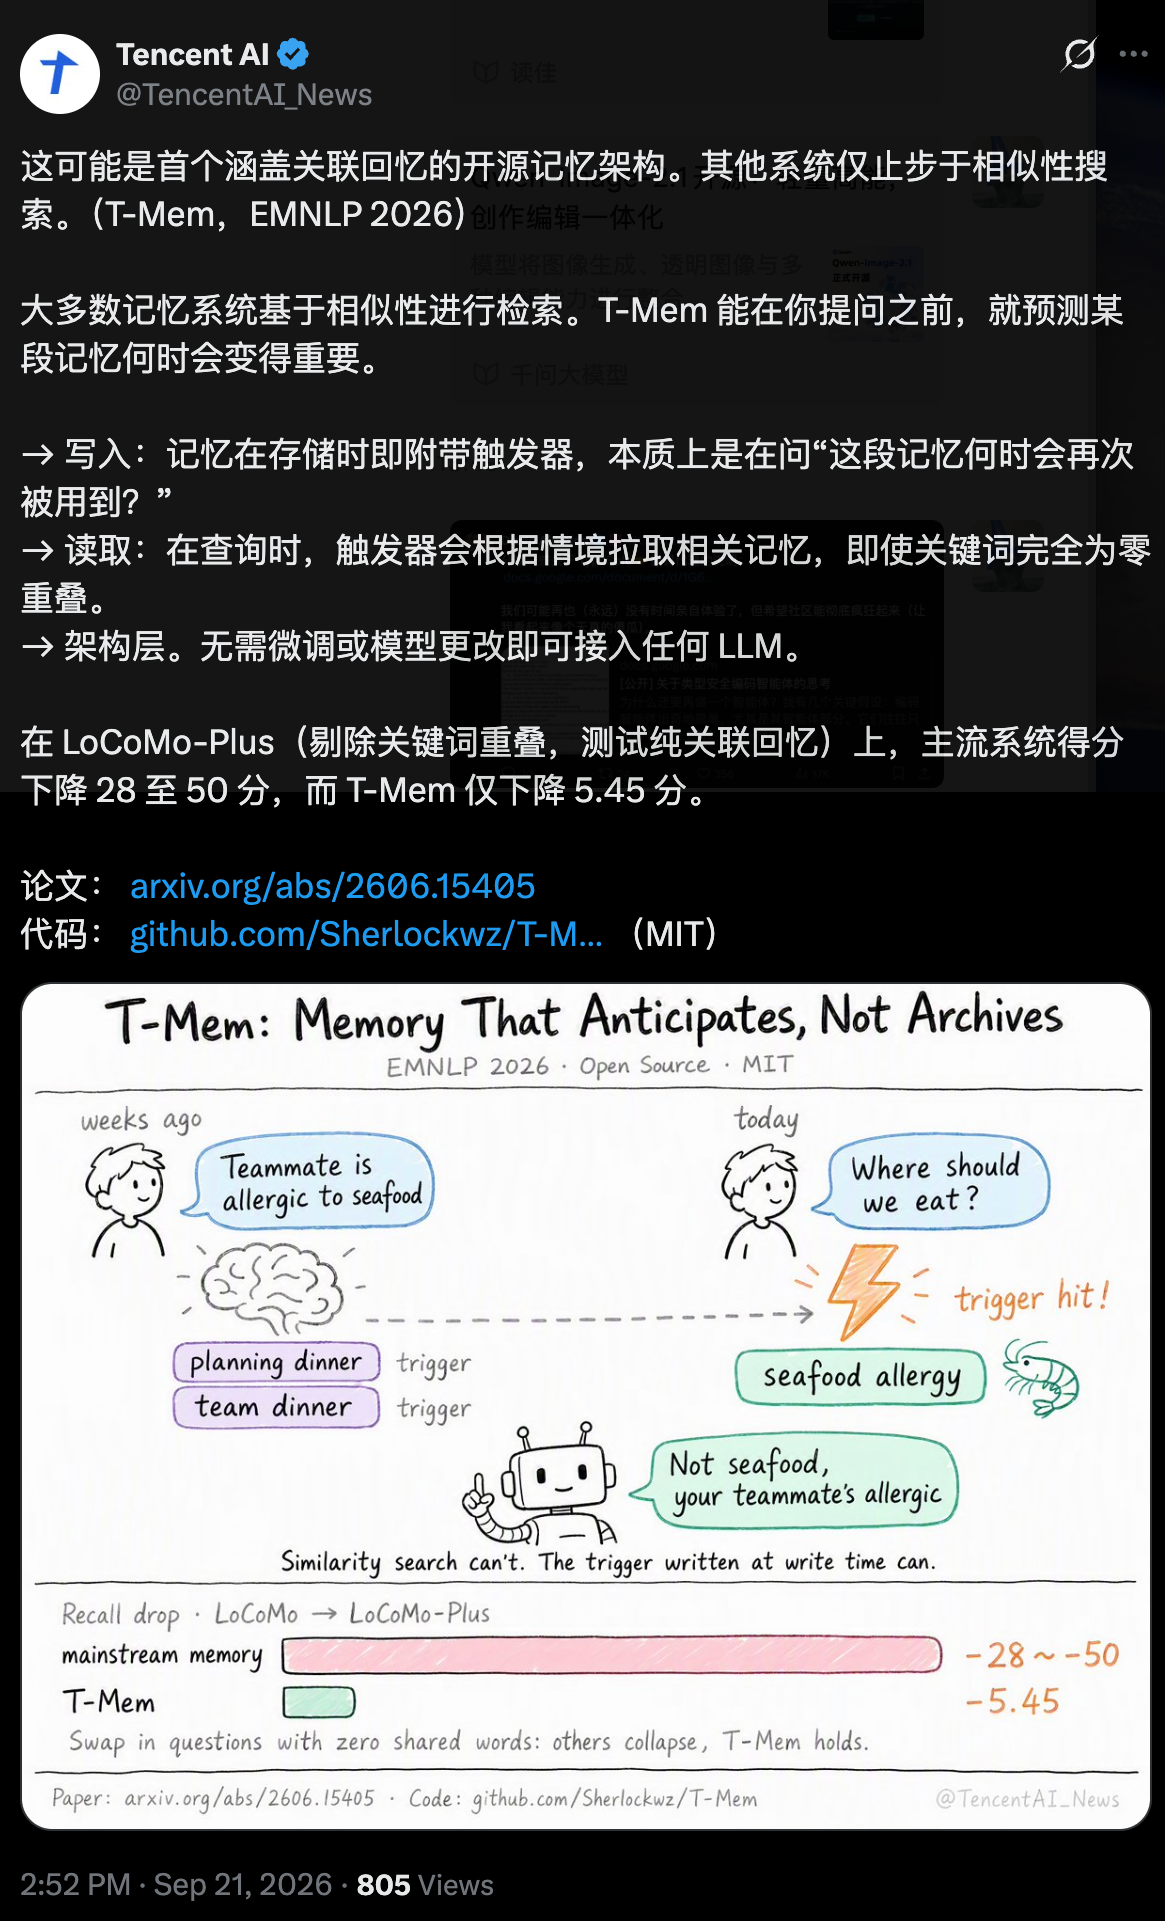
- 记忆检索的默认方案是相似度匹配(BM25 与稠密向量),问句与记忆共享词面或实体时管用,只靠语义关联时整体失效。
- T-Mem 把「这段记忆何时会被再想起」前移到写入时计算,为每段记忆生成触发器,对应认知科学里的情节性未来思考。
- 在剔除关键词重叠的 LoCoMo-Plus 上,T-Mem 只掉 5.45 分,六个对比系统掉 28 至 50 分。
- 不改模型、不微调,模型与检索参数都在配置文件里切换;已用 GPT-4.1、GPT-5.1、Qwen3-32B 跑过构建。
- 基线数值引自 LoCoMo-Plus 原论文而非本文重跑,「首个」是作者自述口径——这两个限定读的时候要带上。
T-Mem 是一个长期对话记忆架构,论文《T-Mem: Memory That Anticipates, Not Archives》被 EMNLP 2026 Main Conference 录用,代码以 MIT 协议在 GitHub 开源。它的切入点很具体:现有记忆检索受限于查询与存储内容的相似度,问句与记忆一旦没有词面重叠就取不出来。T-Mem 的做法是在写入记忆时生成「触发器」,预测这段记忆未来在什么情境下会被需要,读取时按情境拉取。论文自称首个同时覆盖描述性召回与关联回忆的长期对话记忆架构。
相似性检索漏掉了什么
词面与命名实体共享时,相似度检索是有效的:问「上次说的那家日料店在哪」,记忆里存着日料店名字,匹配就成立。论文把这类召回叫描述性(descriptive)。另一类是问句与记忆没有任何表面特征重叠,只靠一条潜在的语义弧连着——用户随口聊到要控制糖分,几周后问「还有什么可选」,靠的是「控糖诉求」与「菜品推荐」之间的语义关联,而不是任何共同词面。论文把这类叫关联性(associative),并指出主流长期记忆系统在这种情形下整体失效。
这句话有一个工程后果:记忆的可达性被相似度上了锁。能被找到的记忆,只是与当前问句长得像的那部分。LoCoMo-Plus 就是冲着这把锁做的。这个基准由 Li 等人在 2026 年提出(ACL 2026 long.1150),设计思路写得很直白:在「线索与触发语义脱节」(cue–trigger semantic disconnect)的条件下评测认知记忆,也就是出题时刻意切断关键词重叠,只留语义关联。
写入时生成触发器
T-Mem 的核心动作发生在写入时,而不是查询时。系统在存储每段记忆时会问:这段记忆未来在什么情境下会被需要?生成的答案就是触发器,论文称之为「写时排演」,并说这是认知科学里情节性未来思考(episodic future thinking)的工程对应物——在记忆落地的那一刻,就先演练它未来被找出来的情境。
结构上有两种证据粒度:单条事实(item)与完整对话段(scene)。每种粒度各配一组描述性触发器和一组关联性触发器,一共四个触发器家族,论文记为 Entity、Bridge、Scene、Horizon。这样每段记忆都能被两类问句找到:词面相似的,与只有语义关联的。检索走分层路线,从主题到对话段再到事实,触发器只在检索通道里起作用,不进入证据本身——论文把这一点列为设计承诺:怎么被找到,与找到的是什么,两者解耦。
5.45 分背后的三个限定
论文给了一张七系统对比图:把系统从标准基准 LoCoMo 换到 LoCoMo-Plus 的认知子集,准确率都会掉,T-Mem 只掉 5.45 个百分点,其余六个对比系统掉 28 至 50 个百分点。细节也列了:LoCoMo 上 HyperMem 最接近 T-Mem(77.01%),但它换到 LoCoMo-Plus 就掉 28.38 个百分点;A-Mem、SeCom、Mem0 和 GPT-4o 基线都掉超 45 个百分点。官方协议下 T-Mem 在 LoCoMo 上的准确率是 80.26%,token 级 F1 为 51.96。
这个数字读起来痛快,但有三个限定必须一起带上。第一,基线数值引自 Li 等人的 LoCoMo-Plus 原论文,不是 T-Mem 团队自己重跑的。第二,两个基准的评测模型不统一:LoCoMo 用 GPT-4o-mini 出题与评判,LoCoMo-Plus 用 GPT-4o 出题、Gemini-2.5-Flash 评判。第三,「首个覆盖关联回忆的长期对话记忆架构」是论文自述口径,没有独立横向核验。 论文另给了一组换协议的结果:在 HyperMem 使用的 GPT-4.1-mini 加七步思维链协议下,T-Mem 拿到 93.70% 准确率与 16.97 的 F1,HyperMem 自己报告的是 92.73% 与 15.78。两套协议不可互换,论文也把这两个结果分开列示,没有混着讲。
怎么接入,以及限制
接入是架构层面的,不改模型、不做微调:记忆与触发器都是在构建阶段调用现成模型生成,模型本身不做任何训练改动。所有模型 ID、检索的 top-K 取值与目录路径都在一个配置文件里,可以用环境变量覆盖;对接模型的模块走 OpenAI 兼容接口。camera-ready 版本里已经换过构建记忆用的模型:GPT-4.1 构建加 GPT-4.1 问答是 82.51%,GPT-5.1 构建加 GPT-4o-mini 问答是 81.36%,Qwen3-32B 这类开权重模型构建是 75.45%。使用上是两个脚本:一个切分对话、抽取记忆图、建索引、生成触发器,另一个跑检索、生成答案并打分。
限制要说清楚。基准规模不大:LoCoMo 是 10 段对话,LoCoMo-Plus 是 401 个样本库(每个样本对应一段长对话及其独立构建的记忆库,跑全量前可先用 25 个样本试跑)。基线是引用的,评测模型跨基准不统一。论文有效率分析,但生产环境下的延迟与成本还得自己测。这套机制目前只在对话问答这一场景里验证过,别的场景没有数据。
 AI 速览