- 生数科技(GensPI Technology)联合清华大学发布 23 页研究文章《General World Models from First-Principles》,从第一性原理定义通用世界模型(GWM)并给出五级路线图。
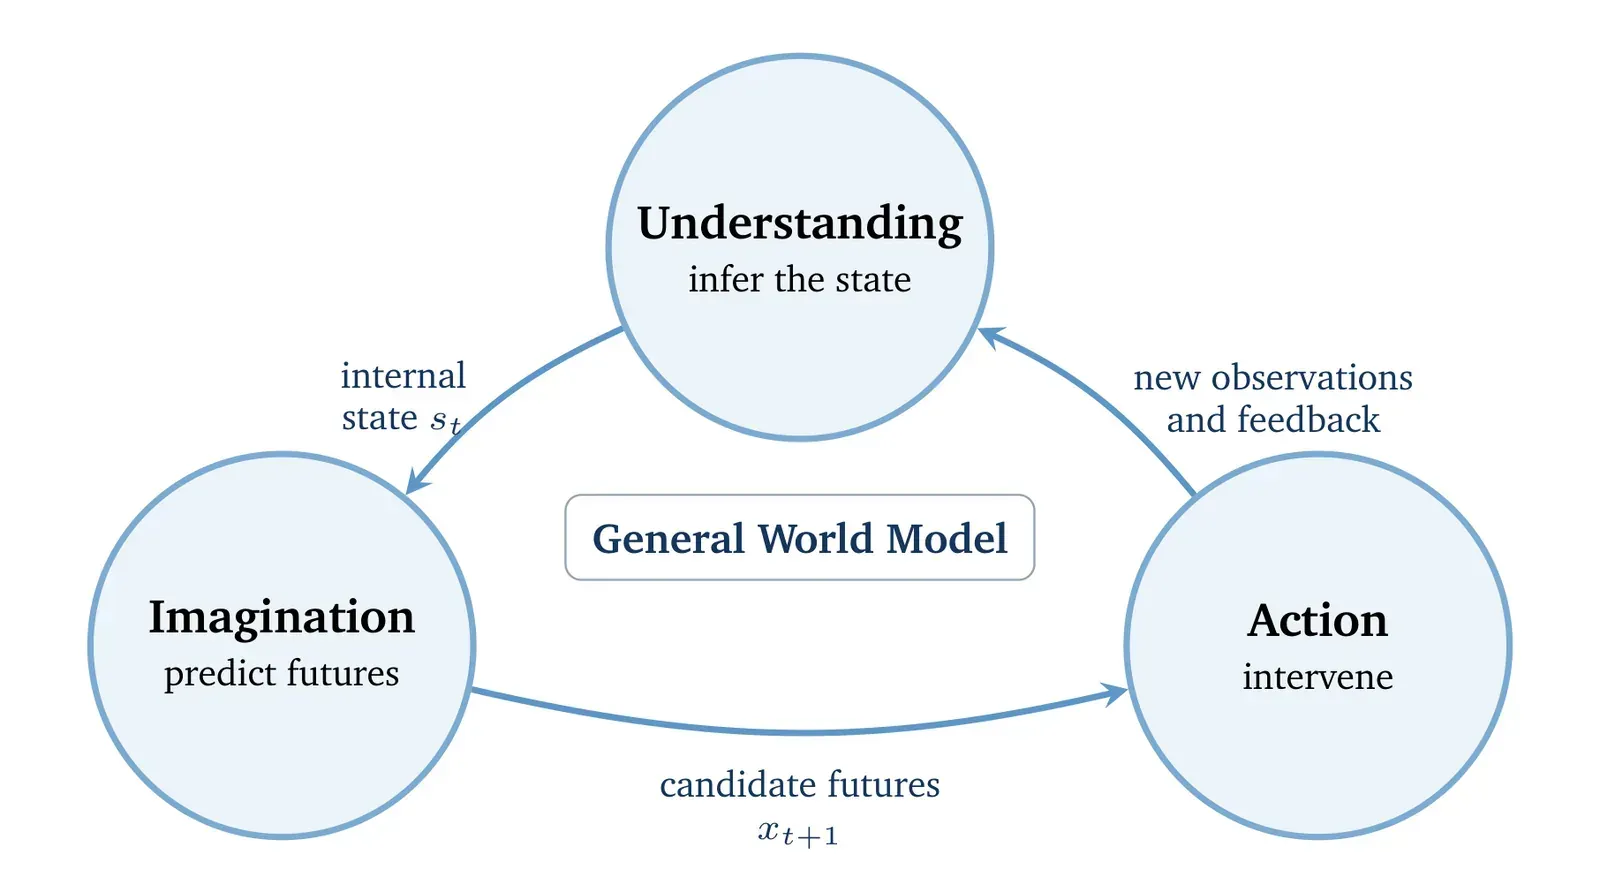
- GWM 的定义是"理解—想象—行动"闭环:理解当前世界、想象动作条件下的可能未来、采取行动并吸收反馈,三者缺一不可。
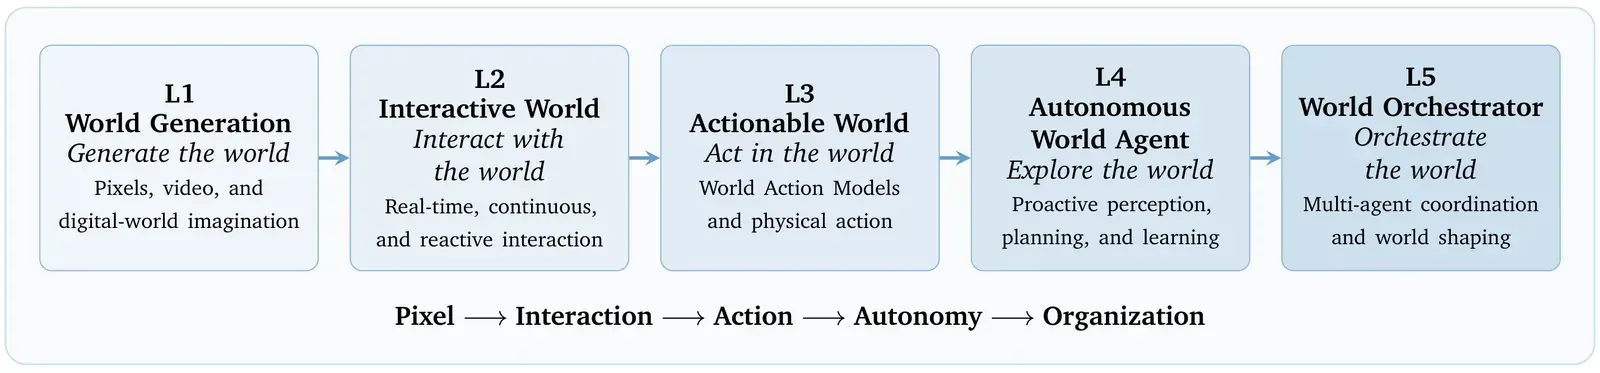
- 五级路线图按自主性递进:L1 世界生成、L2 交互世界、L3 可行动世界、L4 自主世界智能体、L5 世界组织者。
- 现有系统对应前三级:Vidu(L1)、Vidu S1(L2,语音实时介入生成,540p 最高 42fps)、Motus 与 Motubrain(L3,后者在 RoboTwin 2.0 上成功率 95.8%/96.1%)。
- 文章明确承认 L4、L5 尚无系统实现,L3 系统也仍在外部给定的目标和有限任务分布内运行。
一句话说清楚:给"世界模型"下定义,并把自己的产品放进去
"世界模型"这个词涵盖的系统差异极大。潜空间世界模型(如 Dreamer 系列)在受限环境内学习紧凑动力学;大型视频生成器能产出高保真画面,但不必暴露因果结构或可执行动作;交互式生成环境(如 Google DeepMind 的 Genie)响应控制输入,但控制可能是潜在、特定领域的;VLA(视觉-语言-动作)策略直接从观测映射到机器人指令,未来预测只是可选项。每种方法都只抓住了问题的一部分。
生数科技与清华大学合作的这篇文章要回答的问题是:一个基座模型要具备什么,才能通用、跨数字与物理世界地运行。文章共六位作者,署名机构为 GensPI Technology 和清华大学(作者详细介绍见下文专节)。
文章的答法分两步:先给出 GWM 的严格定义和五级路线图,再把自己的四个系统——视频生成模型 Vidu、实时交互模型 Vidu S1、具身模型 Motus 和 Motubrain——逐一映射到路线图的前三级。它因此既是一篇立场文章,也是一份公司技术路线的公开说明。
作者是谁:清华 TSAIL 组与生数科技的同一批人
第一作者朱军(Jun Zhu)是清华大学计算机系教授、清华大学人工智能研究院副院长,同时是生数科技创始人兼首席科学家,IEEE Fellow。他领导的清华 TSAIL 组是这条技术线的源头:2022 年提出把 Diffusion 与 Transformer 融合的 U-ViT 架构,之后的 DPM-Solver、Vidu、Motus 都出自同一体系。 鲍凡(Fan Bao)是生数科技联合创始人、CTO,TSAIL 组博士出身,2022 年 U-ViT 论文的第一作者,也是 Vidu 技术报告的第一作者。章晋涛(Jintao Zhang)是清华大学计算机系博士生(朱军、陈键飞指导),目前负责生数科技的流式视频生成与推理基础设施,SageAttention 系列和 TurboDiffusion 的第一作者——文章第三个要件"算力"里列举的推理加速技术,主体就是他主导的工作。Min Zhao 现任南京大学人工智能学院助理教授,此前在 TSAIL 组做博士后,是 Vidu 技术报告和多篇长视频、高分辨率生成工作的作者。
署名中还包括 Hengkai Tan 与 Bo Zhang,机构为清华大学。其中 Hengkai Tan 是 Motubrain 工作的作者之一。
(本节信息来自作者公开主页与公开报道,非 PDF 原文内容。)
GWM 的定义:理解—想象—行动闭环
文章从神经科学借了一个类比:人脑是一台预测机器。预测编码理论认为,大脑持续生成对感知信号的自上而下预测,只把预测误差向上传递;运动控制中小脑学习内部前向模型,预测自身动作的感觉后果。我们所说的"技能",很大程度上就是一个训练良好的内部世界模型。儿童认知发展也遵循同样顺序:先通过大量观察建立广泛的世界知识(learning by seeing),再通过具身行动打磨它。
由此推导,机器世界模型必须整合三种能力,并形成闭环。第一是理解(Understanding):把视觉、语言、听觉、具身观测整合成与当前任务相关的内部状态,并在证据不足时保留不确定性。第二是想象(Imagination):从内部状态预测多种可能未来,包括不确定的、反事实的、动作条件下的未来,而不只是预测下一帧。第三是行动(Action):把目标和预测转化为对世界的干预,并用反馈修正后续预测——行动不是挂在模拟器上的输出头,而是把模型的知识锚定在因果关系里。
这个定义划出了明确边界。只能生成逼真视频的系统没有行动闭环;潜空间世界模型没有扩展到开放视频和多本体;VLA 策略里未来预测只是隐式内部特征。GWM 要求三者同时存在:世界生成、交互和物理行动应当是同一基座的不同阶段,而不是三个不相关的产品。
五级路线图:从生成像素到组织世界
文章把 GWM 的演进分为五个自主性递增的级别,主轴是"像素→交互→行动→自主→组织"。
L4 的关键不是把给定任务执行得更好,而是智能体自己发现该做什么。文章的例子是:机器人注意到一滩没人报告的水渍,主动在有人滑倒前清理掉;或者发现一个与预测矛盾的实验结果,主动去调查。L5 把自主性从单个智能体扩展到组织层面,比如根据设备、物料和优先级的变化动态重组一座工厂。文章还给语言模型留了位置:从 L1 的语义条件到 L5 的多智能体沟通与任务分解,语言是 GWM 的内在组成部分,不是与它竞争的独立路线。
边界同样写得明白:目前所有系统只覆盖 L1 到 L3,L3 系统也只在外部给定的目标和有限任务分布内运行,没有任何系统展示了 L4 要求的开放式探索和持续自我改进。
怎么造一个 GWM:数据金字塔、MoT 架构与算力
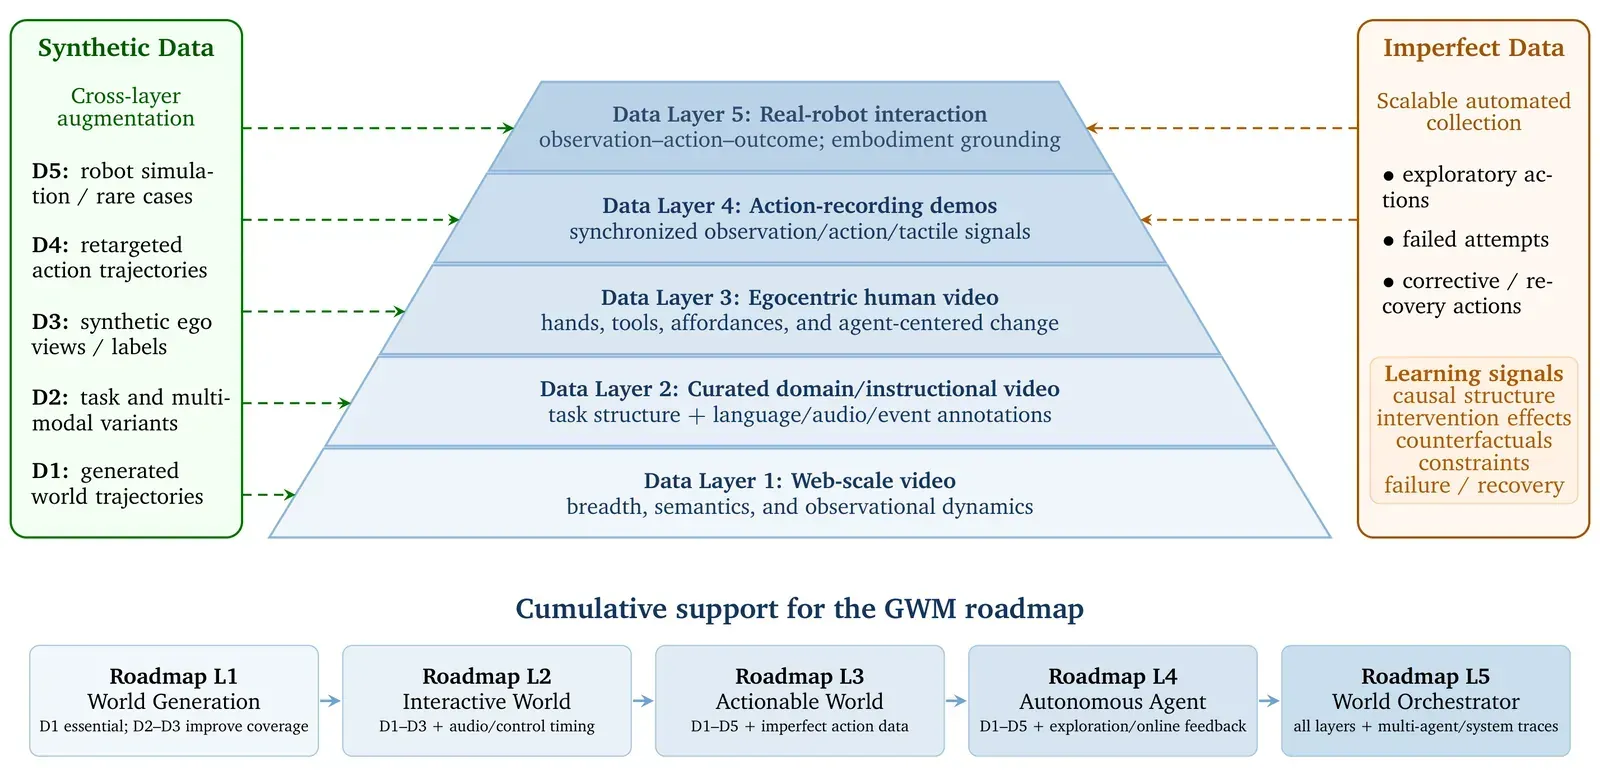
文章给出三个构建要件。数据被组织成五层金字塔:底层是网络规模视频,提供广度但几乎没有动作标注;向上依次是领域与教学视频、第一人称人类视频(如 Ego4D、Egocentric-100K)、带动作记录的人类演示(UMI 类数据,如同步记录手部动作与触觉的持握设备);塔尖是真实机器人交互数据(如 Open X-Embodiment、AgiBot World)。越往上,任务、动作和本体对齐越强,数据越稀缺。合成数据横跨所有层做增强;失败和不完美的轨迹被明确当作学习信号——它们教模型干预的后果、失败与恢复,而不只是模仿成功。对于海量的无动作视频,文章列出三条互补的学习路线:逆动力学(从观测反推动作,如 VPT)、潜空间预测(如 V-JEPA)、生成式建模(扩散目标加 U-ViT 这类可扩展骨干)。
第二个要件是架构,文章选择 MoT(Mixture-of-Transformers)作为当前实现:语言、视频、动作各有专门的 Transformer 参数,但共享联合注意力。围绕 GWM 的三种能力,可以组织成理解、想象、行动三个专家;联合注意力让动作 token 直接以视觉和语言上下文为条件,未来状态 token 以候选动作为条件,整条"理解—想象—行动"环路因此可微分。与稠密早期融合(如 Chameleon)、学习型门控 MoE、混合骨干(如 Transfusion)相比,MoT 是折中:模态不同处专门化,推理交互处共享。
第三个要件是算力,分两端。训练端要解决长视频上下文的内存与通信问题,采样配比还要防止网络视频淹没稀缺的动作数据。推理端要满足实时预算:文章列举了 SageAttention 量化注意力、TurboServe 服务系统、DPM-Solver 高阶求解器(约 10 到 20 次函数评估即可采样)、一致性蒸馏、分布匹配蒸馏(DMD)和 rCM 等技术;全栈框架 TurboDiffusion 组合低位宽、稀疏注意力与步数蒸馏,在大视频扩散模型上实现了 100 到 200 倍端到端加速。实时性不是工程细节,而是路线图的前提:没有低延迟,L2 的交互和 L3 的闭环控制都不成立。
现有系统走到哪一级
L1 对应 Vidu。文章称其于 2024 年 5 月、紧随 Sora 之后推出,基于 U-ViT 扩散骨干,单次可生成最高 1080p、16 秒的视频。后续 Vidu Q 系列提出参考生成视频(R2V)范式:多张参考图指定主体、角色、物体或场景,配合文本指定动态,生成中保持被引用对象的视觉一致性。文章称 R2V 正在成为工业界视频生成的标准功能,这是厂商自己的判断。同级别的外部系统还有开源的 Wan 系列和支持音视频联合生成的 Seedance 2.0。 L2 对应 Vidu S1。它把语音从配乐变成控制通道:生成过程中用户随时可以口头下新指令,让角色挥手、做手势、起身或坐下,指令改变的是后续视频内容,而不只是驱动口型。训练分三步:先训双向视频-音频扩散模型建立生成先验,再结合 teacher forcing 与 Diffusion Forcing 做因果化改造,最后用分布匹配蒸馏加分阶段一致性正则,把自回归去噪压缩到少数几步。推理端用固定尺寸滑动窗口让单步成本与视频时长脱钩,以 TwinCache 复用历史状态提升效率和稳定性,配合 TurboDiffusion 与 TurboServe,在消费级 GPU 上达到 540p、最高 42fps。文章同时承认,S1 只在生成的数字世界里交互,不构成完整的 GWM 闭环。
L3 由两个系统承接。Motus 于 2025 年 12 月开源,是一个统一潜在动作世界模型:MoT 架构协调理解、视频生成和动作三个专家,UniDiffuser 式目标把视频和动作作为同一多模态分布的条件、边缘和联合查询模式——世界建模、VLA 预测、逆动力学、视频生成都是同一基座的不同查询。光流导出的潜在动作提供可迁移的运动监督,分阶段训练再把表示适配到机器人控制。
Motubrain 在此基础上扩展部署能力:统一任意视角建模以适配不同相机配置,独立的文本流把语言理解直接耦合到动作生成,跨本体共享的相对末端执行器动作表示;通过缓存、低精度计算、CUDA Graph 和实时动作分块,完整模型运行频率约 5Hz,约为 Motus 的 10 倍,跳过视频解码的 Video-to-Action 模式最高 11Hz。在 RoboTwin 2.0 基准上,Motubrain 在干净设置和随机设置下的平均成功率分别为 95.8% 和 96.1%,适配一个新的人形机器人本体只需 50 到 100 条轨迹。
这些性能数字均来自原文,未经过第三方独立复现;RoboTwin 2.0 是仿真基准,不能直接等同于真实场景成功率。可用性方面,Motus 已开源,Vidu 系列是商业产品,Motubrain 为专有系统。
原文承认的缺口与六个未决方向
文章用一节专门说明"现有实践证明了什么、没证明什么":四个系统支持"生成、交互、行动可以在同一个基座模型计划内逐级发展"这个主张,但没有消除通往 L4、L5 的缺口。为此原文列出六个方向:评测要测通用性而不是孤立任务成功率;预测必须具备因果和物理基础,不能只是视觉相关性的复现;需要可写入、可查询、可修正的持久记忆;预训练要接上在线学习和自我改进;能力必须装进部署的延迟与资源预算;安全与可控性要随自主性同步增长,包括对预测状态和计划的可解释性。
这份路线图哪些部分可信,哪些还是愿景
从证据结构看,这篇文章最实的部分是对自身边界的标注和工程细节:数据金字塔里"失败轨迹也是监督信号"、MoT 的专家分工、推理加速的具体技术栈,都是可被复现或检验的陈述。L1 到 L3 的系统映射有公开产品和开源模型支撑,虽然性能数字目前只有官方口径。L4、L5 则完全是愿景——文章自己也承认没有系统达到,读者应把这两级当作研究议程,而不是产品预告。
这份文件还提供了一个观察具身智能竞争的框架:判断一个"世界模型"成色如何,可以直接问它处在哪一级——是只在生成像素,还是已经让人或机器进入闭环。按这个标准,视频生成质量的军备竞赛只对应 L1,真正的分水岭在 L3 的物理行动和 L4 的自主性。
 AI 速览