9 月 12 日,生数科技正式发布面向机器人灵巧操作的自进化通用世界模型 Motus2。不同于传统机器人模型仅能复刻动作,Motus2 将行动生成、未来预测、结果评估整合进同一模型,结合触觉反馈与大规模人类操作数据,实现了从 “会执行动作” 到 “能自主进化” 的跨越,是通用世界模型从 L3 向 L4 演进的关键探索。
一、产品定位:三大核心特征,定义灵巧操作世界模型
Motus2 是生数科技在通用世界模型路线上的具身智能落地成果,核心有三大标志性特征。
第一,首个全模态统一世界模型:在视觉、语言、动作之外,新增轻量触觉专家模块,让机器人不仅能 “看见” 物体,还能感知接触状态变化,支撑更精细的灵巧操作。
第二,首次实现闭环自进化迭代:同一个模型同时承担策略、模拟器和评估器角色,机器人可以利用自身的世界模型生成反馈,反过来优化行动策略,形成自我演进的能力。
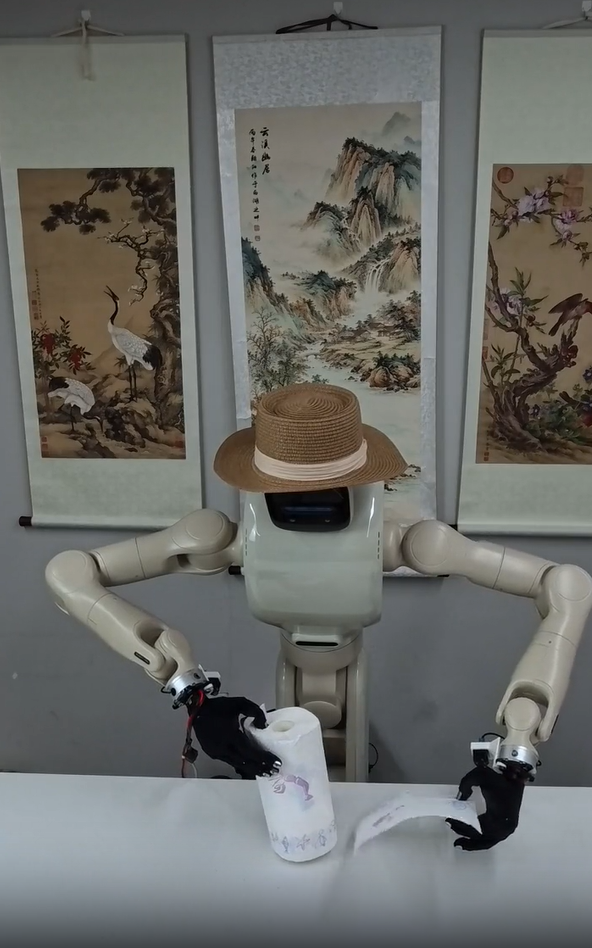
第三,首个高自由度灵巧手世界模型:基于大规模人类第一视角数据预训练,结合百小时级机器人领域训练,已落地 22 自由度 Sharpa Wave、20 自由度 WUJI Hand 2 等多款触觉灵巧手,可完成拧灯泡、双手撕纸、翻书、寻找隐藏物体等复杂操作。
二、核心架构:行动 - 预测 - 评估三位一体,构建自进化闭环
传统机器人策略模型只能回答 “下一步做什么”,无法预判动作后果;Motus2 则在统一的视频 — 动作模型中,整合了三套能力,形成完整闭环。
训练过程中,模型会生成多个候选动作,分别预测结果并评分,再用高价值动作的反馈更新策略,且只更新动作相关参数,避免判断基准同步偏移。执行时还可通过Best-of-N 机制“多想一步”,从多个候选方案中选择最优动作。 这一机制呈现出RSI(递归自我改进)的初步特征:模型用自身对世界的预测与评估结果,反过来改进行动策略,失败的动作也能转化为有价值的经验,而非被直接丢弃。
三、数据与实测:13 万小时人类数据,真机任务成功率 84%
机器人操作数据稀缺,是行业长期痛点。Motus2 构建了多层次Ego 第一人称数据体系,底层是约 13 万小时人类操作视频,覆盖单目、双目视角,学习物体交互规律;中间层补充动作数据,细化手与物体的空间关系;最终通过 100 多小时机器人轨迹与人机对齐数据,将人类经验迁移到真实机器人上。
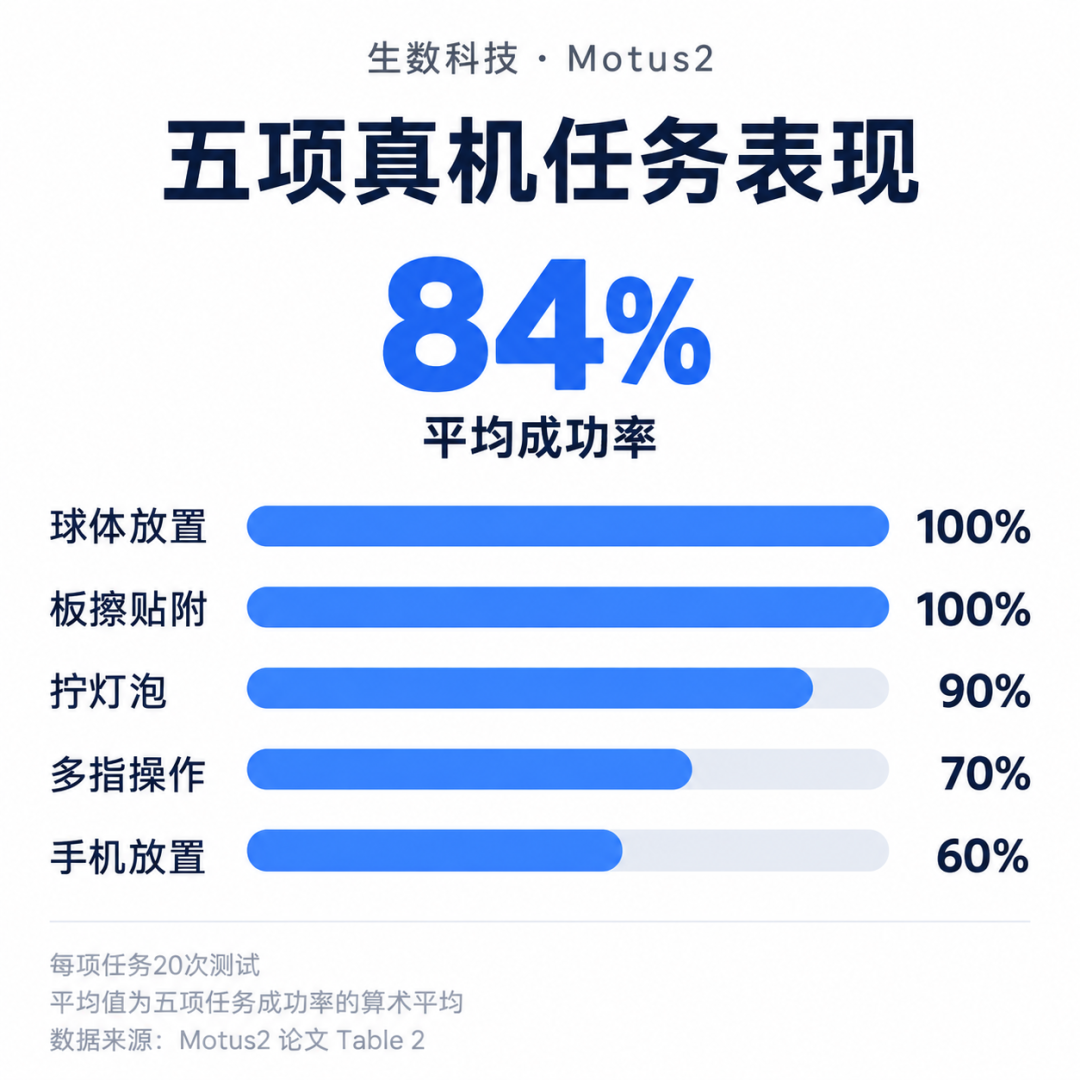
实验数据显示,随着双目数据从 200 小时增加到 2 万小时,模型的人类动作预测误差持续下降。在五项真实机器人任务中,Motus2 平均成功率达到84%;
对照实验显示,仅经过人类视频预训练的模型成功率为 51%,加入机器人领域中间训练后提升 33 个百分点。 此外,长时记忆机制让寻找隐藏物体任务成功率从 25% 提升至 57.5%;触觉模块加入后,抽取纸杯、撕纸任务成功率从 60% 提升至 72.5%,提升 12.5 个百分点。
四、行业价值:从 L3 到 L4,通用世界模型的关键跨越
按照生数科技提出的通用世界模型五级路线:L1 生成世界、L2 与世界交互、L3 在世界中行动、L4 自主世界智能体、L5 世界组织者。Motus2 已经具备 L3 的完整能力,并首次将评价与反馈显式纳入闭环,验证了从 L3 “能够行动” 向 L4 “能够自主进化” 演进的可行性。
当前模型仍处于初步探索阶段,从多任务策略优化到开放世界长期自主学习,还有很长的路要走。但它已经证明:世界模型的核心不只是预测下一帧画面,更是预演行动后果、判断动作价值、用反馈持续进化。当机器人不仅会模仿,还会思考、试错、总结经验,具身智能才真正开始走向物理世界。
 AI 速览