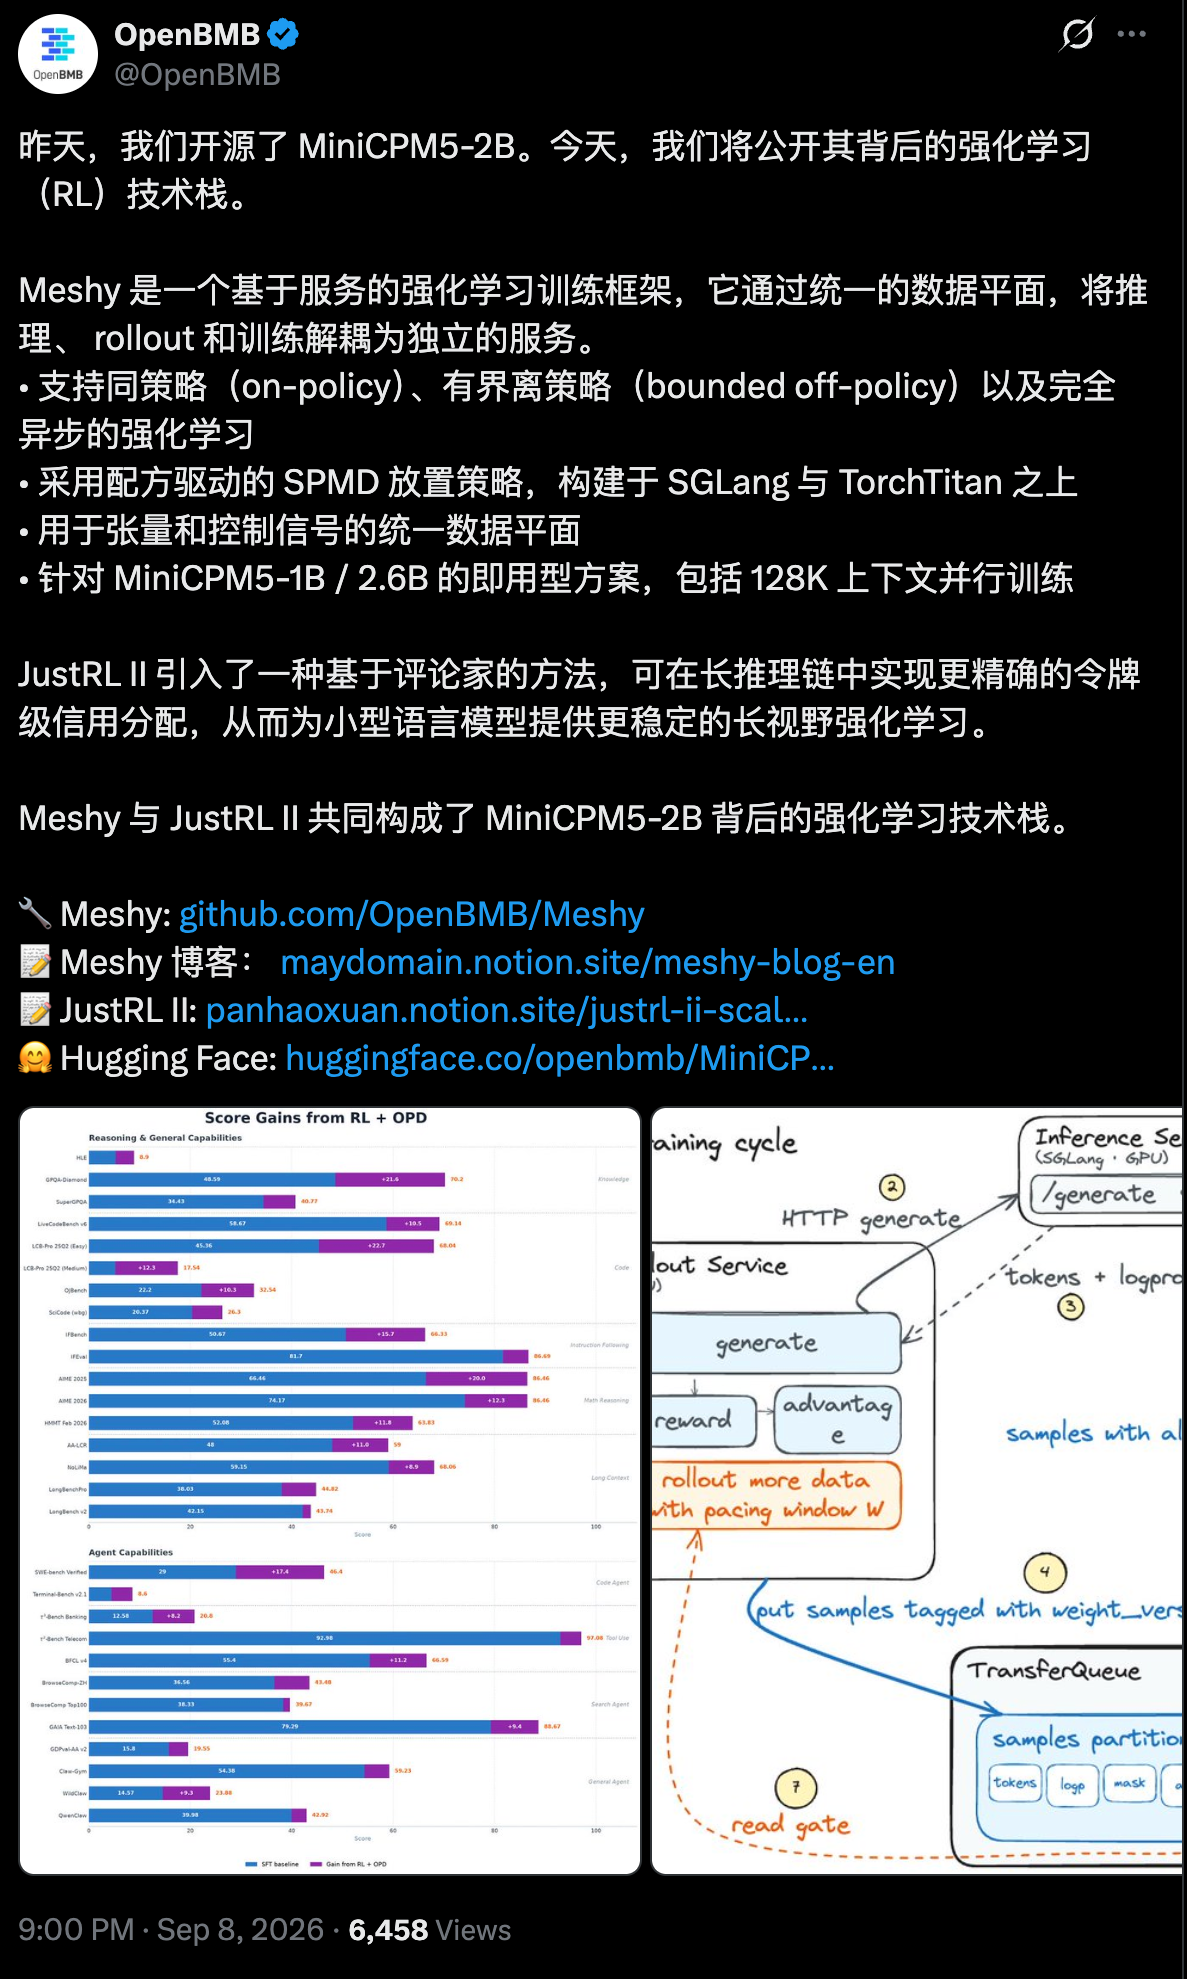
- Meshy 是 OpenBMB 开源的 RL 训练框架(Apache 2.0):把推理、训练、rollout、Teacher 等角色建模为独立服务,无中央控制器、无 Ray,构建于 SGLang 与 TorchTitan 之上。
- 数据与控制统一走 TransferQueue 数据平面,元数据与张量分开传输;每个权重版本仅需一个控制信号,拓扑由各服务在启动时从同一配方本地推导。
- 同一套服务覆盖 on-policy、有界 off-policy 与全异步训练,切换只需修改配方中的 rollout 配置。
- JustRL II 是配套算法:保留 GRPO 群组结构、引入学习到的价值函数做 token 级信用分配,配合三阶段数据清洗,面向小模型长思维链 RL(128k 生成长度预算)。
- 数学推理案例:约 10 万题(DAPO-Math、DeepScaleR、DeepMath 合并)、每题 8 个 rollout;critic-free 基线在 AIME 2025 上到 74% 后漂移,JustRL II 持续提升至 step 334 的 81%。
- 即用配方覆盖 MiniCPM5-1B 与 2.6B(含 4 卡方案),同一配方已应用于 MiniCPM5-2B;官方称 RL+OPD 较 SFT 提升推理/通用能力平均 10.96 分、Agent 能力 6.96 分。
Meshy 是什么:把 RL 的角色拆成对等服务
一轮 LLM 强化学习训练里至少有四种角色:生成 rollout 的推理服务、更新权重的训练进程、产出样本的 rollout 引擎,以及在部分流程里存在的 Teacher 模型。Meshy 的做法是把每个角色都建模成独立服务,服务之间只通过最小接口协作——官方博客的表述是,让分布式编排框架不再是 RL 系统的中心。
三个模块各司其职。训练侧基于 TorchTitan,推理与 rollout 基于 SGLang,角色间的所有样本数据流经统一的 TransferQueue 数据平面;元数据与张量分开传输,生产者写入特定数据列,消费者在配方里声明自己依赖的列,样本集齐全部依赖列后才会被取走。启动时,每个进程从同一份配方本地推导出自己的拓扑,运行时不需要中央进程派发任务;权重同步只依赖每个版本一个控制信号,信号有序、可追踪,服务是否丢失、乱序或重复消费事件,都可以通过观察 TransferQueue 里的信号投递来判断。
核心技术一:SPMD 范式下的角色驱动架构
要理解 Meshy 的取向,先看它反对的东西。以 verl 为代表的 Single-Controller 架构(HybridFlow,arXiv:2203.12533)把异构分布式计算表达成顺序程序,解决了同步 RLHF 时代最重要的编排问题;但官方博客的判断是,一旦执行不再严格同步、任务跨越多轮训练,单控制器就会从简化系统的抽象,变成数据传输与任务调度的障碍——verl 默认把全部样本数据加载进 driver 再转发,博客称之为两者「最实质的架构差异」。
Meshy 的替代方案是角色驱动的服务化:推理、训练、rollout、Teacher 等角色各自独立运行,数据平面直接把数据从生产者送到消费者,不经过编排进程。部署遵循 SPMD 范式——每台机器运行同样的程序、靠集合通信协作——但 SPMD 只负责表达单个模型的前反向计算,顶层 RL 工作流则交给角色服务化来表达。效果是:on-policy、有界 off-policy 与全异步三种训练模式共用同一套服务,切换只在配方的 rollout 配置里改参数;官方给出的一个示例里,Inference-Teacher-Training 的 OPD(在线策略蒸馏)场景中,Inference 服务作为兜底角色共享 GPU。
核心技术二:JustRL II——带 Critic 的长思维链 RL
JustRL II 解决的是小模型长思维链强化学习的两个老问题。其一是数据:开源 RL 数据里混有噪声标签、不可验证的题目,以及与基座模型难度失配的问题,导致奖励信号稀疏或有误导性。其二是算法:GRPO 式的组平均基线是一个响应级的粗参照,在超长推理轨迹上能给 token 级信用分配提供的信息有限,训练后期容易退化。
JustRL II 的配方分两侧。数据侧是三阶段管线,对开源数据做审计,并重新校准到目标 checkpoint;算法侧保留 GRPO 的群组结构——用它自适应地把训练聚焦到难度合适的 prompt 上——同时引入学习到的价值函数(critic)提供 token 级信用分配,加上 tail-only 的超长控制来限制过长的 rollout,并基于群组结构构建了贯穿训练全程的 critic 诊断框架。官方博客给出的数学推理案例里,初始数据集约 10 万题(DAPO-Math、DeepScaleR、DeepMath 合并),每个 prompt 采样 8 个 rollout,生成预算 128k Token:不带 critic 的基线在 AIME 2025 上到 74% 左右(step 154)后开始漂移,JustRL II 持续提升,到 step 334 达到 81%。
这套配方已经应用于 MiniCPM5-2B。按 MiniCPM5-2B 手稿的口径,RL 加 OPD 相对 SFT 让推理与通用能力平均提升 10.96 分、Agent 能力提升 6.96 分。
适用场景与效果边界
适配的场景有三类:小模型的长思维链 RL 训练;需要异步生成、持续训练或多角色流程(比如带 Teacher 的在线策略蒸馏)的训练任务;以及希望摆脱 Ray 依赖、更看重 RL 运行可观测性的团队——Meshy 的控制信号机制让事件丢失、乱序、重复消费都变得可查。
边界同样具体。项目处于早期:预构建 Docker 镜像的版本号还是 0.1.0-alpha,社区与文档都在起步阶段。官方的对比基线主要针对 verl,与其他框架的迁移成本需要自行评估。JustRL II 的公开案例以数学推理为主,其他领域的配方效果要看官方仓库的后续更新。另外,MiniCPM5-2B 上的提升数字全部是 OpenBMB 自报口径,独立复现尚未出现。还有一个小坑:检索「Meshy」会先遇到同名的 3D 模型生成服务,找这个框架时记得带上 OpenBMB。
快速上手:Docker 镜像与 MiniCPM5 配方
前置条件是装有 NVIDIA Container Toolkit 的 Docker(或 Ubuntu 24.04 原生环境、Python 3.12 以上)。最快路径是官方预构建镜像:
也可以用仓库自带的 Dockerfile 自行构建(docker build -t meshy .)。镜像内虚拟环境挂在 /opt/meshy,PyTorch、SGLang、TorchTitan、TransferQueue 均已预装——进入 shell 即算环境就绪。仓库提供 MiniCPM5 系列的即用配方 justrl_minicpm5_1b、justrl_minicpm5_2_6b 与 4 卡版 justrl_minicpm5_2_6b_4gpu(数据为 DAPO-Math-17k);RL 数据集可用同批开源的 UltraData-RL-2609(8 万余条可自动校验的 RL 任务)。常见失败多与 GPU 未挂载有关:宿主机未装 NVIDIA Container Toolkit 时,容器内看不到 GPU。
在 RL 训练框架生态中的定位
verl 的 Single-Controller 加 HybridFlow 是当前 RL 训练框架的主流形态,Meshy 给出的是 SPMD 范式下的角色驱动替代方案——官方强调的额外收益是可观测性:控制信号有序、可追踪,RL 运行的全局状态对开发者可见。放在 OpenBMB 的动作序列里看,继 MiniCPM5-2B 的权重、数据、配方之后,框架是这套全栈开源的最后一块:从模型到数据到训练基础设施,端侧小模型的 RL 路线第一次有了可完整复刻的开源链路。对正在跑小模型长思维链 RL、或者想评估「去 Ray」架构的训练团队,这是一套可以直接拉起来对照的参考实现。
项目地址:https://github.com/OpenBMB/Meshy
JustRL II 博客:https://panhaoxuan.notion.site/justrl-ii-scaling-small-llms-to-128k-reasoning-with-a-critic
 AI 速览