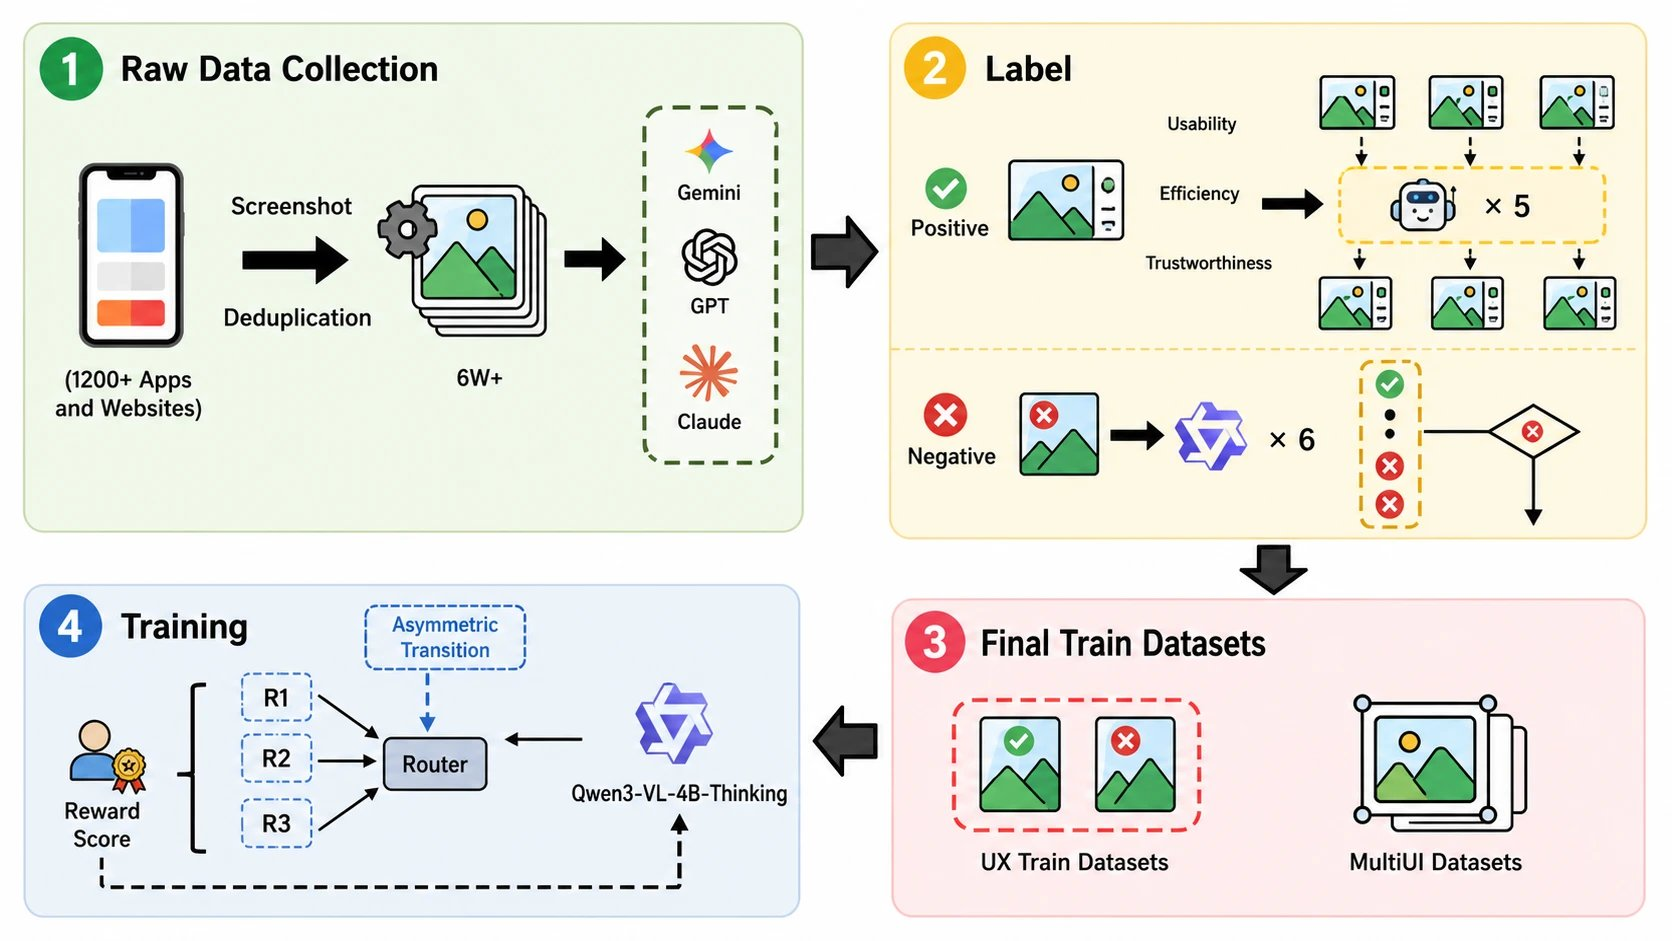
- 蚂蚁集团支付宝体验技术部开源 UI-UX,一个专为移动端 UI/UX 缺陷诊断优化的多模态大模型
- 仅需单张截图输入,即可诊断可用性、效率、可信度三大维度共 8 类体验问题
- 仅 4B 参数,在自研基准 UXBench 上达到 79.63% 准确率,超越 Claude-4.5-Sonnet(65.50%)21.6 个百分点
- 两项关键创新:任务自适应奖励路由 + 非对称转换奖励(抑制过度思考,生成长度缩减 81.1%)
- 论文入选 CVPR 2026 Findings,模型以 MIT 许可开源
- 同步发布 UXBench——首个面向 UX 推理的视觉语言基准,含 2000 条真实 UI 截图样本
背景:为什么需要一个专门做 UX 诊断的模型
移动端产品的竞争早已不是功能之争,而是体验之争。一个弹窗遮住了返回按钮、一个活动标题与落地页内容不一致、两个模态弹窗同时弹出让用户无所适从——这些问题不会让应用崩溃,但会让用户流失。
传统的 UI 自动化测试能发现崩溃和布局错位,但对"体验层"的问题无能为力。这类问题的本质不是像素级的视觉缺陷,而是设计意图与用户心智模型之间的错位——它需要因果推理,而非模式匹配。
现有的通用多模态大模型(GPT-4o、Claude、Gemini)在这个方向上表现如何?蚂蚁团队的实验结论是:严重不足。 即使是最强的闭源模型 Claude-4.5-Sonnet,在专门的 UX 推理任务上也只能达到 65.50% 的准确率。通用模型擅长"看到界面上有什么",但不擅长"判断这个设计是否会让用户困惑"。 这就是 UI-UX 模型要解决的问题。
UI-UX 模型:怎么做到的
基础架构
UI-UX 基于通义千问 Qwen3-VL-4B-Thinking 架构构建——这是一个自带思维链(Chain-of-Thought)推理能力的视觉语言模型。模型通过 ... 标记显式生成推理过程,然后给出最终判断。 但原始的思维链模型有一个问题:过度思考。 模型经常生成大量冗余的推理步骤,既增加延迟又不提升准确率。蚂蚁团队的实验数据显示,在错误样本中,推理步骤的转换标记平均出现 14.38 次,而正确样本中仅 2.48 次——越啰嗦越容易出错。
两项关键创新
1. 任务自适应奖励路由(Task-Adaptive Reward Routing)
不同类型的 UX 诊断任务需要不同的评估标准。UI-UX 使用 GRPO 强化学习算法,针对不同任务动态切换奖励函数:
- 语义理解类任务 → ROUGE-L 分数(描述是否语义一致)
这使模型在不同任务间无需手动切换策略,实现端到端的统一优化。
2. 非对称转换奖励(Asymmetric Transition Reward)
这是针对"过度思考"问题的直接解法。模型在推理过程中每产生一次"思维转换"(从一个推理步骤跳到另一个),系统就施加一个惩罚信号。惩罚是非对称的——对冗余步骤的惩罚强于对简洁推理的奖励。
效果:生成长度从平均 1770 token 缩减到 334 token(缩减 81.1%),准确率基本持平(77.71% vs 76.75%)。 更短的推理意味着更低的延迟和更低的推理成本。
训练数据
训练数据来自真实场景:
- 在 8 台物理设备(覆盖 Android、HarmonyOS、iOS)上运行自动化测试脚本
- 结合硬负例挖掘(hard negative mining)和语义保持增强策略解决正样本稀缺和类别极端不平衡问题
UXBench:首个 UX 推理基准
UI-UX 模型的评估不是在通用 benchmark 上跑分——团队同步发布了 UXBench,这是首个专门面向 UX 缺陷诊断的视觉语言基准。
三大维度、八项任务
数据质量保障
- 数据标注流程:Gemini-2.5-Pro 初筛 → 微调 Qwen3-VL-2B 大规模复判 → 四位资深 UX 研究员两轮人工验证
- 覆盖 iOS/Android 平台、浅色/深色主题、多种屏幕方向
- 40% 为二选一题目,60% 为三选一题目——每道题都需要因果推理,不是关键词匹配
性能:4B 参数打败了什么
几个值得注意的对比:
- 超越 Claude-4.5-Sonnet 21.6 个百分点 — 后者是目前公认的多模态推理最强闭源模型之一
- 超越同族 Qwen3-VL-235B 42.2% — 参数量小 59 倍,准确率反而高出一大截。这说明通用模型在垂直任务上的"大力出奇迹"策略完全失效,领域特化的强化学习才是关键
- 消融实验显示:硬负例挖掘贡献了 +19.41% 的准确率提升,是最大的单一增益来源
实际应用场景
这个模型能干什么?几个直接的落地方向:
1. 自动化 UX 质量门禁
在 CI/CD 流程中接入 UI-UX,每次发版前自动对关键页面截图进行 UX 诊断。弹窗遮挡、内容不一致等问题在进入生产环境前被拦截。
2. 大规模 UX 巡检
对于像支付宝这样拥有数千个小程序和服务页面的超级 App,人工 UX 审查不现实。UI-UX 可以批量扫描所有页面,按严重程度排序输出问题清单。
3. 设计评审辅助
设计师交付稿件后,用 UI-UX 做第一轮自动 review——是否有弹窗缺少关闭按钮、是否有元素遮挡、是否有文案不一致。把人类评审员的时间留给更高级别的体验判断。
4. 竞品 UX 分析
对竞品应用截图批量运行诊断,快速发现竞品的 UX 短板,为产品决策提供数据支撑。
技术细节:部署与使用
快速开始(Transformers)
生产部署(vLLM)
模型以 MIT 许可开源,无商用限制。上下文长度 16K token,精度 bfloat16,单卡即可运行。
为什么这件事重要
从更宏观的视角看,UI-UX 模型代表的是一个趋势:AI 正在从"辅助人类做事"走向"替代人类判断"。
UX 诊断过去是纯人类的领域——它需要理解用户心理、需要对设计规范的内化、需要"看到一个界面后判断它哪里让人不舒服"的能力。这是典型的"看起来简单但很难自动化"的认知任务。
UI-UX 用 4B 参数和领域特化的强化学习证明了:对于结构化的 UX 诊断任务,专用小模型可以大幅超越通用大模型。 这与当前"大力出奇迹"的通用 AGI 叙事形成了有趣的对比——在垂直领域,正确的问题定义 + 高质量数据 + 针对性训练方法,比堆参数有效得多。
同时,这也是支付宝(蚂蚁集团)在 AI 应用层持续输出的又一个案例。此前他们已经开源了 UI-UG(统一 UI 理解与生成模型),现在 UI-UX 补上了"体验诊断"这块拼图。从理解界面→生成界面→诊断界面体验,支付宝体验技术部正在构建一个完整的 AI 驱动 UI 工具链。
局限与未来
论文中也提到了当前的局限:
- UXBench 目前覆盖 8 类任务,尚未涵盖动效、手势交互、无障碍等维度
- 模型基于静态截图推理,无法处理需要交互序列才能判断的体验问题(如页面跳转逻辑是否合理)
- 未来计划引入认知心理学维度和真实交互日志,扩展 UXBench 的评估范围
- 目标是将 UI-UX 集成到实际的设计辅助工具链中
资源链接
- 论文(CVPR 2026 Findings):PDF
一句话总结
支付宝用一个 4B 参数的小模型证明了:在 UX 诊断这个垂直任务上,正确定义问题比堆参数重要得多。当通用大模型还在"看懂界面"的阶段时,专用模型已经能"判断界面哪里让人不舒服"了。这不是参数量的胜利,是问题定义和训练方法论的胜利。
 AI 速览