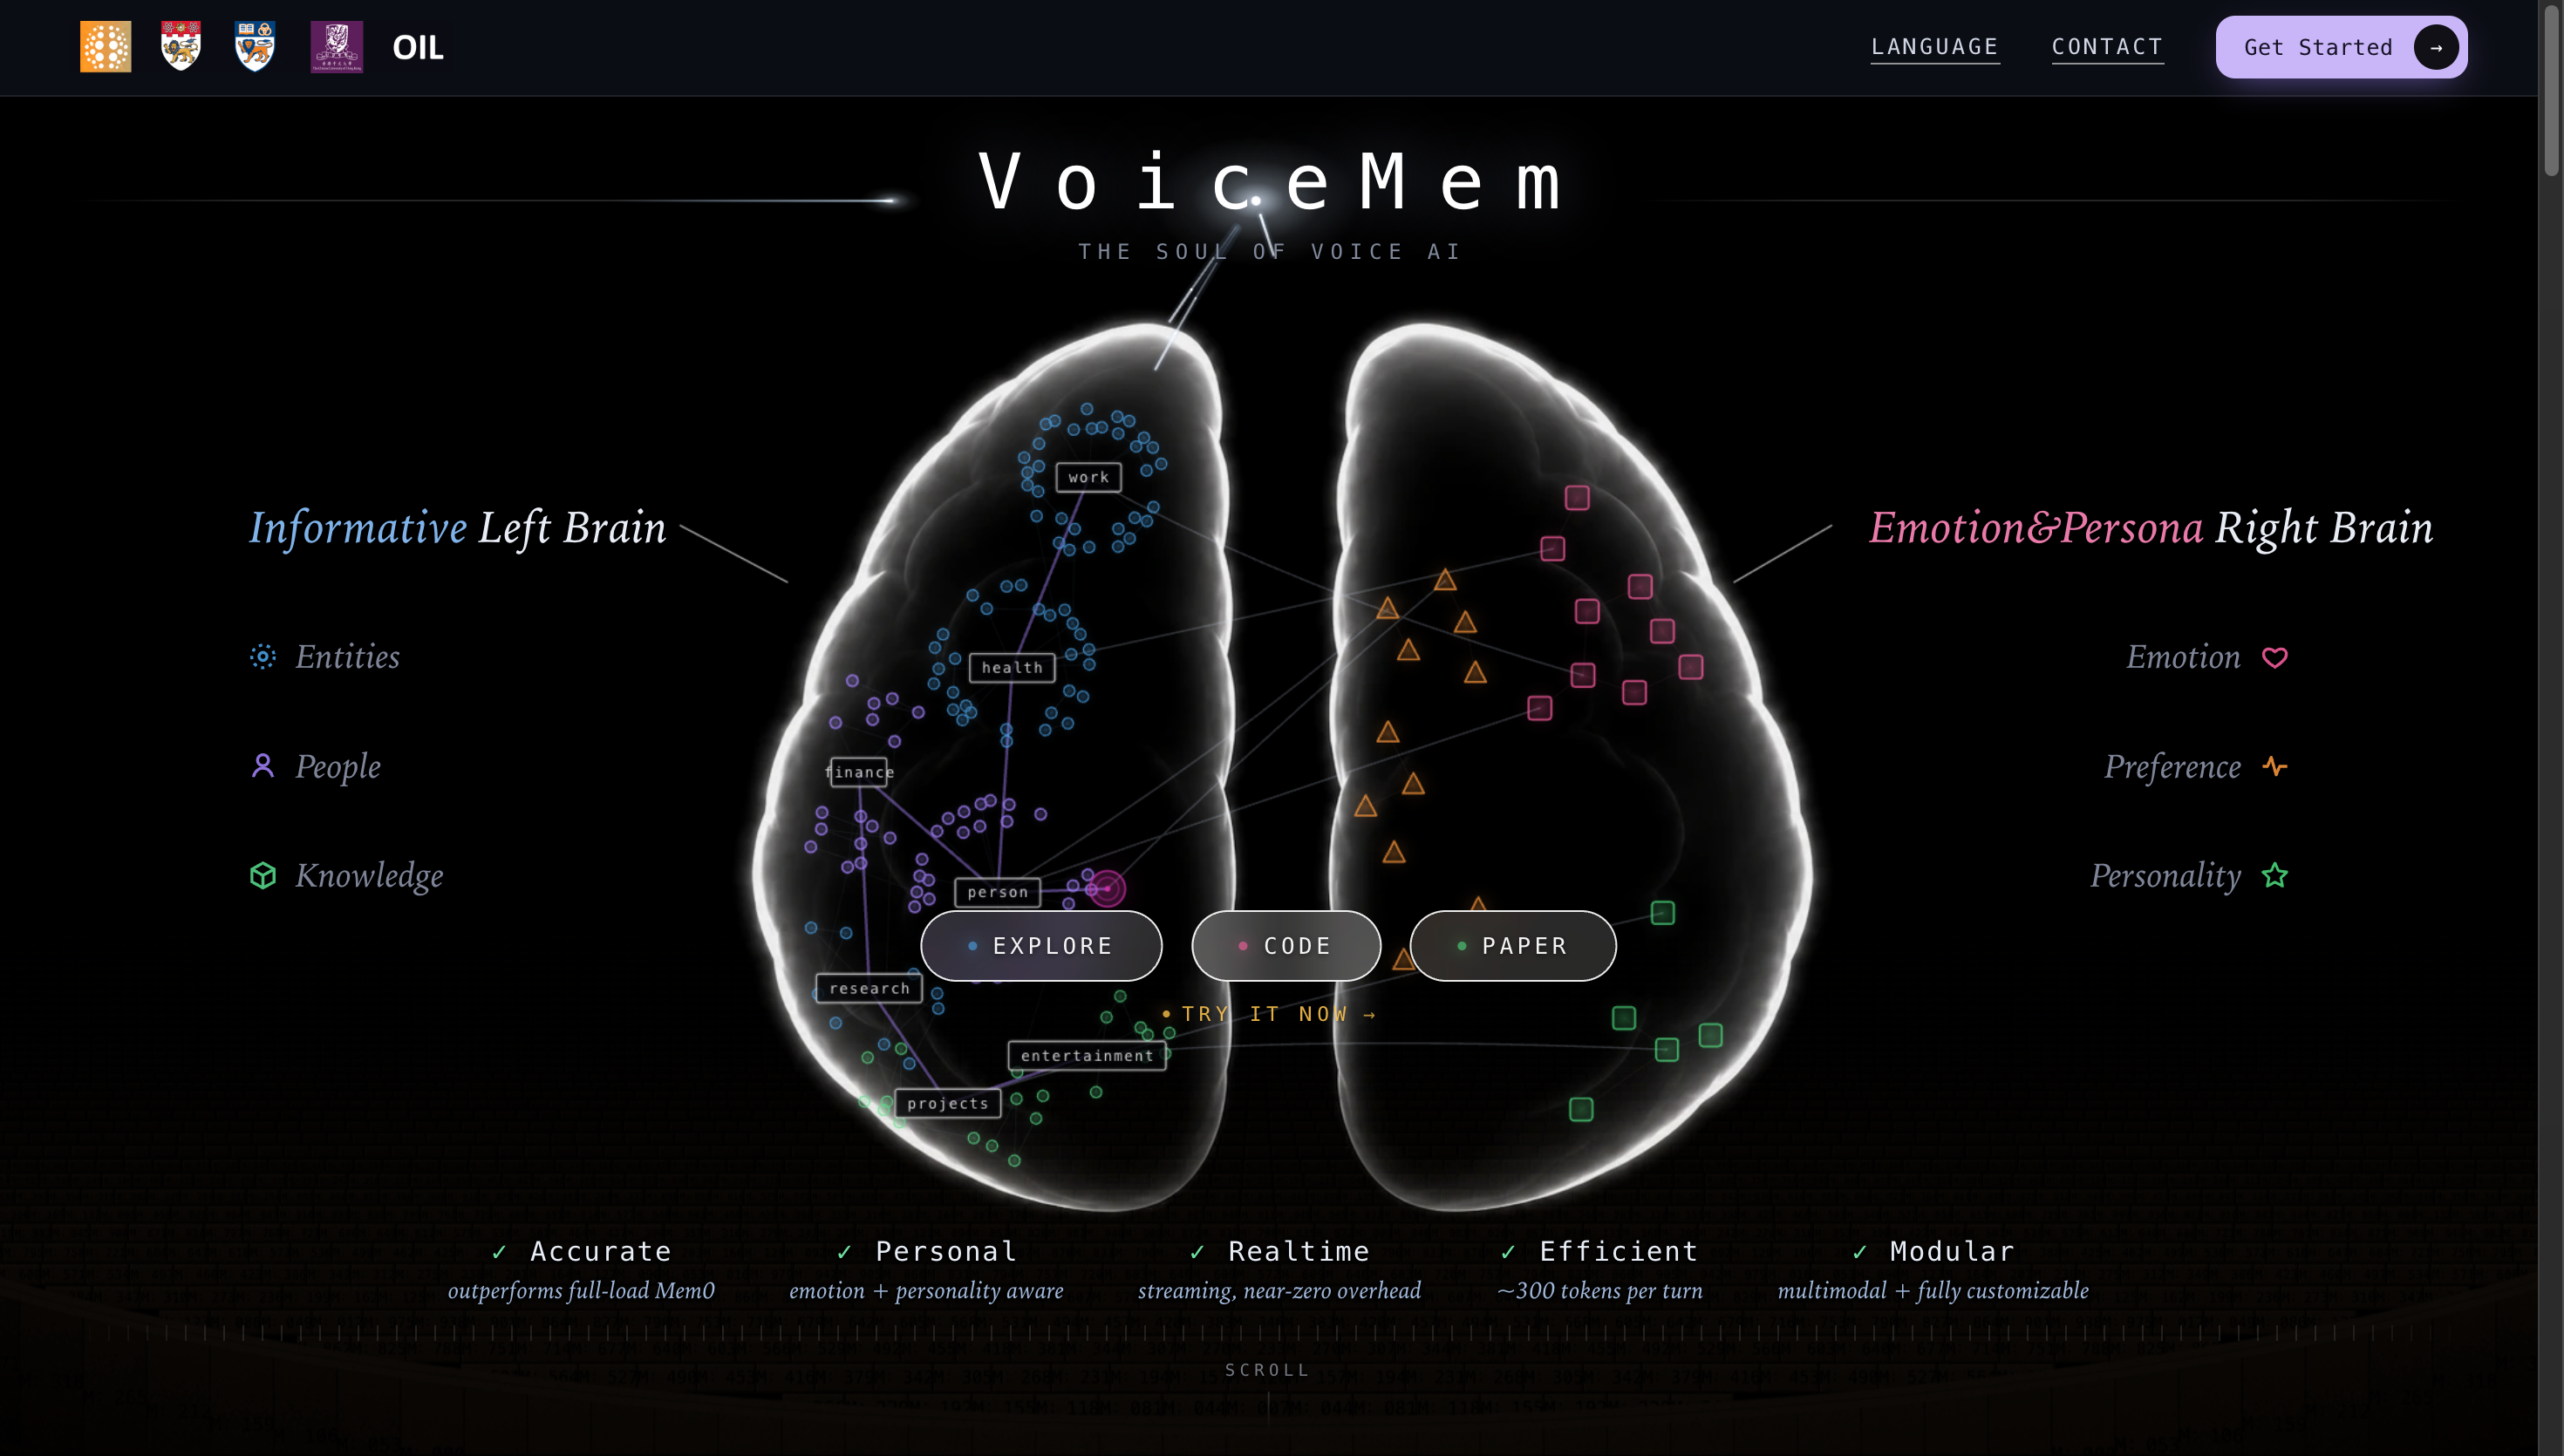
- VoiceMem 是一个面向实时语音智能体的开源记忆系统,Apache-2.0 协议,论文于 2026 年 8 月 26 日提交 arXiv
- 架构上分"双脑":信息左脑用 schema 组织事实记忆,情感右脑负责情绪归因与人格建模
- 流式记忆 I/O 让检索在 134 毫秒内完成,处在标准 VAD 延迟范围内,不增加对话时延
- LoCoMo 基准上,VoiceMem 用 top-5 检索(约 430 个记忆 token)拿到 91.2%,高于 Mem0 top-200 的 61.68 和 EverMemOS top-10 的 83.13
- 右脑在三个 persona 基准上超过此前最好系统 4.29 分
- 模型、ChatMem-400K 数据集与代码均已开源;HF DailyPapers 与一作称其为字节的记忆系统,论文署名为 NTU/NUS/清华,归属以论文正式版为准
VoiceMem 是什么:给语音助手装一套实时记忆
VoiceMem 的官方定位是"a real-time and empathetic memory system for voice assistants",一套兼顾实时与情感的语音助手记忆系统。它解决的问题很具体:语音对话转瞬即逝,现有记忆系统要么检索慢到拖垮实时对话,要么只能存干巴巴的事实,记不住用户是什么性格、什么情绪。
输入输出链路可以一句话说清:语音流进来,VoiceMem 边听边把值得记的内容写进记忆库;检索时,左脑返回事实性答案(饮食禁忌、约定事项),右脑补充情感与人格侧的信息(用户的偏好、说话习惯、关系状态),供回复模型生成带有个性的回答。它不替代语音模型本身,而是坐在 ASR 和对话模型中间的记忆层。
核心技术一:双脑架构,事实与情感分开学
第一项设计是把记忆拆成两个子系统。信息左脑以 schema(结构化模式)组织事实记忆,把对话里的实体和事实归档成可检索的结构。效果直接反映在检索效率上:在 LoCoMo 长对话记忆基准上,VoiceMem 只需 top-5 检索就拿到 91.2%,而对照系统要翻几十倍甚至上百倍的检索深度——Mem0 用 top-200 拿 61.68,Zep 用 top-100 拿 62.93,LangMem 用 top-100 拿 56.18,此前最强的 EverMemOS 用 top-10 拿 83.13。项目页给了一组精炼的概括:"Five memories. 430 tokens."(五条记忆,430 个 token)。
情感右脑处理的是传统记忆系统不覆盖的部分:长短期情感归因和双节点人格建模。它不只记录"用户说了什么",还追踪情绪随时间的演变,并维持一个稳定的人格表征。在三个 persona 基准上,右脑把聚合分数比此前最好系统提高了 4.29 分。对陪伴型、助理型语音产品来说,这部分决定的是"这个 AI 记不记得你是谁、在意什么"。
核心技术二:流式记忆 I/O,134 毫秒不挡话
第二项设计是流式读写机制。传统记忆系统通常等一轮对话结束再入库、再检索,VoiceMem 把记忆的写入和检索都做成随语音流持续进行的操作,边说边检索。官方数据是一次检索 134 毫秒,论文特别指出这个延迟处在标准 VAD(语音活动检测)延迟范围内,意味着记忆环节不会给实时对话增加可感知的时延。
实际部署上,流式模式通过 vm.stream() 接口开启,可配置 VAD 阈值和部分结果回调;写入侧依赖本地组件完成流式 ASR(FunASR)、声纹验证(sherpa-onnx)和向量化(e5-small)。写入时抽取事实用了一次 OpenAI API,检索阶段则全部在本地完成。
适用场景与效果边界
适用场景集中在实时语音交互:需要长期记忆的语音助理、陪伴型产品、以及多轮长对话场景。架构上左脑和右脑可以分开用—— leftbrain_only 模式只存无情感的事实文本,适合不需要人格化的工具型助手。开源依赖里出现了 mem0 的向量引擎,VoiceMem 实际上是把它作为底层存储,在其上重建了检索与记忆组织逻辑。
效果边界同样要说清楚。91.2% 来自作者自己的评测管线,仓库提供了 LoCoMo 复现命令,但尚无独立第三方复测;LoCoMo 本身是文本长对话基准,语音端到端场景的真实效果要开发者自行验证。检索全本地,但写入环节依赖 OpenAI API,想完全离线跑通需要自己替换这部分。项目发布仅一天,社区反馈和翻车案例还没有积累,生产环境采用前建议先用自己的对话数据跑评测脚本。
快速上手:部署与使用
代码在 GitHub(xzf-thu/VoiceMem),模型和数据集在 Hugging Face(zhifeixie 主页下,回复模型底座为 Qwen3-Omni 35B A3B 的 QLoRA 微调版)。按 README,最小安装如下:
离线验证记忆效果的最小示例:
top_k=5 对应论文里的部署点位。想零成本复现 LoCoMo 数字,官方评测脚本支持不调大模型的检查模式: python evaluation/run.py --dataset locomo --data data/locomo.json --inspect 。
作者团队:从 Mini-Omni 到 VoiceMem
一作 Zhifei Xie 来自清华大学,此前最知名的工作是 Mini-Omni 系列:2024 年 8 月发布的开源语音对话模型,首次实现"边听、边想、边说"的流式全双工交互,后续的 Mini-Omni2 又补上了视觉输入与双工能力。从 Mini-Omni 到 VoiceMem,研究主线一脉相承——先让模型实时地听和说,再解决实时对话背后的记忆问题。
论文作者共十位,资深作者包括颜水成(Shuicheng Yan):现任新加坡国立大学计算机学院特聘教授(实践),此前担任过昆仑万维天工智能联席 CEO(2024 年 11 月卸任,转任荣誉顾问)、360 集团副总裁兼首席科学家,并创立过 Sea AI Lab。
机构归属方面,"字节"一侧的证据是:一作在 X 上介绍 VoiceMem 时称其为字节的语音记忆系统,Hugging Face DailyPapers 官方账号转发论文时也沿用了 "ByteDance's new memory system" 的说法;据论文合作者 Ziyang Ma 的个人主页,Zhifei Xie 曾在字节跳动 Seed Speech 团队担任研究实习生,方向正是语音交互的全双工建模。
在语音 AI 记忆赛道中的定位
记忆层是当前 agent 基础设施里竞争最激烈的位置之一,Mem0、Zep、LangMem 都在做通用对话记忆,VoiceMem 的差异点选在两个未被占住的字眼上:实时(流式,毫秒级)与情感(独立右脑)。用极深的检索堆准确率是现有系统的通行做法,VoiceMem 反过来把检索深度压到 5,用记忆组织方式换检索效率,这个思路如果被独立复现验证,对车载、硬件端侧等延迟敏感的语音场景价值最大。
这套系统以 Apache-2.0 开源了从记忆管线到训练数据(ChatMem-400K)的完整栈,对做语音 agent 记忆的开发者是当下信息量最足的一份参考。
 AI 速览