首页
AI视频创作馆
工具库
AI 服务与资讯
变现学习营
AI提示词
模型配置计算器
登录/注册
NOiz AI 高质量 AI 语音生成平台-ChooseAI工具导航
首页
工具库
工具详情
NOiz AI
从 TTS 到音色定制的高质量 AI 语音生成平台
多语言翻译工具
语音大模型
TTS服务
音色克隆与合成
Noiz AI 是一款融合语音合成与智能摘要的多功能 AI 媒体工具。其语音模块依托自主研发的大规模语音模型,提供高保真、自然流畅、富有表现力的 文本转语音(TTS)服务,具备低延迟生成、高性价比与个性化定制能力,广泛应用于内容配音、音色克隆、音视频翻译等场景。用户可即时生成语音播报,或深度定制符合品牌调性的声音资产。
打开网站
我要评测
对比同类工具
预览
工具介绍
功能特性
提供高保真、低延迟的文本转语音(TTS)服务,支持情感标签与语调参数调节,生成自然流畅、富有表现力的语音。
支持零训练声音克隆,仅需3–10秒音频即可复刻音色,适用于个性化配音与品牌声音资产定制。
集成智能摘要能力,可对音视频内容进行自动转录、分段、翻译与提炼。
应用场景
短视频与自媒体内容配音:快速生成多语言、多风格的旁白或角色语音。
音视频本地化与翻译:自动完成字幕生成、语音翻译与口型同步,助力内容出海。
有声书与故事制作:支持多人物、多情感切换,适配长文本语音合成。
品牌声音资产打造:通过音色克隆定制专属品牌语音,用于客服、广告等场景。
适用人群
内容创作者、短视频博主、播客主等需要高效配音工具的个人用户。
教育机构、影视团队、跨境电商等需多语言音视频处理的企业用户。
定价方式
采用免费增值(freemium)模式,基础功能免费使用,高级功能(如高并发、精细音色控制、商用授权)按订阅收费。
支持语言
支持超过30种语言,包括中文、英文、日语、法语、德语、西班牙语、俄语、阿拉伯语等主流及部分小语种。
技术亮点
基于自研大规模语音模型,结合自然语言提示实现细粒度声音控制(如性别、口音、语速、情绪)。
语音合成质量与表现力接近真人水平,在低资源条件下仍保持高还原度,优于多数开源TTS方案。
使用方式
通过网页平台直接使用,无需下载安装;未来将推出桌面端与移动端App以支持离线及批量处理。
更新记录
2025年12月:上线表情包指挥AI配音功能,支持通过表情符号触发特定语气与情绪。
2025年5月:优化零样本声音克隆算法,提升3秒短音频下的音色还原准确率至95%以上。
相关资讯
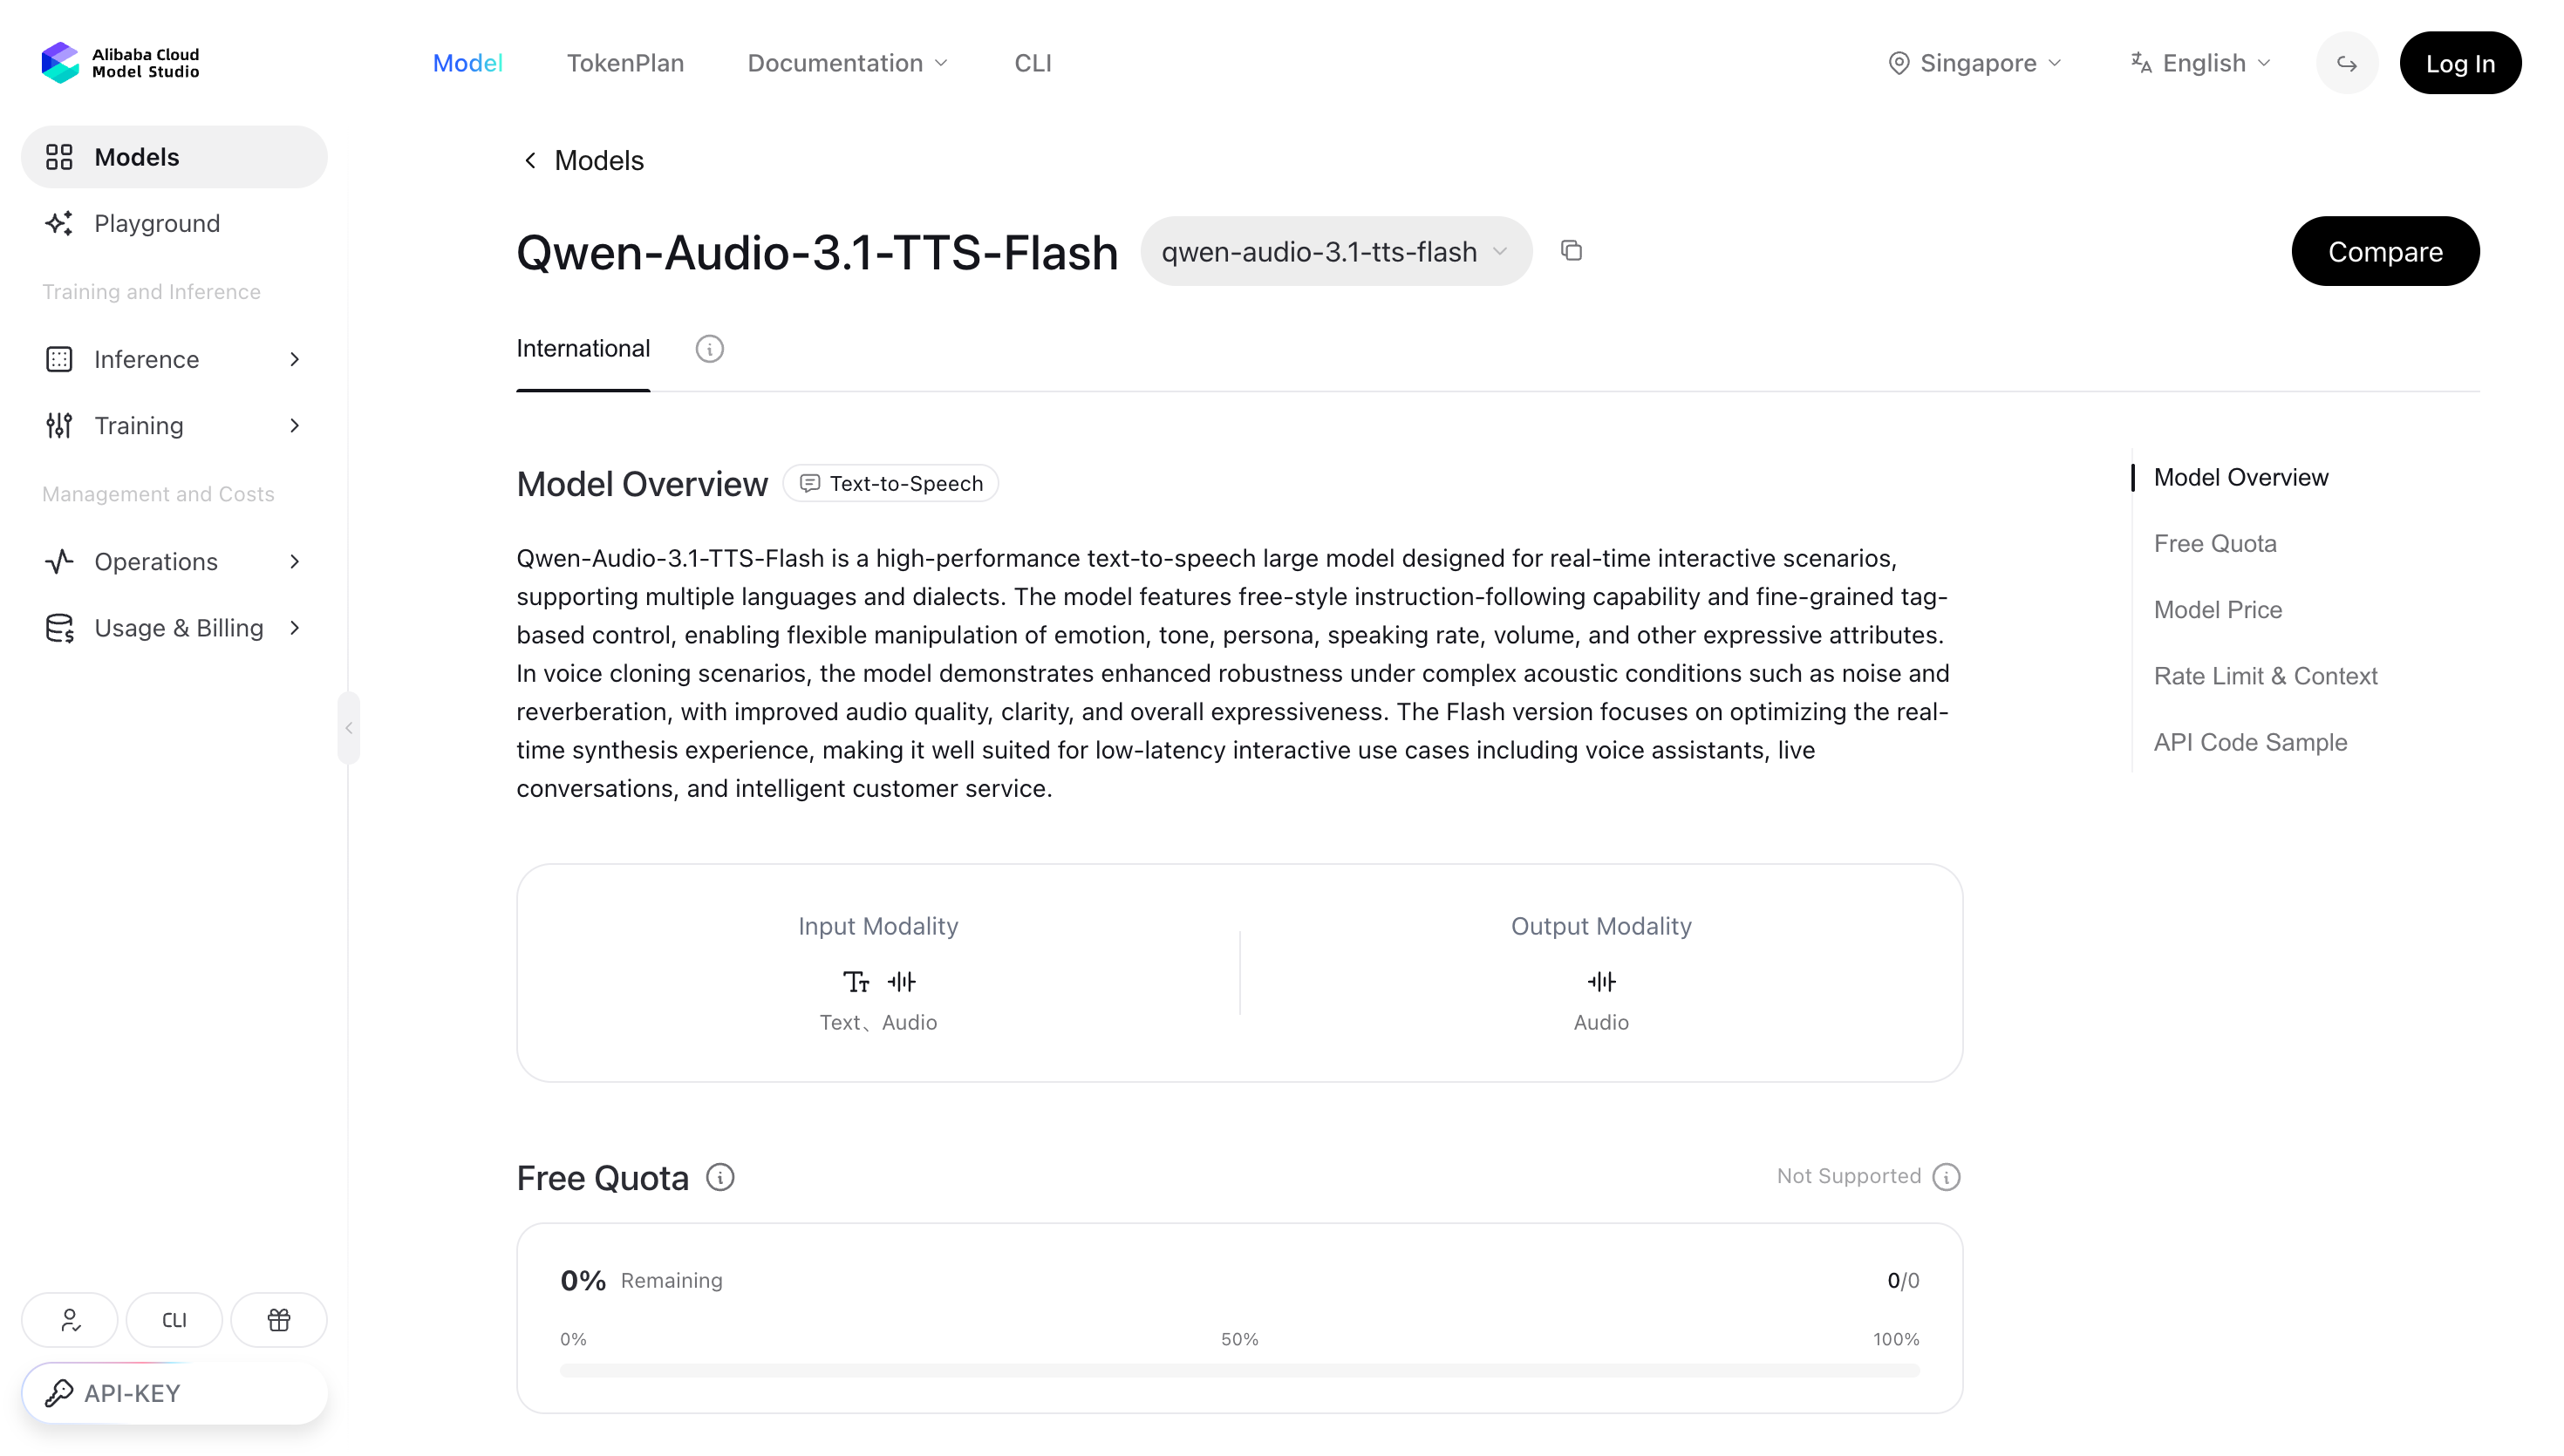
Qwen-Audio-3.1-TTS-Flash 上线阿里云国际站与百炼,先于云栖专场开放 API
9月20日消息,Qwen-Audio-3.1-TTS-Flash 上线阿里云 Model Studio。国际站(新加坡区)模型市场已可检索到该模型;阿里云帮助文档与百炼、国际站的语音合成文档收录了 qwen-audio-3.1-tts-fl
2026年09月20日
53
法国语音初创 Gradium 上线新一代 TTS:专攻结构化实体朗读,自评通过率 81%
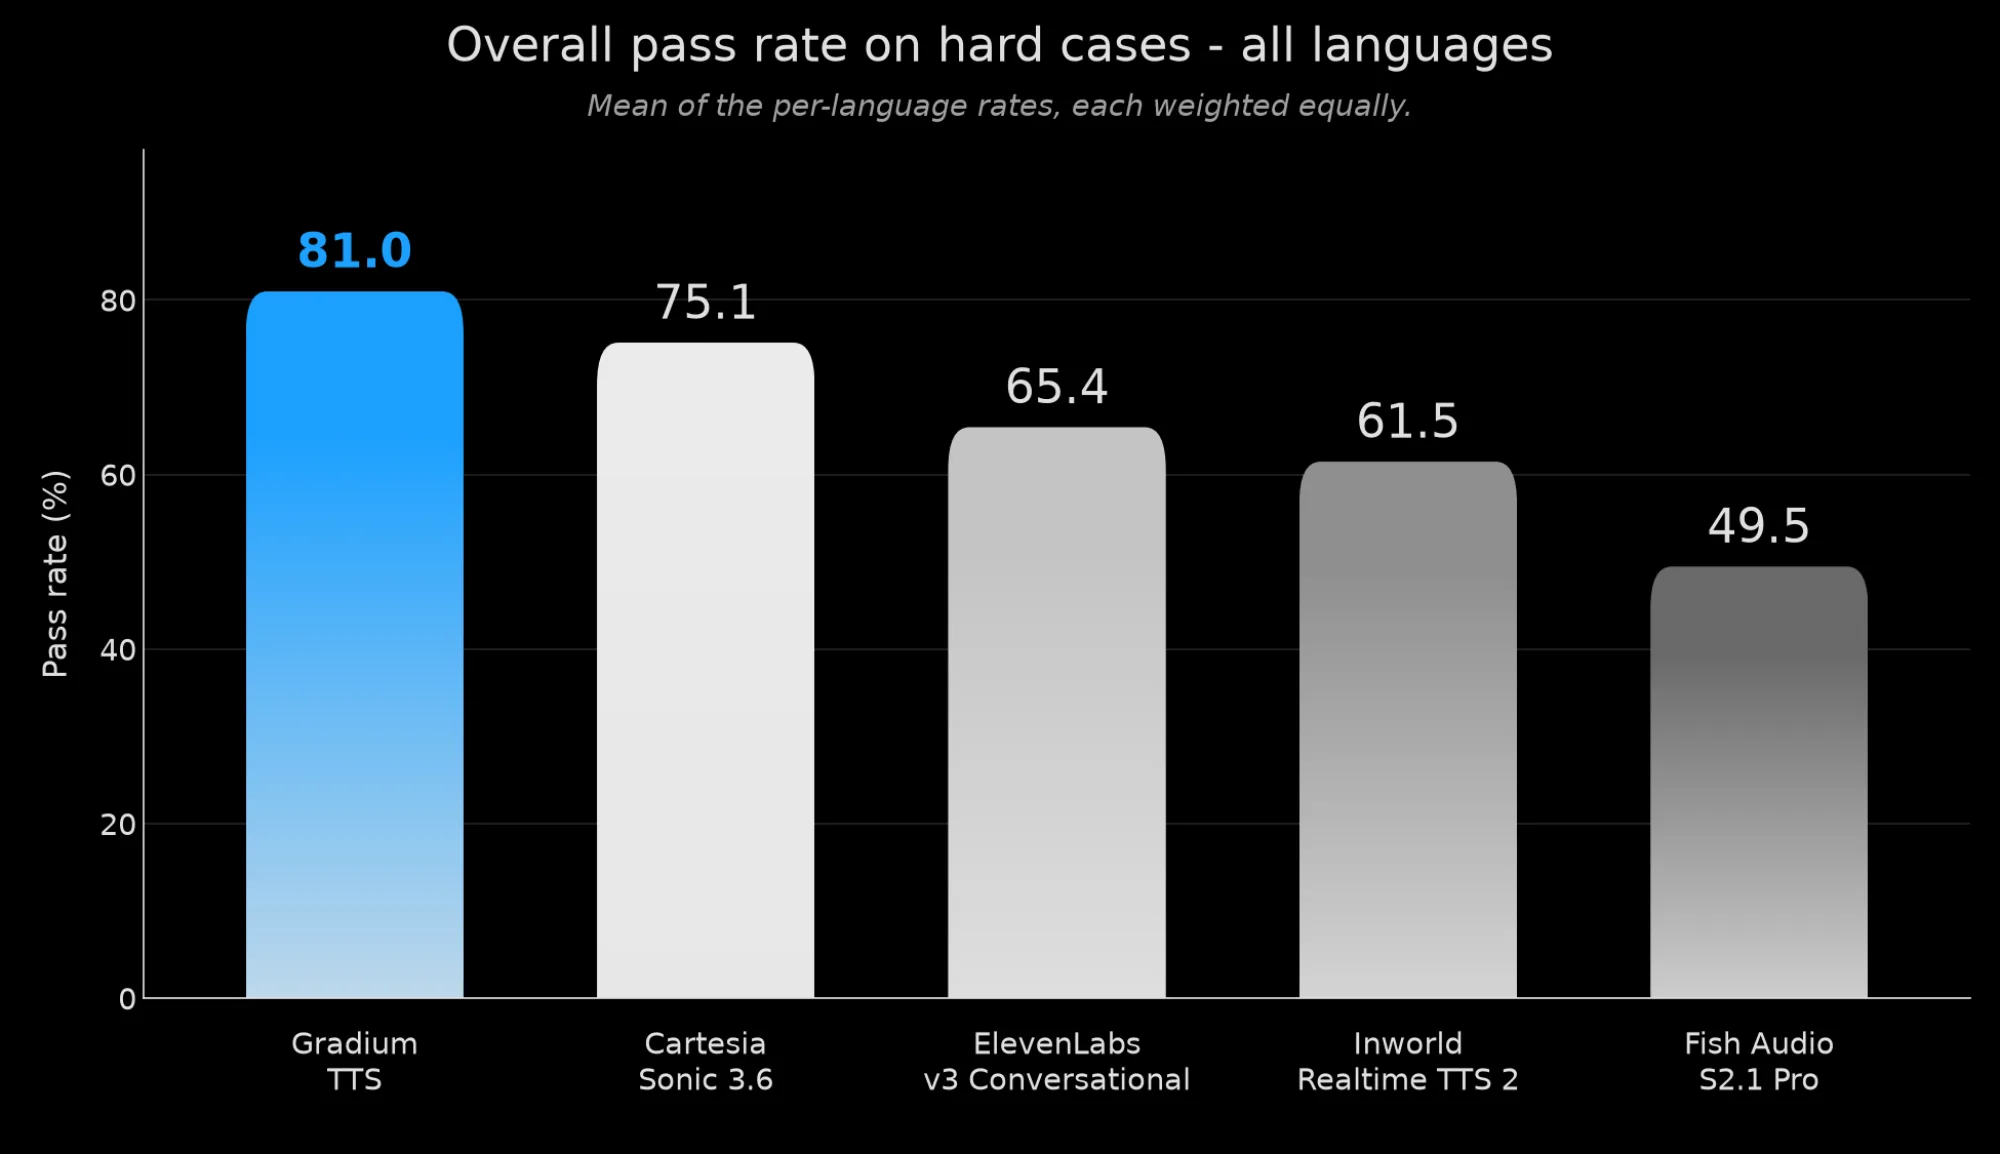
9月1日消息,法国语音初创公司 Gradium 于8月31日上线新一代 TTS 模型,并在 API 与 Studio 中直接设为默认。新模型无需文本预处理,即可正确朗读电话号码、订单号、邮箱、银行账号这类结构化实体,现有音色包括自定义克隆音
2026年09月01日
47
Cartesia 发布 Sonic-3.6:44 种语言、延迟低于 90 毫秒,登顶 Artificial Analysis 语音双榜
8月28日消息,实时语音公司 Cartesia 发布新一代文本转语音模型 Sonic-3.6。距上一代 Sonic-3.5 发布约两个月,新模型支持 44 种语言,回应延迟降至 90 毫秒以内,并同时登顶 Artificial Analys
2026年08月28日
36
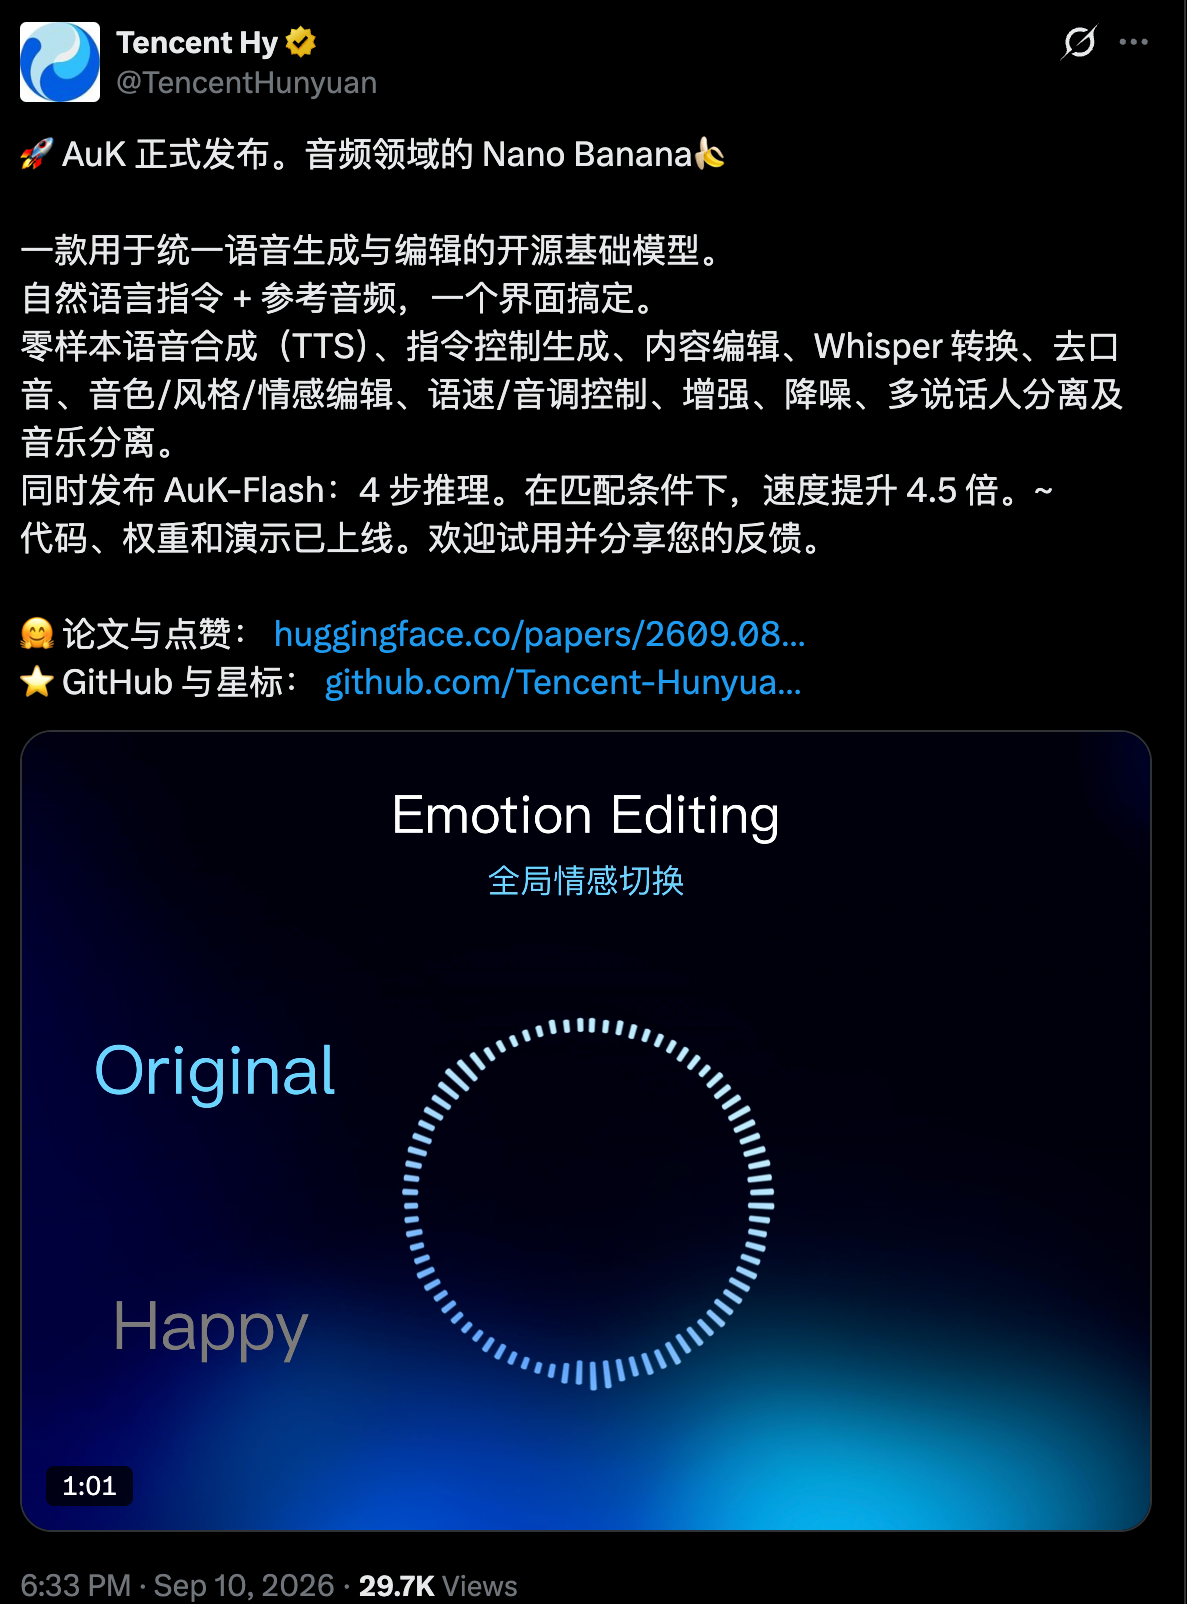
AuK 是什么:腾讯混元开源的 1.5B 语音模型
腾讯混元 9 月 9 日开源 AuK,一个 1.5B 的语音生成与编辑基础模型,权重与代码同步放出,MIT 许可,可商用。 它把零样本 TTS、内容编辑、音高语速音量调整、情绪音色口音修改、降噪去混响、人声与音乐分离等 16 类任务收进同
2026年09月11日
116
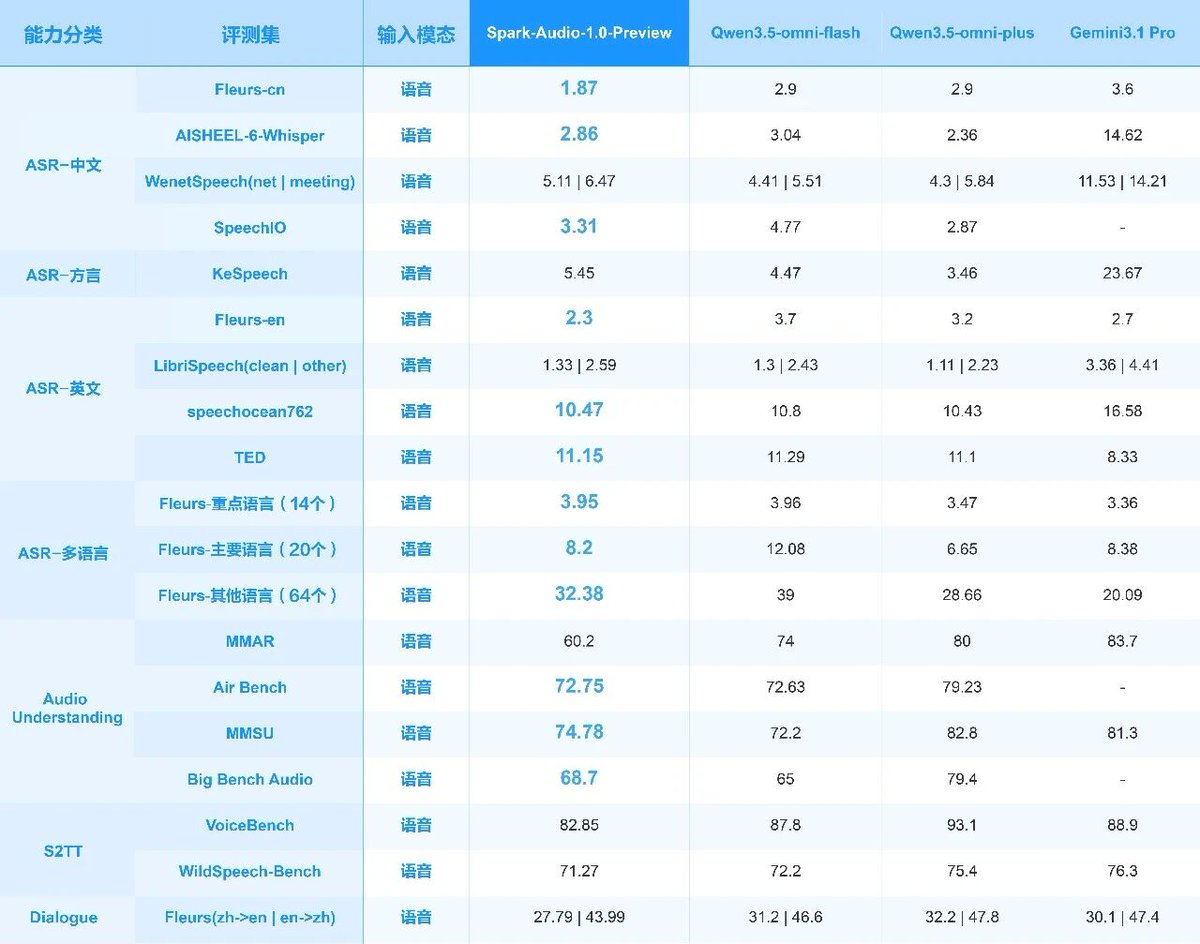
科大讯飞上线 Spark-Audio-1.0-Preview:纯国产算力训练的语音基座大模型
9月16日消息,科大讯飞上线语音基座大模型 Spark-Audio-1.0-Preview。模型采用 0.65B 稠密(Dense)结构的音频编码器,搭配 30B-A3B 混合专家(MoE)结构的大语言模型,训练数据为 1300 万小时音频
2026年09月16日
61
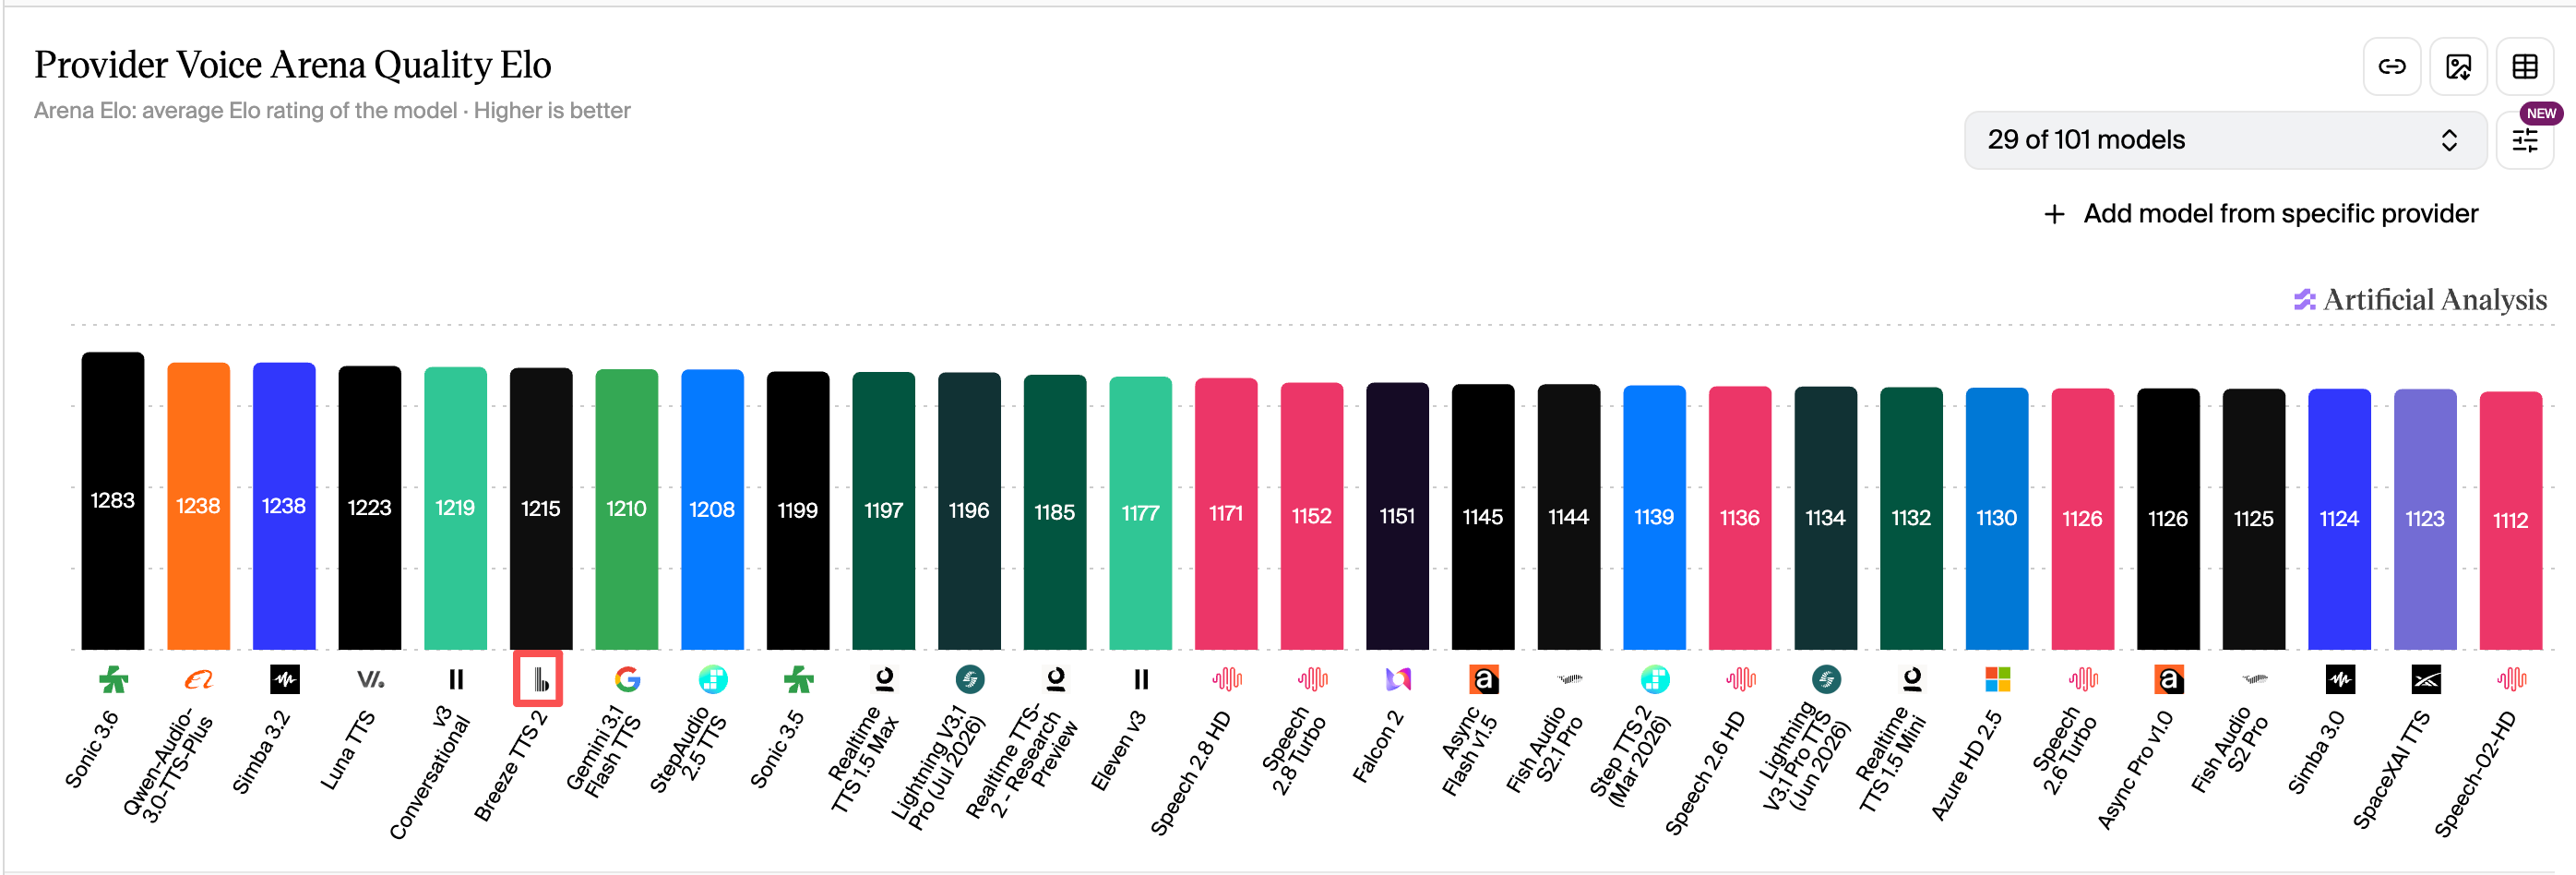
前 MiniMax 技术合伙人杨斌创立 BreezeBlue:获 600 万美元种子轮,语音模型进入全球榜前十
8月25日消息,据智能涌现首发报道,前 MiniMax 技术合伙人杨斌创立的语音模型公司 BreezeBlue 已完成 600 万美元种子轮融资,由元璟资本、红点中国联合领投。该公司自研的语音生成模型 Breeze TTS 2 目前在第三方
2026年08月25日
109
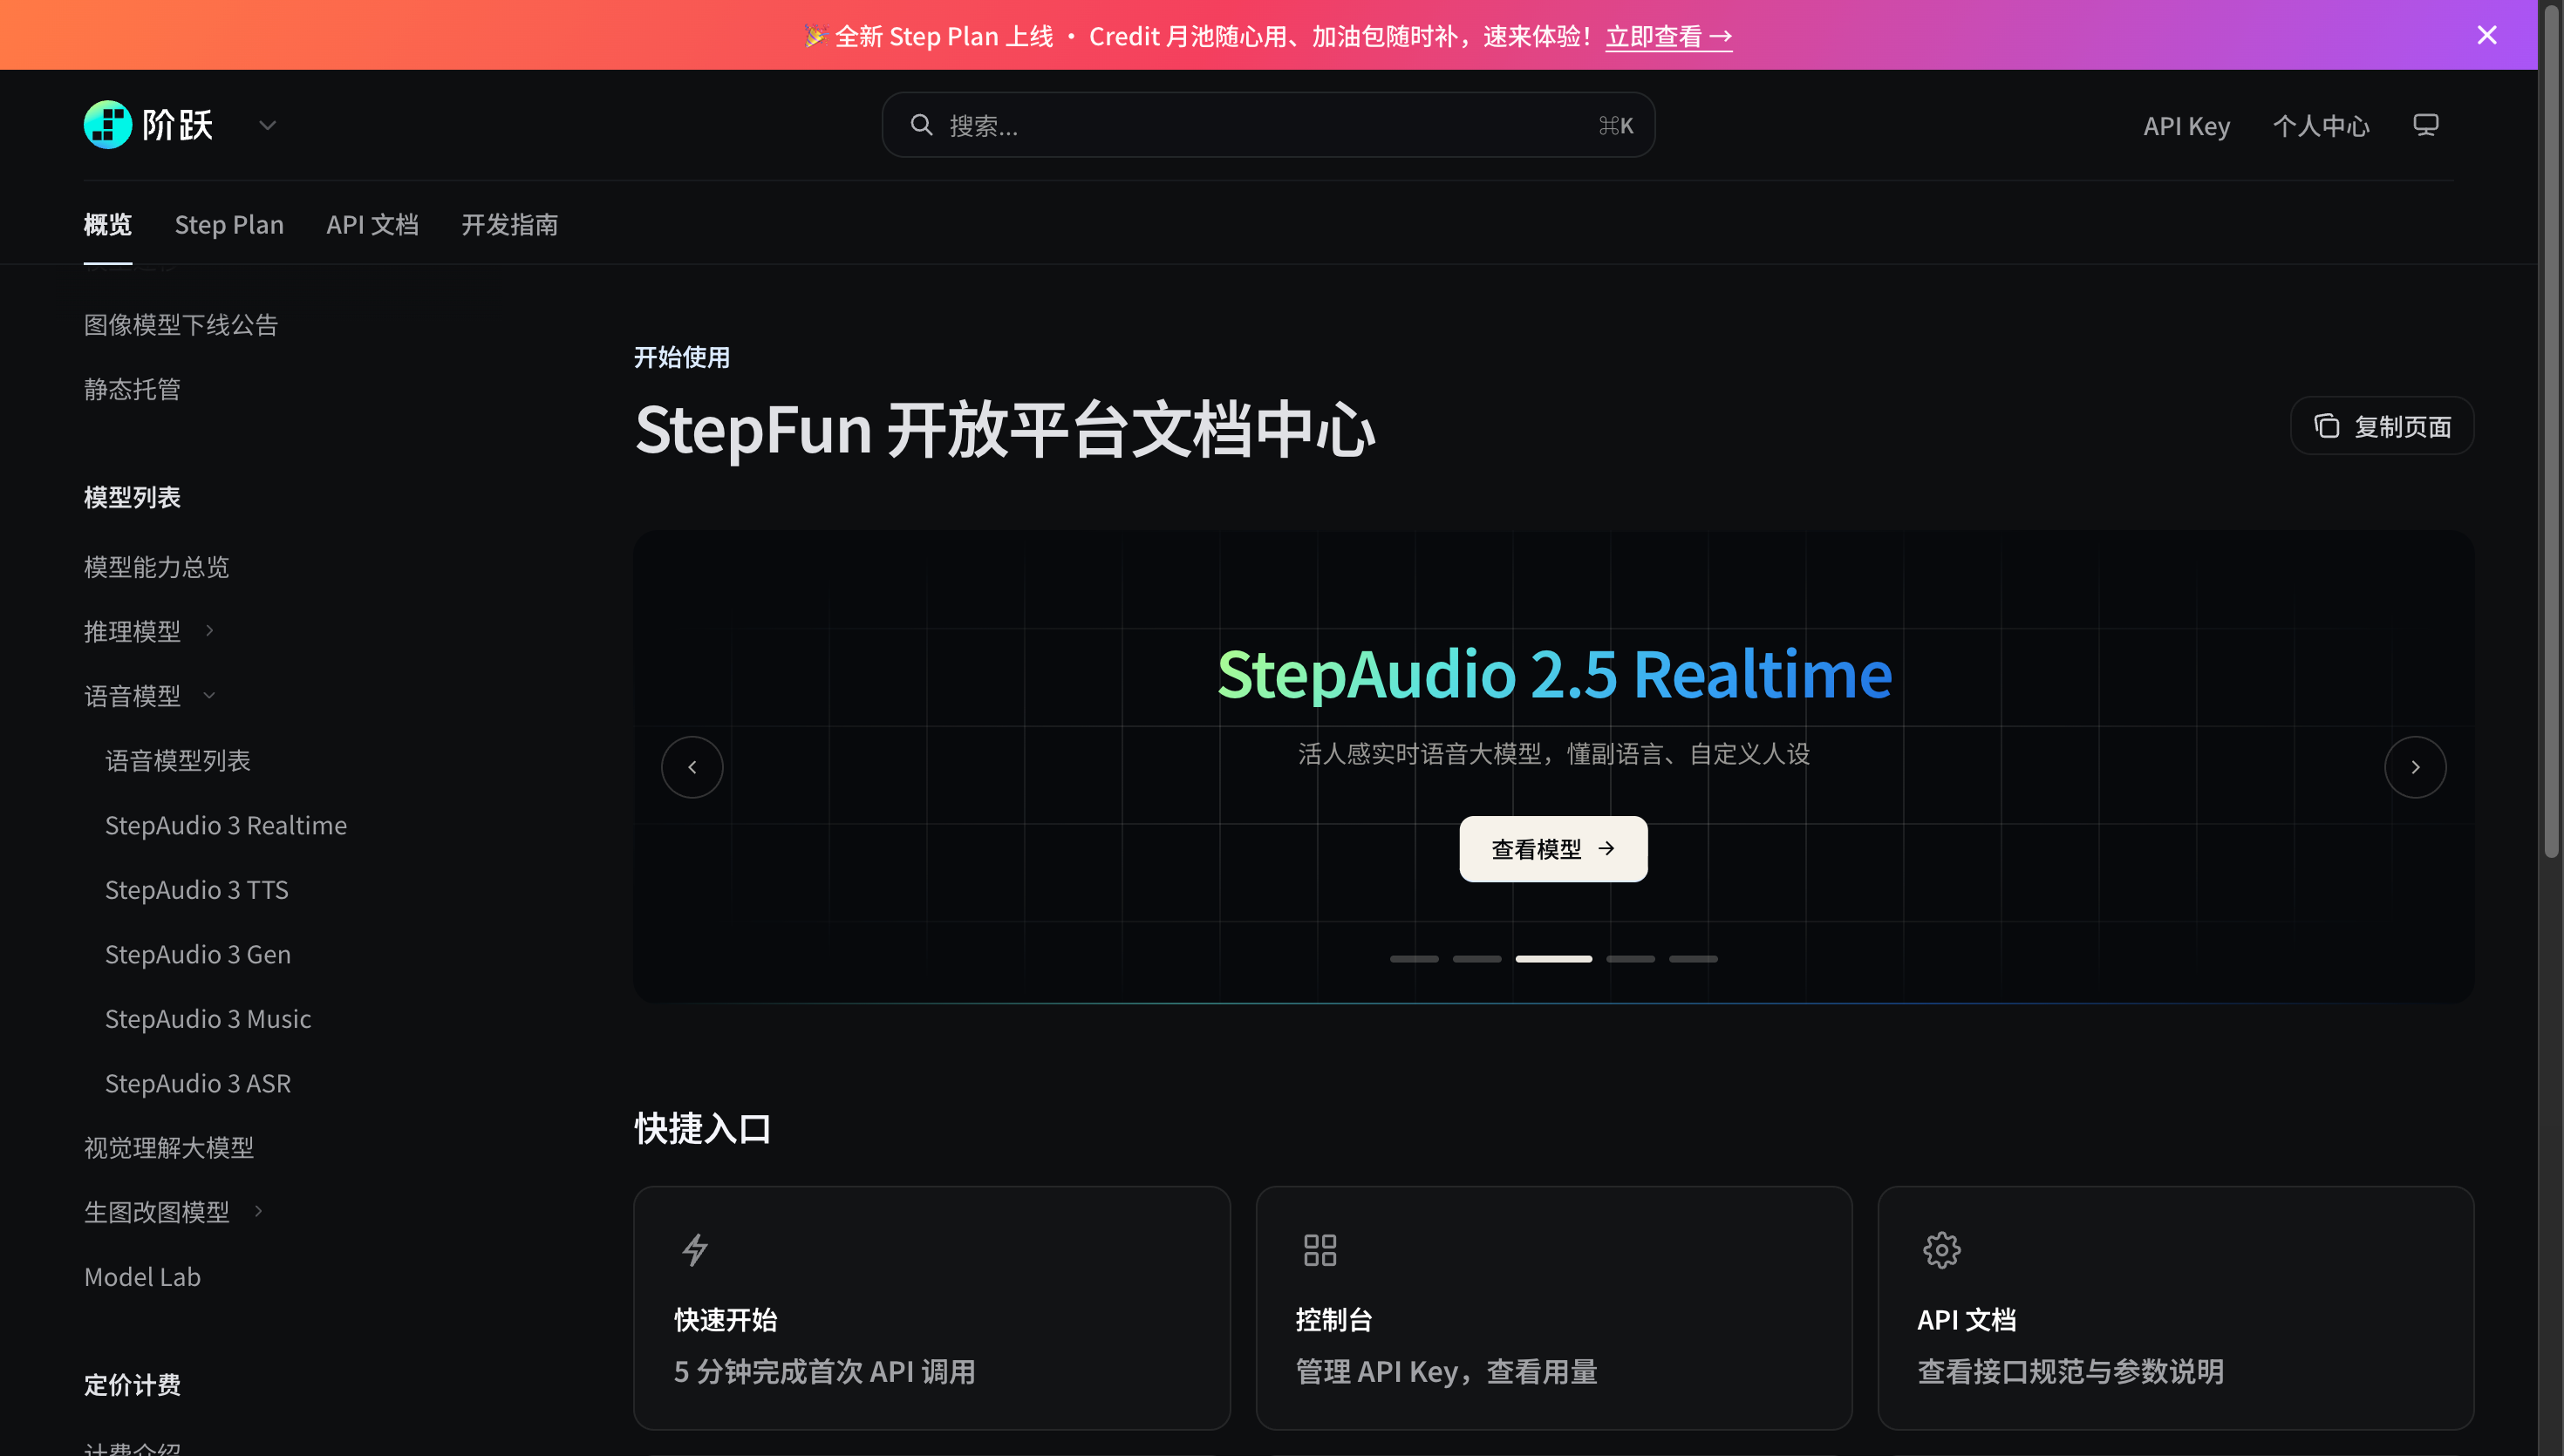
阶跃星辰上线 StepAudio 3 语音模型系列:从实时对话到音乐生成共五款
9月15日消息,阶跃星辰在开放平台上线新一代语音模型 StepAudio 3 系列,官方文档中心已列出五款:Realtime、ASR、TTS、Gen 与 Music,分别覆盖实时语音对话、语音识别、语音合成、综合音频生成与音乐生成。TTS
2026年09月15日
41
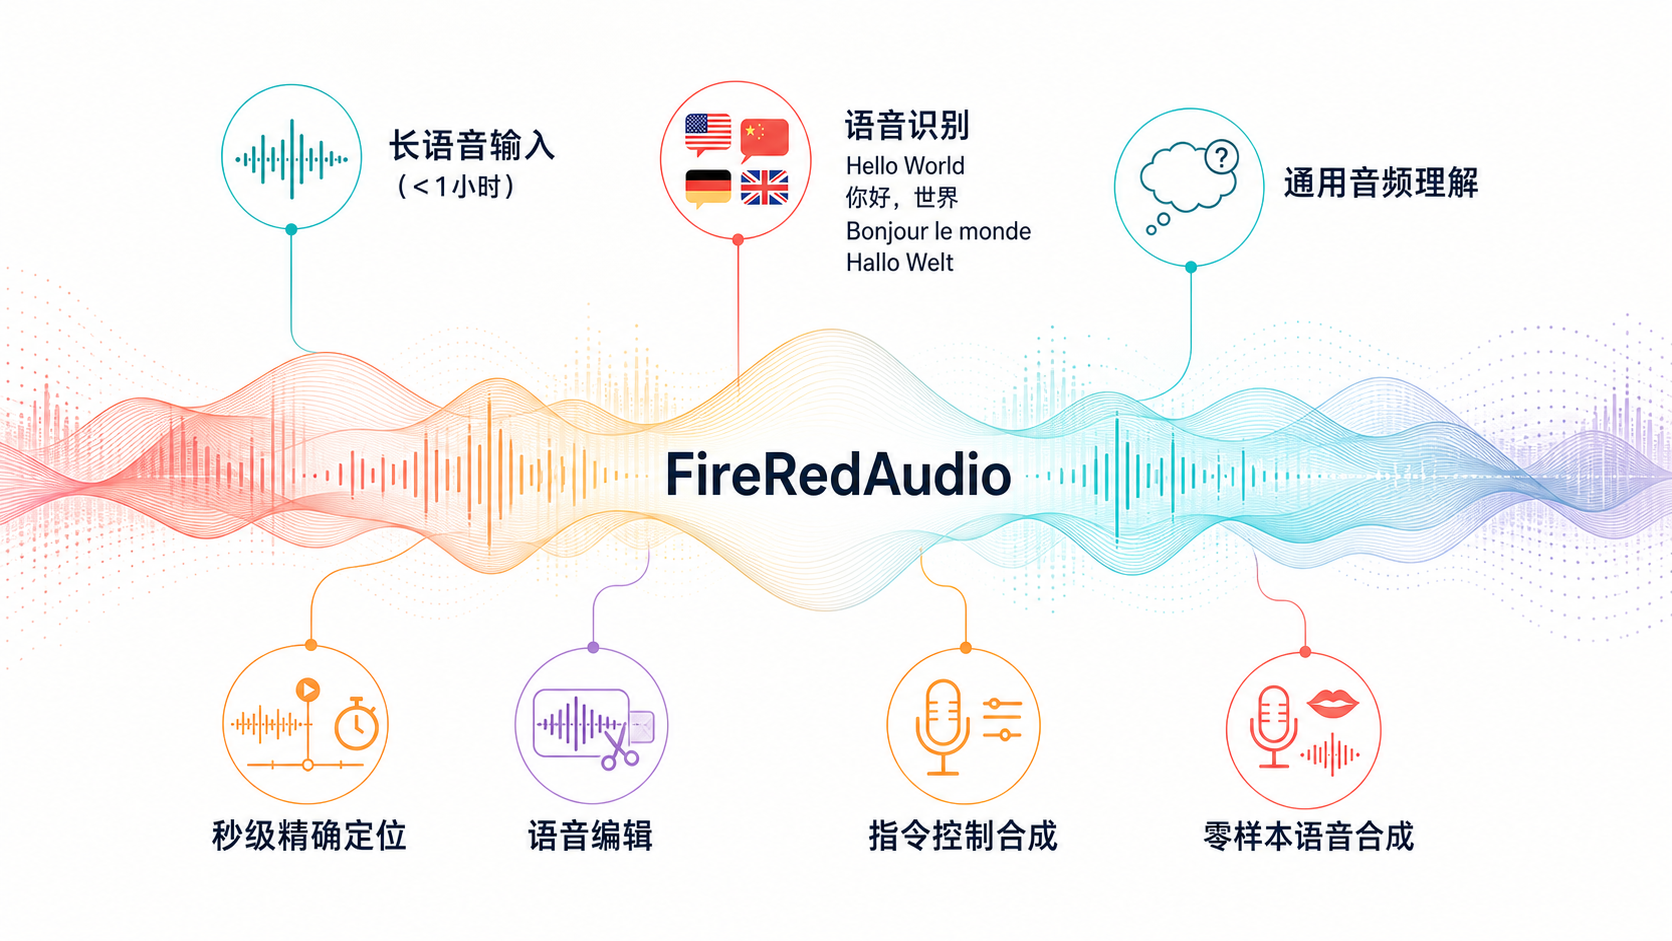
小红书 FireRed 团队开源 FireRedAudio:9B 单模型打通 ASR、音频理解、TTS 与语音编辑
8月27日消息,小红书 FireRed 团队上周开源了统一音频模型 FireRedAudio,代码与模型权重以 Apache-2.0 协议发布在 GitHub 和 Hugging Face。这个基于 Qwen3.5 的 9B 模型用同一个语
2026年08月27日
78
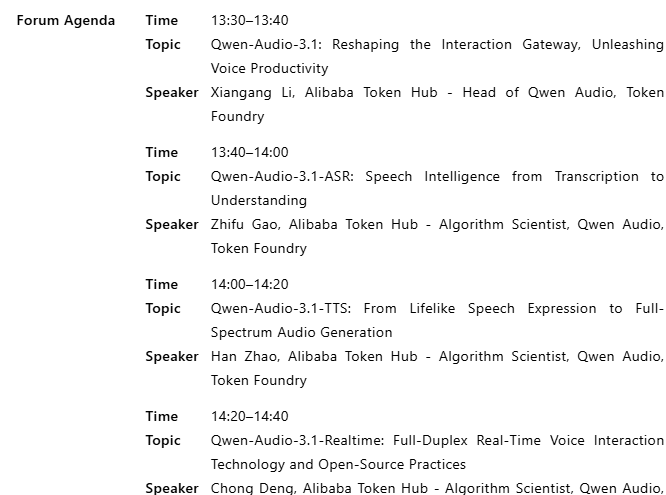
阿里 Token Hub 云栖议程曝光:将预览 Happy Oyster 2.0,讲解 Qwen-Image-3.1 与 Qwen-Audio-3.1 系列
9月20日消息,2026 云栖大会定于9月22日至24日在杭州举办。开幕前披露的分论坛议程显示,阿里巴巴 Token Hub 相关分论坛安排了 7 场分享。产品线覆盖世界模型、图像生成、语音三条线。议程写明将发布 Happy Oyster
2026年09月20日
53
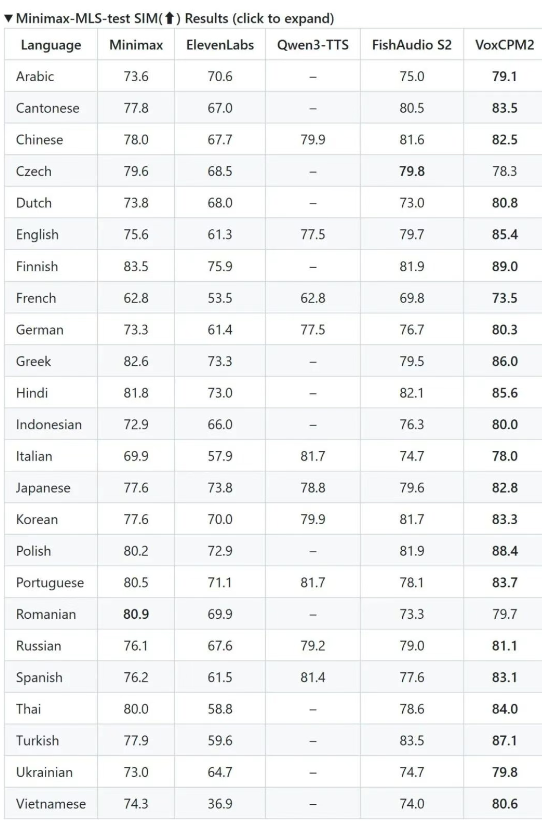
VoxCPM 2 开源 TTS 模型实测总结:24 项测试夺 21 冠,开源吊打闭源
4月9日,面壁智能×OpenBMB×清华大学联合发布VoxCPM 2开源TTS模型,在MiniMax-Eval 24种语言评测中拿下21项第一,实现音色复刻、原创音色、多语种方言、高情感表现力四大突破,消费级显卡可本地运行,综合实力不输甚至
2026年04月09日
339
用户评分
3.59
27人点评
我要评分